经管之家送您一份
应届毕业生专属福利!
 求职就业群
感谢您参与论坛问题回答
经管之家送您两个论坛币!
+2 论坛币
最近一年,科研圈最火的话题,不是某一种新的计量方法,而是AI智能体。 Claude Code、Codex、Trae…… 越来越多的科研人开始让AI写代码、调试程序、分析数据,甚至辅助完成论文初稿。 不少老师和同学也开始问我们同一个问题: AI都能写Stata代码了,我们还有必要学Stata吗? 答案可能与你想的不一样。 AI时代,不是Stata不重要了,而是真正懂Stata的人,效率被放大了。 AI可以帮你生成代码,但不会替你判断模型是否合理; AI可以帮你解释命令,但不会告诉你识别策略是否站得住脚; AI可以帮你润色论文,却不能替你完成真正有价值的学术研究。 真正决定论文质量的,从来不是"会不会输入命令",而是你是否真正理解数据、理解方法、理解研究设计。 所以,当AI成为科研助手之后,真正拉开差距的,不再是谁会不会用AI,而是谁拥有扎实的科研基本功。 为什么很多人用了AI,科研效率反而没有提高? 我们接触过很多老师和研究生,发现大家的问题其实非常一致。 有人刚装好Stata,却连数据导入和路径设置都不会; 有人已经能完成OLS、固定效应,却一遇到工具变量、多期DID、RDD就不知道如何继续; 有人论文结果已经跑出来,却不知道如何构建研究故事、回应审稿意见; 还有不少人虽然每天都在使用AI,却发现自己花了大量时间调Prompt,最后生成的代码依旧无法直接应用。 问题并不是AI不好,而是科研能力存在断层。 软件不会、方法不熟、论文不会写,再先进的AI也只能停留在"辅助工具"。 真正高效的科研,应该是一条完整的能力链条: 数据处理 → 模型分析 → 因果识别 → AI科研工作流 → 论文写作 → 投稿发表,缺少任何一个环节,都很难真正提升科研水平。
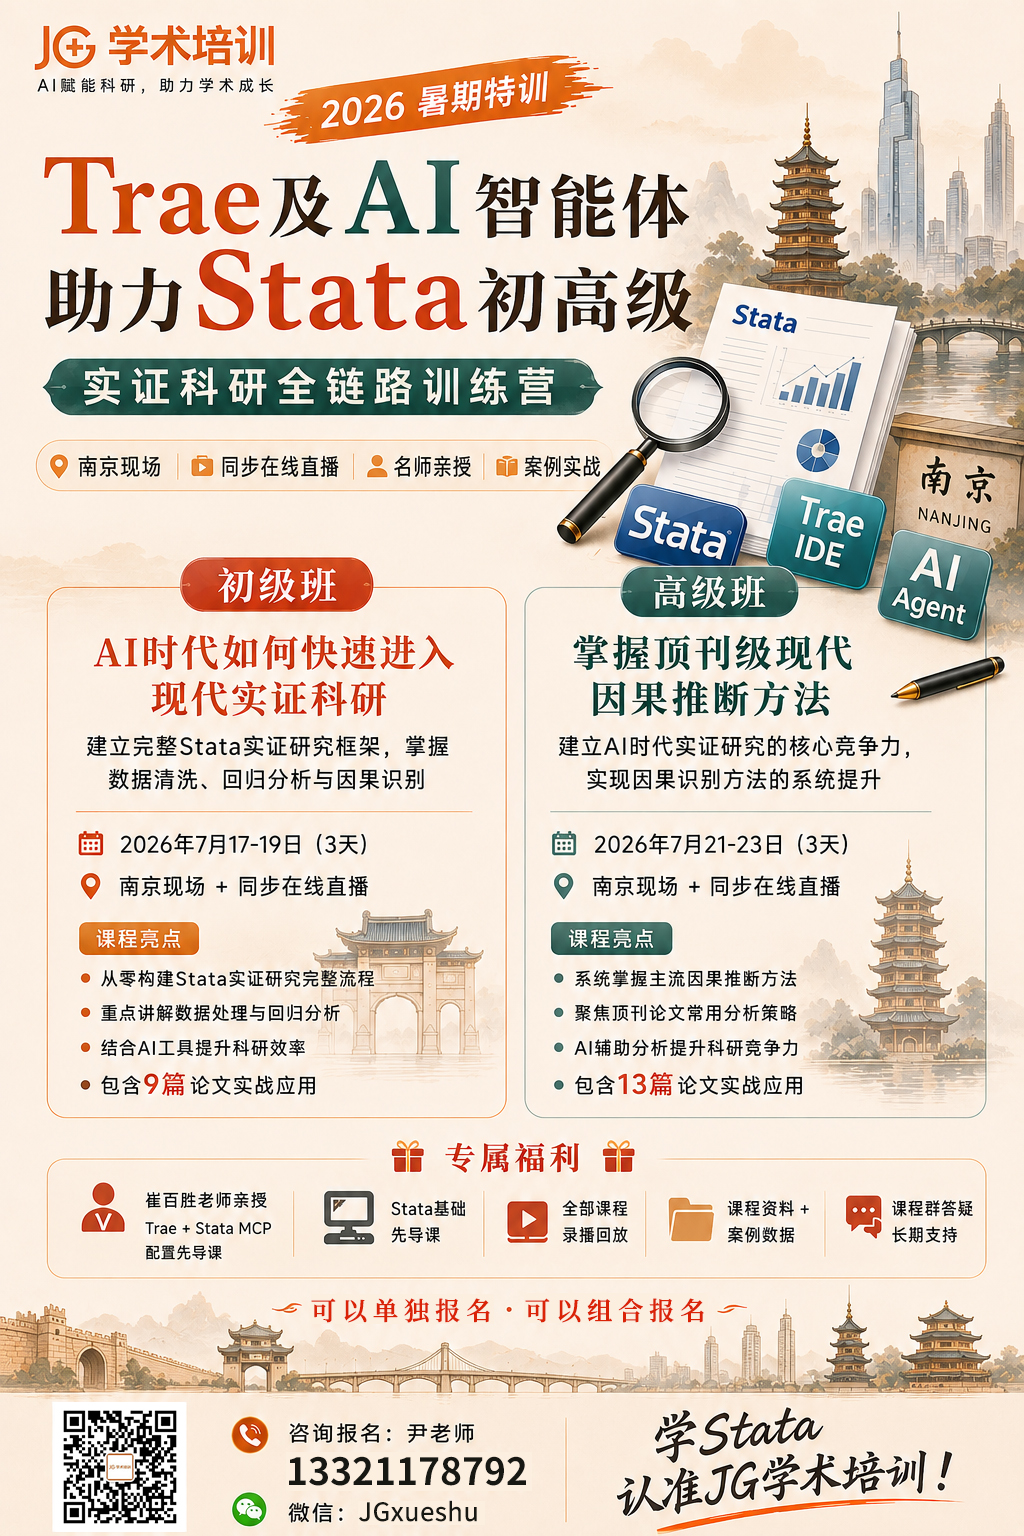
AI时代,真正需要学习的是"AI增强版Stata科研工作流" 过去,我们学习Stata,大多数时候只是学习软件本身。 今天,我们更希望帮助大家建立一套完整的科研工作流,你可以借助AI智能体: ✅ 自动生成Stata代码框架 ✅ 快速定位报错原因 ✅ 自动完成大量重复性数据处理 ✅ 辅助完成稳健性检验 ✅ 自动整理结果输出 ✅ 辅助生成结果解释 但请注意:AI负责提高效率,研究者负责做出判断。 真正重要的研究问题、识别策略、理论逻辑和学术创新,依然需要研究者自己完成。 因此,我们今年暑期并没有简单增加几节AI课程,而是重新设计了一整套课程体系,把AI真正融入Stata科研全过程。 第一阶段:Stata初级 + AI科研工作流
时间:2026年7月17-19日三天 | 地点:南京现场/同步在线直播 讲师:崔百胜老师(多本实证计量教材畅销作者,Stata金牌讲师) 很多人以为Stata初级就是教软件,其实恰恰相反,真正决定后续科研效率的,往往是最基础的数据处理能力。
核心内容速览(包含9篇论文应用解析): 第1讲:AI时代的实证科研工作流 - Trae IDE配置与Stata do文件开发环境搭建
- 用Trae的Agent模式自动生成do文件框架、解释命令
第2讲:数据清洗、面板数据构建与论文级可视化 - Wind数据→面板数据、CFPS微观数据清洗实战
- 构建数据预处理Agent,自动识别异常、标准化变量
- 论文级绘图:binscatter、事件研究图、分仓回归图
第3讲:AI时代的编程思维与自动化科研 - 看懂AI生成的代码,学会Prompt设计
- ado文件开发实战:从0到1发布一个外部命令
第4讲:线性回归、内生性与工具变量 - AI智能体诊断内生性,自动推荐IV/DID/RDD
- IV、2SLS、GMM估计与弱工具变量检验
第5讲:中介效应、调节效应与机制分析 - AI Agent自动化中介效应检验(逐步法、Bootstrap、sgmediation2)
- 自动生成检验报告
第6讲:静态面板与双重差分法 - AI Agent辅助DID设计全流程:自动判断DID类型、执行平行趋势检验、安慰剂检验
- 标准DID/多期DID/三重差分的7种估计方法
你将掌握: - Trae与AI智能体科研环境搭建
- Wind、CFPS等常见数据库处理
- 数据清洗与变量构建
- 面板数据处理
- 基准回归分析
- 中介效应、调节效应分析
- DID基础应用
- AI辅助Stata开发与自动化工作流
完成这一阶段后,你能够独立完成一篇实证论文的大部分基础分析工作。
第二阶段:Stata高级 + 前沿因果推断+ AI科研工作流
时间:2026年7月21-23日三天 | 南京现场/同步在线直播 讲师:崔百胜老师(多本实证计量教材畅销作者,Stata金牌讲师) 如果说初级解决的是“会不会做”,那么高级解决的是:做得对不对,能不能发表。 许多论文被拒稿,并不是软件不会用,而是研究设计不过关。
核心内容速览(包含13篇论文应用解析): 第7讲:长面板与动态面板 - 偏差校正LSDV、差分与系统GMM
- 面板工具变量高维固定效应
第8讲:非平稳、门槛与PVAR - 面板单位根、门槛模型、PVAR和XTVAR
- 具有共同相关因子的动态面板
第9讲:因变量受限的面板模型 - 面板Logit/Probit/Tobit、计数模型、多项选择模型
第10讲:异质性DID模型(重点!) - csdid、did_imputation、stackedev、xthdidregress
- 负权重诊断、Bacon分解、异质性DID智能选择Agent
第11讲:断点回归与合成控制 - 精确/模糊/多断点回归、聚束效应
- 合成控制法、合成双重差分
- AI Agent辅助RD完整设计
第12讲:机器学习因果推断 - h2oml(随机森林、梯度提升)、Lasso/Ridge/Elastic Net
- ivlasso、pdslasso、dslasso
- AI Agent自动化Lasso因果推断
第13讲:AI智能体驱动的完整实证研究流程 Trae环境搭建 → 数据智能体自动清洗 → 模型智能体自动识别方法 → 编程智能体自动生成代码 → 稳健性智能体自动检验 → 写作智能体自动生成结果解读
你将掌握: - 动态面板模型
- 高维固定效应
- 多期DID
- 异质性处理效应
- 断点回归(RDD)
- 合成控制法
- 机器学习因果推断
- AI辅助模型选择与稳健性分析
不仅告诉你如何运行模型,更重要的是帮助你理解: 为什么选择这种方法?什么时候不能使用?审稿人最容易质疑什么?
第三阶段:Stata论文特训及AI助力——从会做研究到写出论文
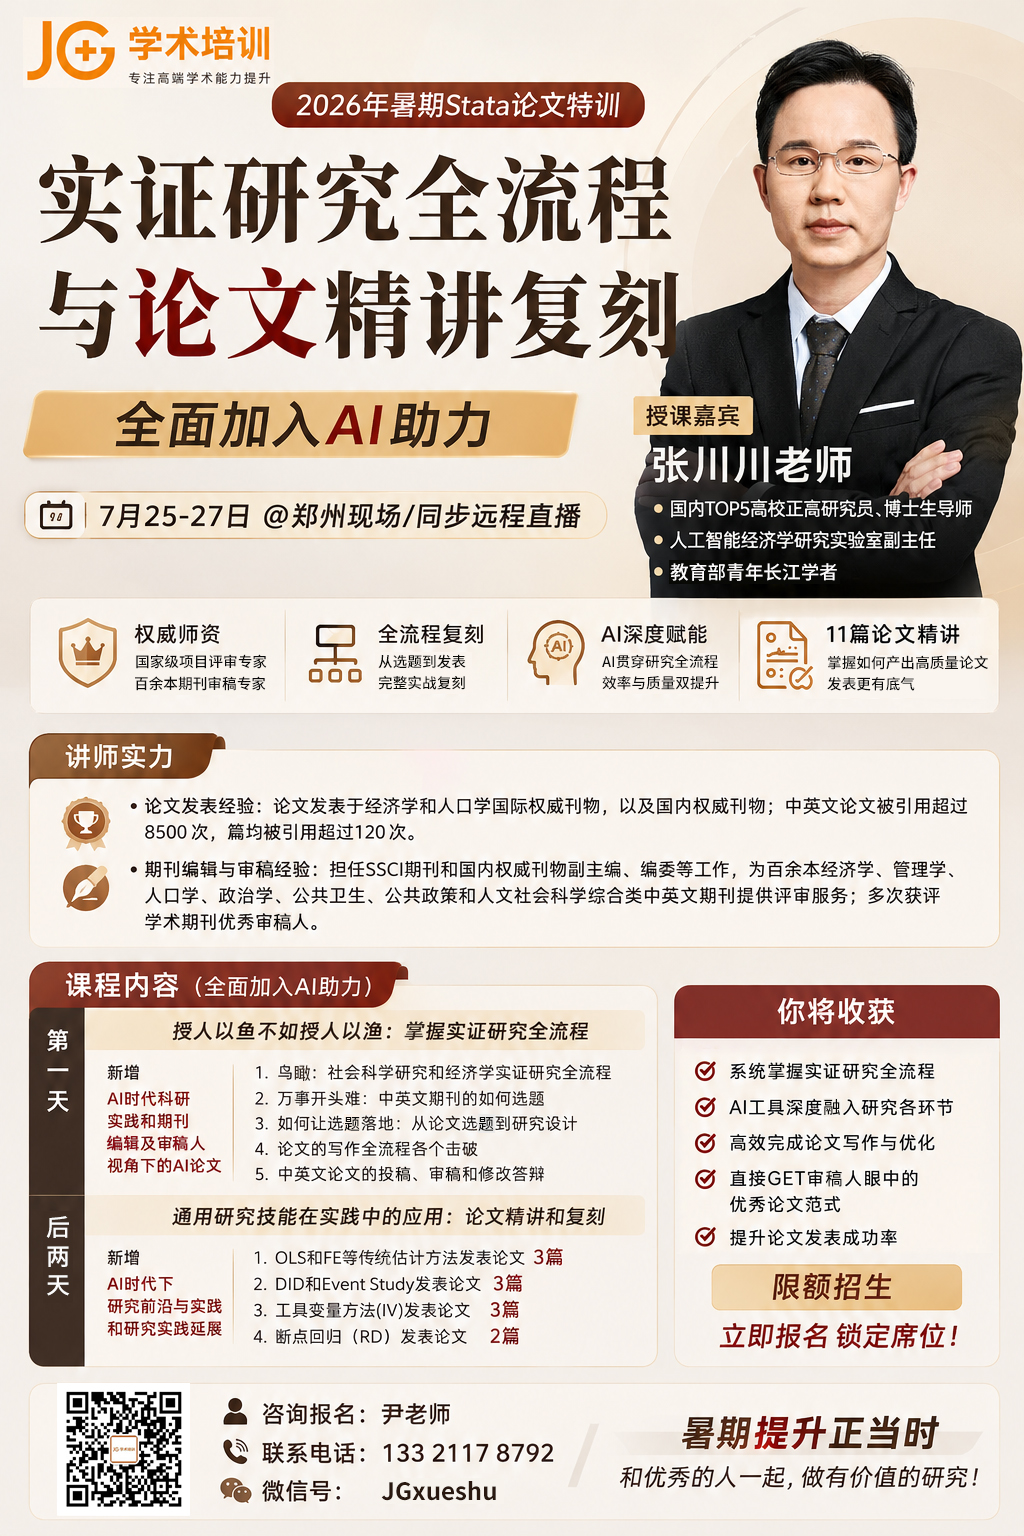
时间:2026年7月25-27日三天 | 地点:郑州现场/同步在线直播 讲师:张川川(研究员、博导,百余本期刊审稿专家,顶刊发表70余篇) 这是很多人最缺的一环。 现实情况是:会Stata的人很多,会发表论文的人并不多。 原因就在于:软件能力≠研究能力,模型能力≠论文能力。 因此我们特别设置了Stata论文特训课程。课程不再局限于软件操作,而是直接进入:一篇实证论文到底如何产生?包括:如何选题,如何设计研究,如何组织实证分析,如何提高发表概率。
核心内容速览(包含11篇中英文论文精讲复刻): 第一天:授人以渔——掌握高水平实证研究的底层逻辑 - 鸟瞰实证研究全流程
- 从研究问题到因果识别的完整链路
- 高水平研究与"技术正确"的区别
- AI时代:什么可以交给AI,什么必须保留研究者的学术判断
- 如何找到真正有价值的题目
- 选题从哪里来?什么是好选题?
- 利用AI梳理文献脉络,识别"伪热点"
- AI时代更重要的:研究直觉、问题意识与学术品味
- 从选题到研究设计
- 从现象到理论、从理论到实证
- 系统性预判审稿人质疑
- 构建更有说服力的识别策略
- 论文写作核心逻辑
- 学术论文写作的底层原则
- AI辅助梳理论文逻辑与叙事结构
- 如何保持自己的学术声音
- 投稿、审稿与修改
- CSSCI & SSCI投稿经验
- 如何回应审稿意见而不是"反驳审稿人"
- 顶刊对AI使用的规范与趋势
后两天:顶刊论文精讲与复刻 1. OLS& 面板FE(张川川 J Pop Econ 2019, J Comp Econ 2020; 《管理世界》2025):多源数据整合、基础方法提升可信度 2. DID& Event Study(AEJ:Applied 2021, JDE 2022, JEBO 2024):多期DID、异质性处理效应、准自然实验识别 3. 工具变量IV(《经济研究》2015,《中国社会科学》2016):好IV的研究直觉、排他性约束论证 4. 断点回归RD(《经济研究》2014, QJE 2004):现实断点识别、RKD拓展
你将掌握: - 如何寻找真正有价值的研究问题
- 如何设计研究框架
- 如何建立具有说服力的识别策略
- 如何组织论文逻辑
- 如何回应审稿意见
- 如何提高论文发表成功率
同时结合大量中英文顶刊论文进行完整复刻,让大家真正理解高水平论文背后的研究逻辑。 三门课程,不是三次学习,而是一条科研成长路线 整个成长路径可以概括为: 软件操作 → 数据处理 → 回归分析 → 因果识别 → AI科研工作流 → 论文复刻 → 论文发表 这也是我们今年课程最大的升级:不是教几个命令,不是教几个模型,更不是简单讲AI工具,而是帮助大家建立一套能够长期使用的科研能力体系。
课程好不好,学员说的算!感谢以下高校对JG学术培训的信任和支持❤
如果您正面临: - 不知道如何开始实证研究;
- Stata一直学不会;
- 论文迟迟发不出来;
- 想系统掌握因果推断;
- 希望利用AI提升科研效率;
那么这个暑期,正是一次系统补齐科研能力短板的机会。 AI正在改变科研,但真正被改变的,不是科研本身,而是科研人的工作方式。 未来,优秀的科研人,不一定是写代码最快的人。 而一定是最懂研究、最懂方法、同时最会利用AI的人。 如果你希望利用这个暑期,系统完成从软件操作、因果推断,到论文写作与发表的能力升级,那么现在,就是最好的开始。
为什么建议利用暑期完成这次升级? 1. 时间窗口完美 暑期没有教学任务,是唯一可以集中沉浸式学习的时间。9月开学后,杂事缠身,再想系统学习难上加难。 2. 三种学习方式,总有一种适合你 - 现场班:南京/郑州,面对面答疑,氛围感拉满
- 远程直播:同步参与,实时互动,省去差旅
- 录播回放:开通时间灵活,随时复习,不怕遗漏
3. 从0到1,一次打通 不是零散的知识点,而是"初级工具→高级方法→论文发表"的完整闭环。学完就能用,用完就能发。 4. AI深度嵌入,不是噱头 不是简单演示ChatGPT,而是系统讲授Trae IDE + Stata Agent的科研工作流: - 自动生成do文件框架
- 自动诊断内生性、推荐方法
- 自动执行稳健性检验
- 自动生成结果解读文字
让你从繁杂的技术细节中解放出来,专注于研究设计本身。 5. 顶刊例文,实战导向 所有方法均配备2020-2025年《中国工业经济》《数量经济技术经济研究》《AER》《AEJ》《JDE》等顶刊例文,代码、数据、讲义全提供。
课程提供: ✅ 完整do文档、讲义、数据及范例论文 ✅ 发票、开课通知及结业证书 ✅ 现场+远程+录播三重保障 ✅ 答疑交流环节全部由授课老师本人进行
立即咨询报名:尹老师 电话:13321178792 WeChat:JGxueshu 
主办单位:经管之家官方学术培训 
名师精品学术培训,认准经管之家JG学术培训 官方出品,名师授课,实战为王,助力你的科研之路一路开挂!
![二维码]()
扫码加我 拉你入群
请注明:姓名-公司-职位
以便审核进群资格,未注明则拒绝
| 


 发帖
 10 个论坛币


 雷达卡







 京公网安备 11010802022788号






