经管之家送您一份
应届毕业生专属福利!
 求职就业群
感谢您参与论坛问题回答
经管之家送您两个论坛币!
+2 论坛币
一个真实的研究场景 你正在准备一篇关于上市公司ESG信息披露的论文。需要采集A股近五年所有制造业企业的年报,提取"环境责任""社会责任""公司治理"等关键词的出现频次和语境,再与财务绩效做回归分析。 理论上,这是一个非常标准的文本分析研究。但实际操作中: - 年报散落在巨潮资讯网、上交所、深交所,逐份下载需要几周
- 下载后的PDF格式各异,文本提取和清洗占去整个项目60%以上的时间
- 好不容易处理完数据,发现Python代码在另一台电脑上跑不通,可复现性成问题
- 更棘手的是,当你终于搞定这批数据,研究问题已经需要扩展到"管理层讨论与分析"(MD&A)的语调分析——又要从零开始写一套代码
这不是能力问题,而是工具与方法的代际差。
为什么传统的"学Python→写爬虫→做文本分析"路径,越来越不适合经管社科研究者? 过去十年,经管社科的实证研究经历了从"结构化数据"到"非结构化文本"的范式转移。政策文本、公司公告、社交媒体、新闻舆情……这些曾经难以量化分析的数据,如今成为顶刊的常客。 但问题在于:数据采集与文本预处理的技术门槛,并没有随着研究需求的增长而降低。 一个残酷的现实是:很多研究者把80%的精力消耗在"获取数据"和"清洗文本"上,真正用于研究设计、模型构建和结果解释的时间被严重挤压。更不用提,当你终于学会了一套爬虫技术,目标网站的反爬策略已经升级;当你写好了文本清洗脚本,数据格式又变了。 我们需要的不是另一门"Python从入门到精通"的课程,而是一套"从研究问题到数据集"的完整工作流。
AI智能体带来的,不只是"代码辅助",而是"任务代理" 2026年,AI智能体(AI Agent)的出现,正在从根本上改变这个局面。 以Claude Code为代表的AI智能体,已经不再是"你写提示词,它生成代码"的简单工具。它能够: - 理解项目级上下文:读取你的整个研究文件夹,理解数据结构和研究逻辑
- 自主执行与迭代:根据自然语言描述的任务,自动分析网页、生成代码、运行调试、处理异常
- 连接外部工具:通过MCP协议直接操作浏览器、数据库、文件系统
这意味着什么? 你可以用描述研究需求的方式,让AI智能体完成从"网页分析→代码生成→数据采集→文本清洗→结构化输出"的全流程。 你不需要记住Requests的参数格式,不需要手写XPath,不需要在Stack Overflow上翻三小时解决一个编码错误。你的角色从"代码编写者"转变为"任务设计者"和"结果把关者"——这正是经管社科研究者应该聚焦的环节。
2026年,经管之家学术培训国庆班全新升级—— AI智能体赋能Python爬虫与文本分析:从代码编写到智能体协同的科研实战 10月1—4日,北京现场 + 同步在线直播 4天时间,打通从数据获取到文本分析,再到科研数据集构建的完整 Workflow

这门课想解决什么问题? 我们设计这门4天课程的核心假设是:经管社科研究者的时间,应该花在研究问题上,而不是花在调试代码上。 因此,课程的定位不是"教你Python语法",而是帮你建立一套可复用的"AI智能体+Python爬虫+文本分析"科研数据处理工作流。具体来说: 从"爬网页"升级为"构建科研数据集" 课程中的每一个案例都指向真实的学术场景:知网论文信息采集、上市公司年报文本提取、政策文件批量读取与结构化、社交媒体舆情监测。最终输出的不是一段"能跑的代码",而是一个可以直接导入Stata/R/Python做计量分析的Excel/CSV数据集。 从"文本处理"升级为"生成实证变量" 传统文本分析停留在词频统计和主题模型,结果难以直接用于回归。这门课的重点是:如何让AI智能体从非结构化文本中提取出可直接用于实证研究的结构化变量——情绪指标、风险关键词、创新词频、ESG信息披露得分、管理层语调…… 从"学习工具"升级为"掌握范式" 课程结束时,你带走的不是几个孤立的代码片段,而是一套完整的Workflow:如何用自然语言向AI智能体描述研究任务、如何设计数据采集策略、如何质检和清洗文本数据、如何将分析结果转化为论文图表。
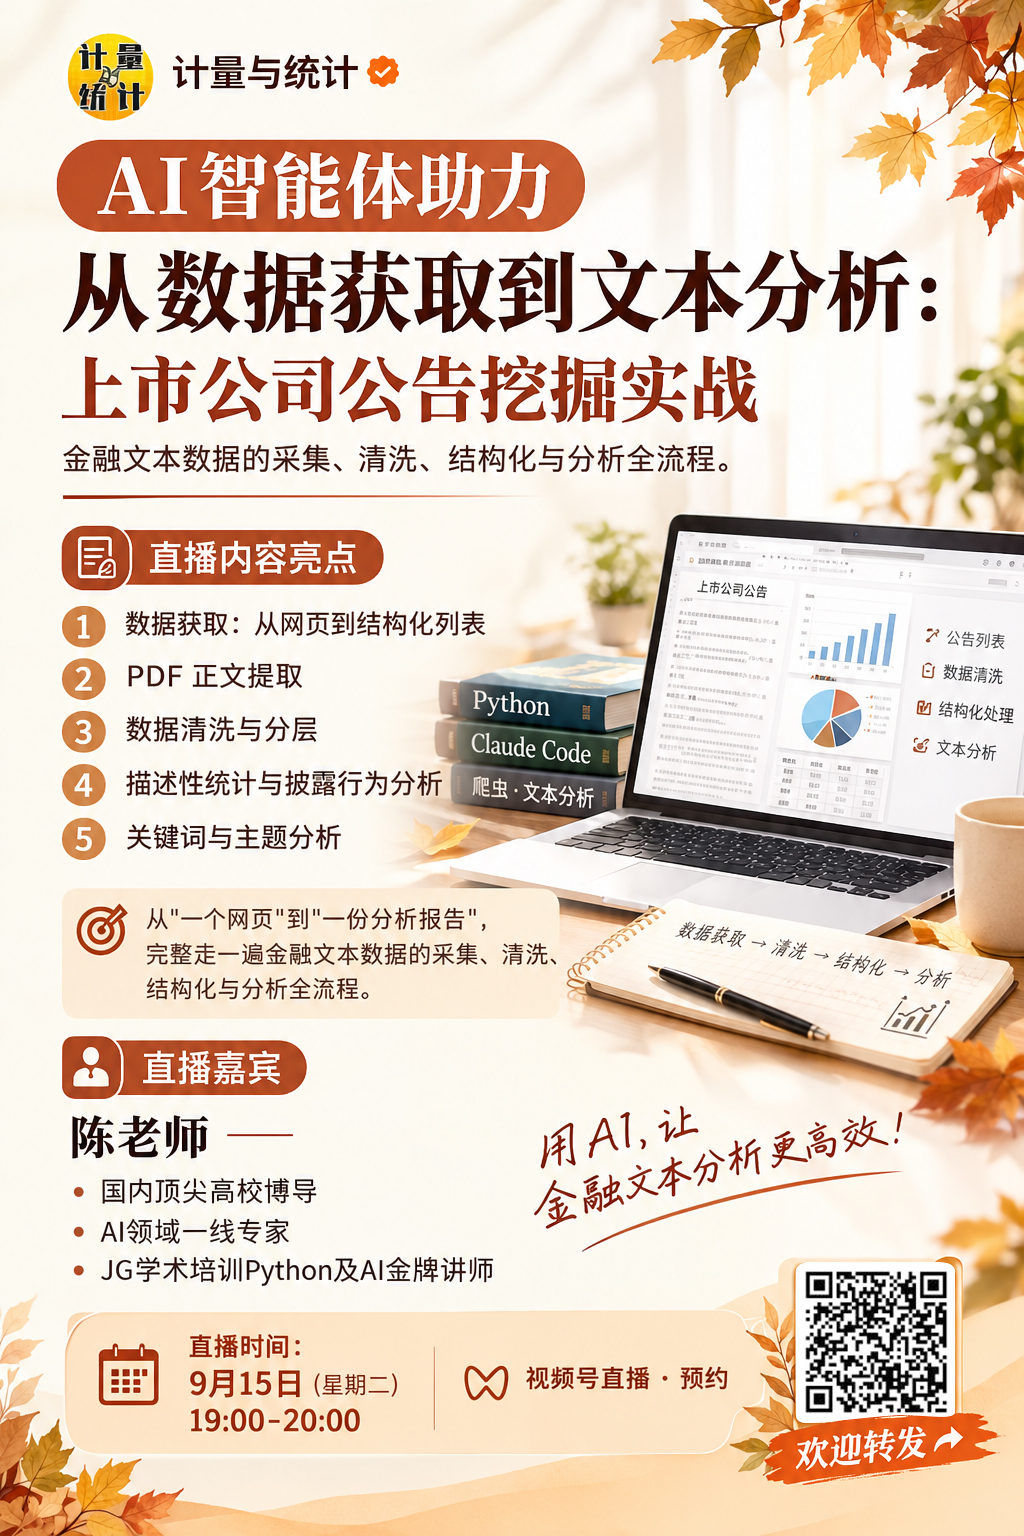
授课讲师介绍: 陈老师,国内顶尖高校博士生导师,北京大学博士,北京大学优秀博士后,人工智能资深讲师。主要科研方向:数据分析、大数据处理,人工智能。 发表SCI/EI学术论文100余篇,其中第一或通讯作者论文60余篇,授权国家发明专利20余项。主持国家自然科学基金面上项目,国家重点研发计划课题,国家自然科学基金青年项目及博士后基金等多个国家级和省部级项目。国自然函评专家。IEEE、OSA会员,多个SCI期刊审稿人。曾给中国移动,中国电信,中国银行,国家电网等多个企业和高校做过人工智能相关的课程培训。 JG学术培训Python及AI师资培训金牌讲师,通过多年相关课程帮助多位老师成功掌握相关学术及教学技能,授课风格通俗易懂,深入浅出,大量的实战案例,广受学员好评。
四天课程安排: 4天课程,不是学4天工具,而是完成一套科研数据Workflow Day1|AI 智能体赋能 Python 爬虫:从网页理解到数据获取 AI 智能体时代爬虫新范式,科研项目环境搭建;HTTP 网络基础与 Requests 库;网页解析 BeautifulSoup/Xpath、正则信息提取;多格式数据存储;单页 / 多页批量爬取,翻页逻辑、代理与异常处理。 ⭐实践案例:知网论文结构化采集、豆瓣、链家房源数据获取 Day2|Claude Code 智能体进阶爬虫:动态网页与复杂数据获取 高级网页节点解析,AI 自动生成 Xpath,适配网页结构变动;Selenium / Playwright 浏览器自动化,处理 JS 动态渲染页面;复杂网页合规获取、登录交互、验证码识别;Scrapy 框架 AI 增强,搭建大规模采集项目。 ⭐核心实战:完整Agent 爬虫工作流演示 —— 输入科研数据需求,AI 自动完成网页分析、代码生成、调试排错,输出结构化数据集。 ⭐实践案例:知网文献、电商评价、谷歌学术文献、新闻舆情数据采集 Day3|AI 智能体赋能文本分析:从文本清洗到特征提取 社科经管文本分析完整科研工作流;PDF/Word/ 年报 / 政策等多源文本读取;AI 驱动批量文本清洗、分词、噪声去除;TF‑IDF、Word2Vec、FastText、BERT 等文本表示方法;关键词提取、LDA 主题建模与结果解读。 ⭐经管特色实践:上市公司年报批量处理;从非结构化文本自动提取 ESG、风险、创新、管理层情绪等实证研究变量。 Day4|AI 智能体 + 文本分析:从传统NLP 到大模型科研应用 文本分类、聚类、情感分析、文本摘要的传统实现;Transformer/BERT核心原理,AI 辅助完成模型代码、调参与排错; 重点模块:ClaudeCode 大模型文本分析实战,掌握零样本 / 少样本分类、Embedding语义向量、批量结构化信息抽取。 ⭐综合结业项目:完整复刻社科实证研究全链路。 从研究问题出发,完成爬虫采集原始数据→清洗预处理→特征构建→主题 / 情感分析→生成可用于实证分析的数据集与可视化结果。 两个新增实战模块: - Claude Code智能体爬虫实战:从真实研究问题出发,AI自主完成"网页分析→代码生成→运行调试→数据质检→结构化存储"全流程。
- Claude Code+大模型文本分析:用AI批量处理文本、自动调用Python完成分析、结果整理为可直接用于实证的数据集。
适合谁参加? - 高校经管、社科、新闻传播、公管、法学等领域的老师和研究人员
- 正在撰写博士/硕士论文,需要快速获取和处理大规模文本数据的学生
- 从事研究方法教学,希望将AI智能体工具融入课程的师资
- 有一定Python基础或零基础,但愿意拥抱新工具的科研工作者
不需要你是编程专家,只需要你有一个想回答的研究问题。
开课信息 时间:2026年10月1日—4日(4天) 形式:北京现场面授 + 同步在线直播(直播提供回放) 基础要求:零基础友好,有Python基础者更能快速上手(赠送15+小时Python基础课) 为保证教学质量,现场与线上均限制人数,报满即止; 报名即赠AI智能体安装配置先导课(含资料与在线课程); 参加现场班提供会场酒店住宿协议价(含早)。
这次升级,为什么值得学? 如果用一句话概括这次课程的变化: 以前是“学习Python和文本分析”,现在是“用AI智能体完成科研数据处理”。 6个核心升级方向: ① 从“AI辅助写代码”升级为“AI智能体执行任务” 不只是让AI生成代码,而是让它参与:分析、编码、运行、调试和优化。 ② 从“学习Python”升级为“用AI降低Python学习门槛” 减少在查语法、找代码、改报错上的重复时间,把更多精力放在:研究问题与数据分析本身。 ③ 爬虫不再只是“爬网页” 而是:找数据 → 获取数据 → 清洗 → 结构化 → 保存,最终服务于科研。 ④ 文本分析不再只是“词频、分类、情感” 而是:从非结构化文本到实证研究变量,更贴近经管社科真实研究需求。 ⑤ Claude Code + Python,形成科研数据生产线 让 Claude Code 成为你的科研编程助手,让 Python 成为你的数据处理工具,让爬虫与文本分析真正服务于科研。 ⑥ 最终掌握的不是几个工具,而是一套Workflow 最终你掌握的是:AI智能体 + Python爬虫 + 文本分析科研数据处理全流程
咨询报名详情 尹老师 电话:13321178792 QQ:42884447 WeChat:JGxueshu 
主办单位:经管之家官方学术培训品牌 
名师精品学术培训,认准经管之家JG学术培训 官方出品,名师授课,实战为王,助力你的科研之路一路开挂!
写在最后: 研究方法的内卷,从来不在于你掌握了多少工具,而在于你能否用最高效的方式,把时间和精力集中在真正重要的问题上。 当AI智能体已经能够可靠地完成数据采集和文本预处理的技术性工作时,继续手写爬虫、手动清洗文本,本质上是一种机会成本。 10月1-4日,北京。我们聊聊,如何让科研数据处理这件事,变得更高效、更可控、更可复现。 欢迎转发给课题组同门,组队报名享额外优惠。
![二维码]()
扫码加我 拉你入群
请注明:姓名-公司-职位
以便审核进群资格,未注明则拒绝
| 


 发帖
 48 个论坛币


 雷达卡








 京公网安备 11010802022788号






