


 发帖

 雷达卡



引言
作为数据科学家或分析师,你知道理解数据是每个成功项目的基础。在构建模型、创建仪表板或生成洞察之前,你需要清楚自己正在处理的数据是什么样的。但探索性数据分析(EDA)既繁琐又重复,还十分耗时。
面对每一个新数据集,你可能都在编写几乎相同的代码——检查数据类型、计算统计量、绘制分布图等等。你需要系统、自动化的方法,快速且全面地理解数据。本文将介绍5个Python脚本,专门用于自动化数据探索中最重要、最耗时的环节。
1. 数据概况分析
// 痛点识别
当你第一次打开一个数据集时,需要了解它的基本特征。你会编写代码检查数据类型、统计唯一值数量、识别缺失数据、计算内存占用,并获取汇总统计信息。你需要对每一列都执行这些操作,为每个新数据集编写重复的代码。仅这一步初始概况分析,对于复杂数据集来说就可能花费一个小时甚至更久。
// 脚本功能概述
自动生成数据集的完整概况,包括所有列的数据类型、缺失值模式、基数分析、内存占用和统计汇总。检测潜在问题,如高基数分类变量、常量列和数据类型不匹配。生成结构化报告,让你在几秒钟内就能全面了解数据全貌。
// 工作原理说明
该脚本会遍历每一列,确定其类型,并计算相关统计量:
对于数值型列,计算均值、中位数、标准差、四分位数、偏度和峰度
对于分类列,识别唯一值、众数和频率分布
它会标记潜在的数据质量问题,例如缺失值超过50%的列、唯一值过多的分类列,以及方差为零的列。所有结果都会整理成一个易于阅读的数据框。
2. 分布分析与可视化
// 痛点识别
了解数据的分布情况,对于选择合适的转换方法和模型至关重要。你需要为数值型特征绘制直方图、箱线图和密度曲线,为分类特征绘制条形图。手动生成这些可视化图表,意味着要为每个变量编写绘图代码、调整布局,并管理多个图形窗口。对于包含几十个特征的数据集来说,这会变得非常繁琐。
// 脚本功能概述
为数据集中的所有特征生成全面的分布可视化图表。为数值型特征创建带核密度估计的直方图、显示异常值的箱线图,为分类特征创建条形图,以及用于评估正态性的Q-Q图。检测并突出显示偏态分布、多峰模式和潜在异常值。将所有图表按清晰的网格布局排列,并自动调整尺寸。
// 工作原理说明
该脚本会分离数值型和分类型列,然后为每种类型生成合适的可视化图表:
对于数值型特征,创建子图,显示带有叠加核密度估计(KDE)曲线的直方图,并标注偏度和峰度值
对于分类型特征,生成按频率排序的条形图,展示各值的出现次数
该脚本会自动确定最佳箱数、处理异常值,并使用统计测试标记与正态分布偏差显著的分布。所有可视化图表都采用统一的样式生成,可根据需要导出。
3. 相关性与关系探索
// 痛点识别
理解变量之间的关系至关重要,但过程十分繁琐。你需要计算相关矩阵、为有潜力的变量对创建散点图、识别多重共线性问题,并检测非线性关系。手动完成这些工作,需要生成几十个图表、计算多种相关系数(如皮尔逊相关系数、斯皮尔曼相关系数和肯德尔相关系数),并尝试在相关热力图中发现模式。这个过程速度缓慢,而且你常常会错过重要的关系。
// 脚本功能概述
分析数据集中所有变量之间的关系。使用多种方法生成相关矩阵,为高度相关的变量对创建散点图,检测回归建模中的多重共线性问题,并识别线性相关性可能遗漏的非线性关系。创建可深入查看特定关系的可视化图表,并标记潜在问题(如完全相关或冗余特征)。
// 工作原理说明
该脚本使用皮尔逊、斯皮尔曼和肯德尔三种相关方法计算相关矩阵,以捕捉不同类型的关系。它生成带注释的热力图,突出显示强相关性,然后为相关系数超过阈值的特征对创建详细的散点图。
在多重共线性检测方面,它计算方差膨胀因子(VIF),并识别具有高互相关性的特征组。该脚本还计算互信息得分,以捕捉相关系数遗漏的非线性关系。
4. 异常值检测与分析
// 痛点识别
异常值会影响你的分析和模型,但识别它们需要多种方法。你需要使用不同的统计方法(如四分位距(IQR)、Z分数和隔离森林)检查异常值,并通过箱线图和散点图可视化它们。然后,你需要了解它们对数据的影响,并判断它们是真实的异常值还是数据错误。手动实现和比较多种异常值检测方法,既耗时又容易出错。
// 脚本功能概述
使用多种统计和机器学习方法检测异常值,比较不同方法的结果以识别共识异常值,生成显示异常值位置和模式的可视化图表,并提供关于异常值特征的详细报告。帮助你了解异常值是孤立的数据点还是有意义的聚类的一部分,并估计它们对后续分析的潜在影响。
// 工作原理说明
该脚本应用多种异常值检测算法:
用于单变量异常值的四分位距(IQR)方法
用于多变量异常值的马氏距离
用于统计异常值的Z分数和修正Z分数
用于复杂异常模式的隔离森林
每种方法都会生成一组标记点,脚本会创建一个共识得分,显示每个观测值被多少种方法标记为异常值。它生成并排的可视化图表,比较不同检测方法的结果,突出显示被多种方法标记的观测值,并提供异常值的详细统计信息。该脚本还会进行敏感性分析,显示异常值对均值和相关性等关键统计量的影响。
5. 缺失数据模式分析
// 痛点识别
缺失数据很少是随机的,理解缺失模式对于选择合适的处理策略至关重要。你需要识别哪些列存在缺失数据、检测缺失模式、可视化缺失模式,并理解缺失值与其他变量之间的关系。手动进行这项分析,需要为每个数据集编写自定义代码,并使用复杂的可视化技术。
// 脚本功能概述
分析整个数据集中的缺失数据模式。识别存在缺失值的列,计算缺失率,并检测缺失模式的相关性。然后评估缺失类型——完全随机缺失(MCAR)、随机缺失(MAR)或非随机缺失(MNAR),并生成显示缺失模式的可视化图表。根据检测到的模式,提供处理策略建议。
// 工作原理说明
该脚本创建一个二进制缺失矩阵,标记缺失值的位置,然后分析该矩阵以检测模式。它计算缺失相关性,识别往往一起缺失的特征,使用统计测试评估缺失机制,并生成显示缺失模式的热力图和条形图。对于每个存在缺失数据的列,它通过统计测试和相关性分析,检查缺失情况与其他变量之间的关系。
基于检测到的模式,脚本推荐合适的插补策略:
对于完全随机缺失(MCAR)的数值数据,使用均值/中位数插补
对于随机缺失(MAR)的数据,使用预测插补
对于非随机缺失(MNAR)的数据,使用领域特定方法
总结
这五个脚本解决了每个数据从业者在数据探索中面临的核心挑战。
你可以将每个脚本单独用于特定的探索任务,也可以将它们组合成一个完整的探索性数据分析流程。其结果是一种系统、可复现的数据探索方法,为你每个项目节省数小时甚至数天的时间,同时确保你不会错过关于数据的重要洞察。
探索愉快!
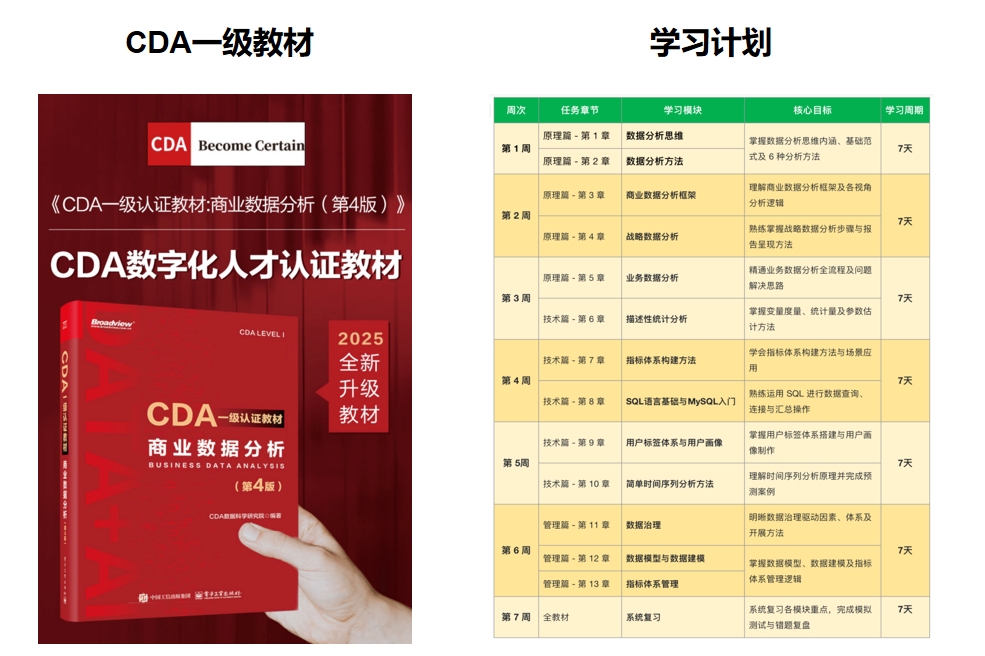
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802022788号






