


 发帖

 雷达卡



引言
在设计应用程序时,选择合适的SQL数据库引擎会对性能产生重大影响。
PostgreSQL、MySQL和SQLite是三款常见的选择。每款引擎都有其独特的优势和优化策略,适用于不同的场景。
PostgreSQL通常在处理复杂分析查询方面表现出色,MySQL也能提供稳定的通用性能。另一方面,SQLite则为嵌入式应用提供了轻量级解决方案。
本文将通过四道分析类面试题(两道中等难度、两道困难难度),对这三款引擎进行基准测试。
每道题的核心目标是考察各引擎对连接操作、窗口函数、日期运算和复杂聚合的处理能力,由此凸显各平台特有的优化策略,并深入解析各引擎的性能表现和技术规格。
三款SQL引擎详解
在深入基准测试之前,我们先了解这三款数据库系统的差异。
PostgreSQL是一款功能丰富的开源关系型数据库,以高级SQL兼容性和复杂的查询优化能力著称。它能高效处理复杂分析查询,对窗口函数、公共表表达式(CTE)和多种索引策略提供强大支持。
MySQL是使用最广泛的开源数据库,因其在Web应用中的速度和准确性而备受青睐。尽管历史上它更侧重于事务型工作负载,但现代版本的该引擎已具备全面的分析能力,支持窗口函数并改进了查询优化。
SQLite是一款直接嵌入应用程序的轻量级引擎。与前两款作为独立服务器进程运行的引擎不同,SQLite以库的形式运行,非常适合移动应用、桌面程序和开发环境。
然而,正如你可能预期的那样,这种简洁性也带来了一些限制,例如在并发写入操作和某些SQL功能上的不足。
本文的基准测试采用四道面试题,分别测试不同的SQL能力。
针对每道题,我们将分析三款引擎的查询解决方案,重点说明它们的语法差异、性能注意事项和优化空间。
我们将测试它们在执行时间方面的性能表现:Postgres和MySQL在StrataScratch平台(基于服务器)上进行基准测试,而SQLite则在本地内存中进行测试。
解答中等难度题目
// 面试题1:高风险项目
该面试题要求根据员工工资的按比例分摊金额,识别超出预算的项目。
数据表:提供三个表:linkedin_projects(包含预算和日期)、linkedin_emp_projects(员工-项目关联表)和linkedin_employees(员工表)。
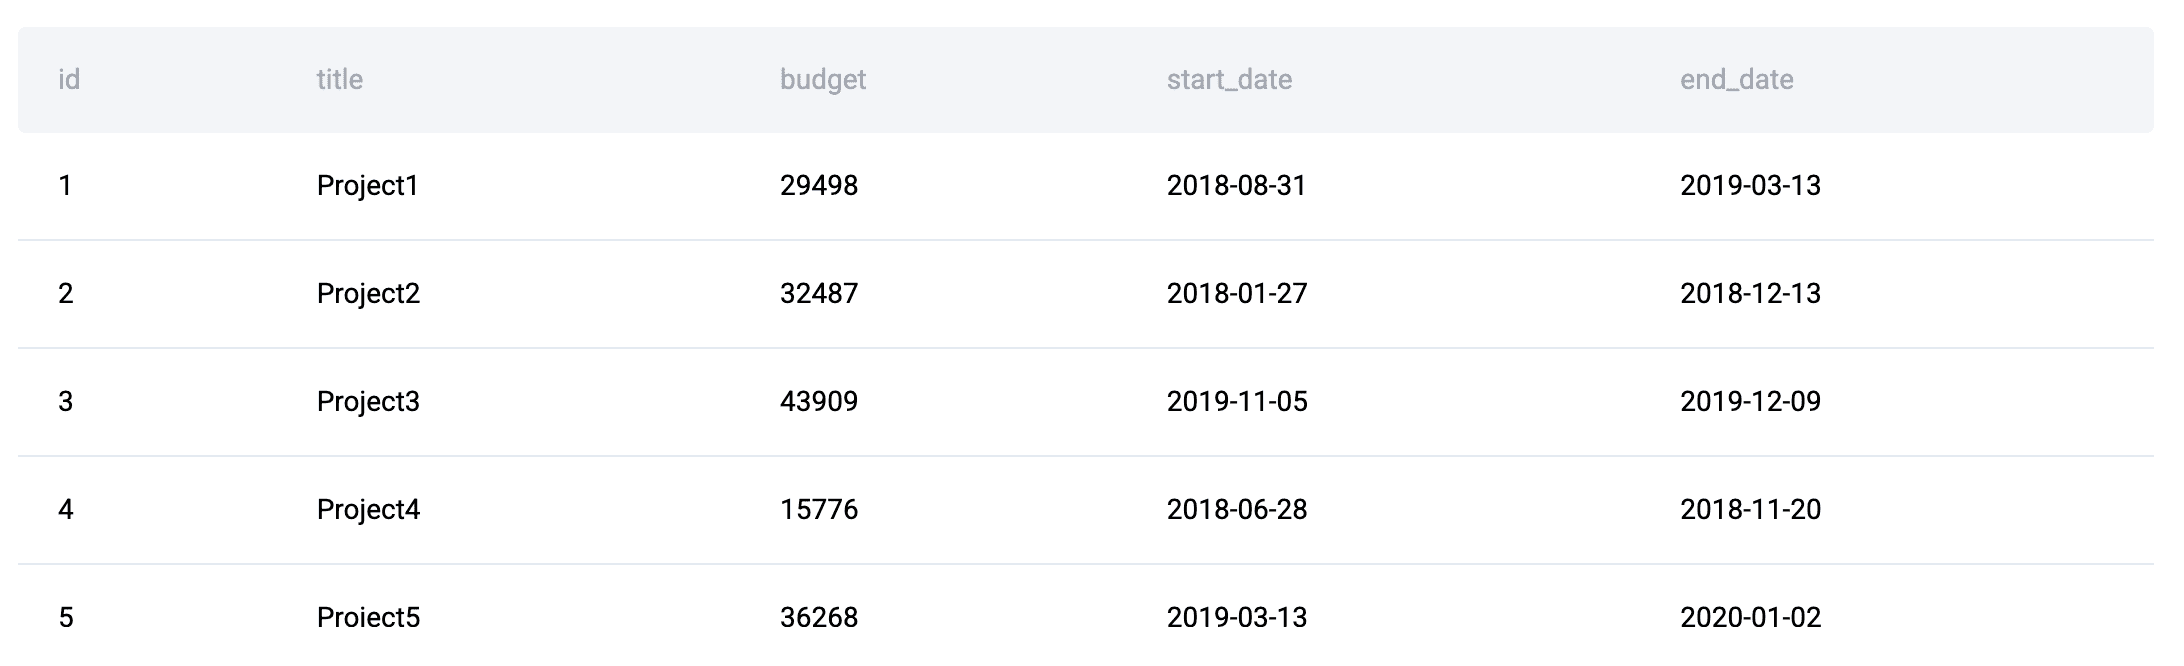
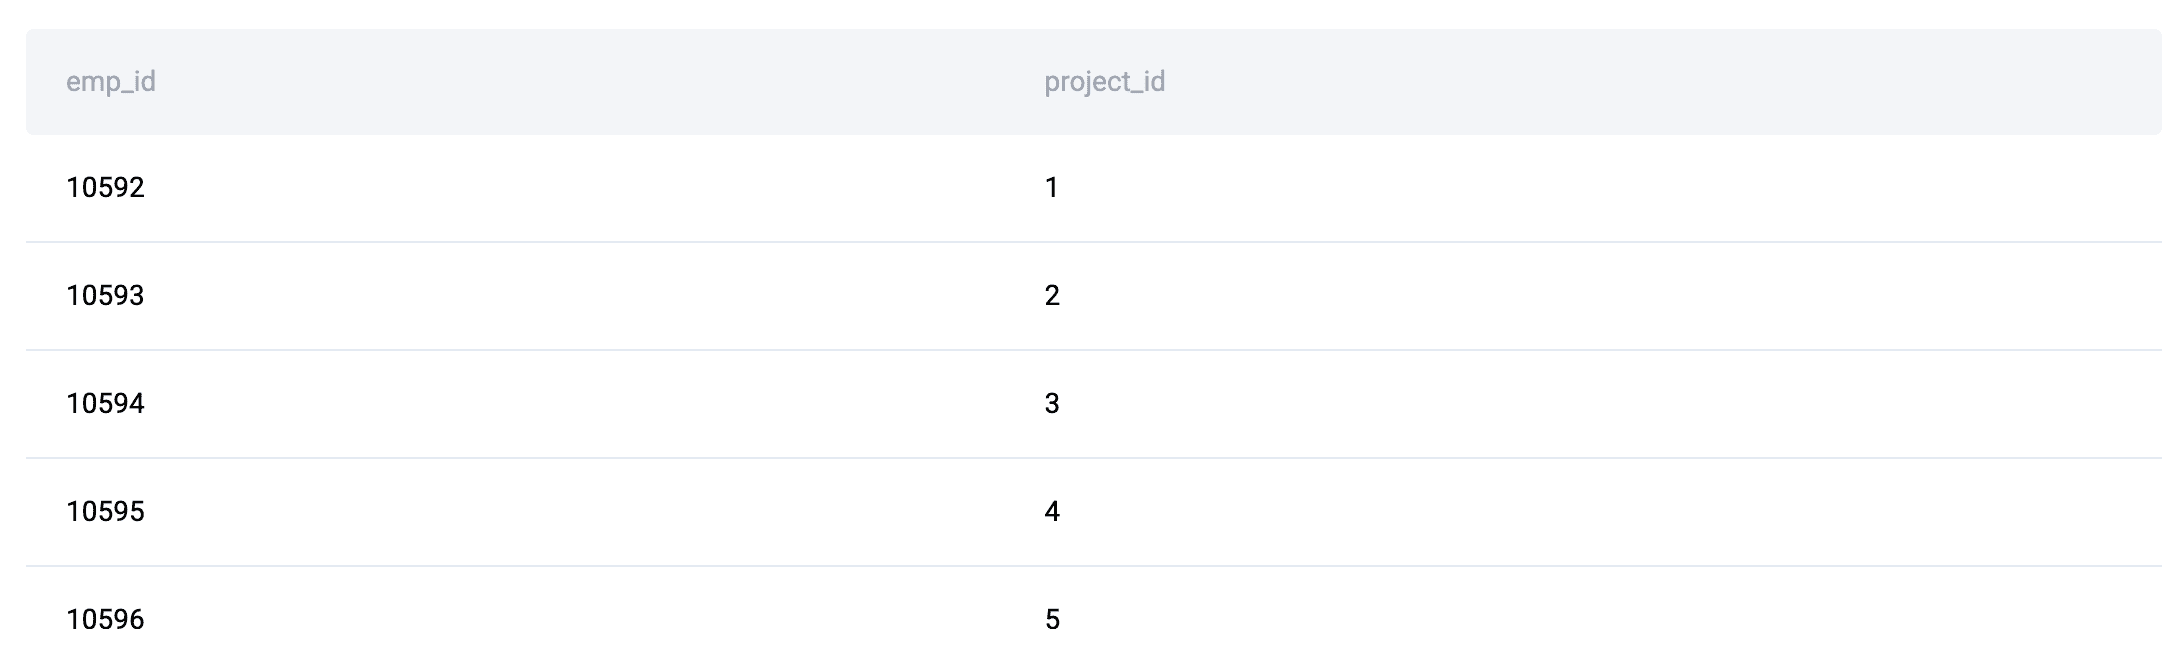
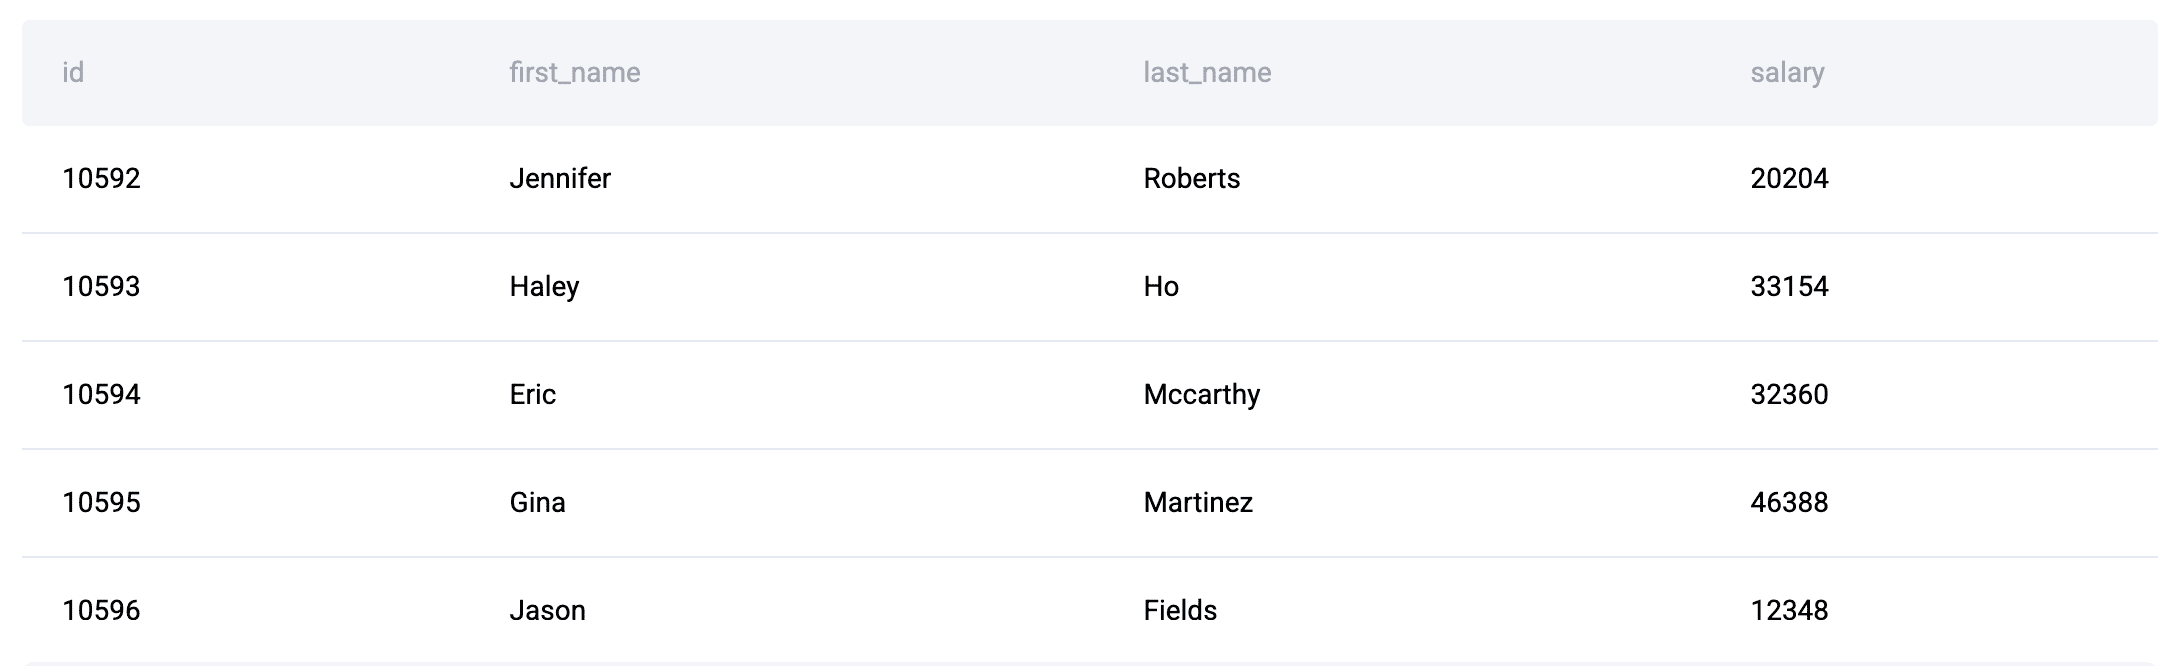
核心目标是计算每位员工的年薪分摊到每个项目的金额,并判断哪些项目超出预算。
PostgreSQL解决方案如下:
SELECT a.title,
       a.budget,
       CEILING((a.end_date - a.start_date) * SUM(c.salary) / 365) AS prorated_employee_expense
FROM linkedin_projects a
INNER JOIN linkedin_emp_projects b ON a.id = b.project_id
INNER JOIN linkedin_employees c ON b.emp_id = c.id
GROUP BY a.title,
         a.budget,
         a.end_date,
         a.start_date
HAVING CEILING((a.end_date - a.start_date) * SUM(c.salary) / 365) > a.budget
ORDER BY a.title ASC;
PostgreSQL通过直接减法(end_date − start_date)优雅地处理日期运算,该操作会返回两个日期之间的天数。
得益于引擎对日期的原生处理,整个计算过程简洁易懂。
MySQL解决方案:
SELECT a.title,
       a.budget,
       CEILING(DATEDIFF(a.end_date, a.start_date) * SUM(c.salary) / 365) AS prorated_employee_expense
FROM linkedin_projects a
INNER JOIN linkedin_emp_projects b ON a.id = b.project_id
INNER JOIN linkedin_employees c ON b.emp_id = c.id
GROUP BY a.title,
         a.budget,
         a.end_date,
         a.start_date
HAVING CEILING(DATEDIFF(a.end_date, a.start_date) * SUM(c.salary) / 365) > a.budget
ORDER BY a.title ASC;
在MySQL中,日期运算需要使用DATEDIFF()函数,该函数会明确计算两个日期之间的天数。
尽管增加了一个函数调用,但MySQL的查询优化器能高效处理该操作。
最后,我们来看SQLite解决方案:
SELECT a.title,
    a.budget,
    CAST(
        (julianday(a.end_date) - julianday(a.start_date)) * (SUM(c.salary) / 365) + 0.99
    AS INTEGER) AS prorated_employee_expense
FROM linkedin_projects a
INNER JOIN linkedin_emp_projects b ON a.id = b.project_id
INNER JOIN linkedin_employees c ON b.emp_id = c.id
GROUP BY a.title, a.budget, a.end_date, a.start_date
HAVING CAST(
        (julianday(a.end_date) - julianday(a.start_date)) * (SUM(c.salary) / 365) + 0.99
    AS INTEGER) > a.budget
ORDER BY a.title ASC;
SQLite使用julianday()函数将日期转换为数值型,以便进行算术运算。
由于SQLite没有CEILING()(向上取整)函数,我们可以通过加0.99后转换为整数的方式模拟该功能,实现精准向上取整。
// 查询优化
对于三款引擎而言,在连接列(project_id、emp_id、id)上创建索引可以显著提升性能。PostgreSQL的优势在于为GROUP BY子句创建(title、budget、end_date、start_date)复合索引。
合理使用主键至关重要,因为MySQL的InnoDB引擎会自动按主键对数据进行聚簇存储。
// 面试题2:查找重复购买用户
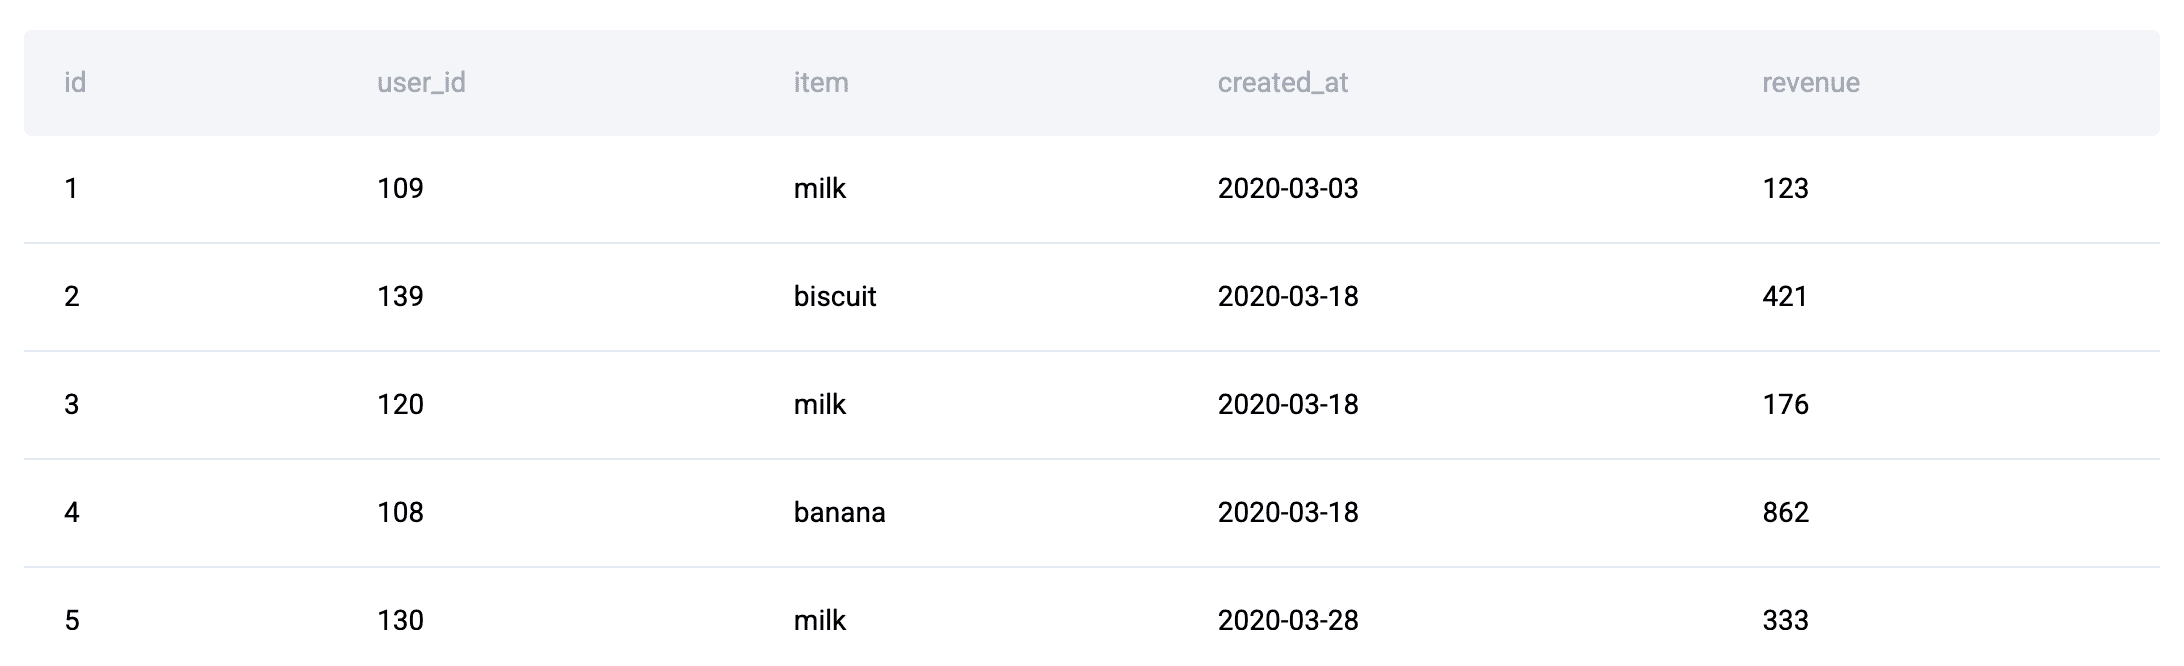
该面试题的目标是输出在首次购买后1至7天内(不含当天)进行第二次购买的重复客户ID。
数据表:仅提供一个表amazon_transactions,包含交易记录,字段有id、user_id、item、created_at和revenue。
PostgreSQL解决方案:
WITH daily AS (
    SELECT DISTINCT user_id, created_at::date AS purchase_date
    FROM amazon_transactions
),
ranked AS (
    SELECT user_id, purchase_date,
        ROW_NUMBER() OVER (PARTITION BY user_id ORDER BY purchase_date) AS rn
    FROM daily
),
first_two AS (
    SELECT user_id,
        MAX(CASE WHEN rn = 1 THEN purchase_date END) AS first_date,
        MAX(CASE WHEN rn = 2 THEN purchase_date END) AS second_date
    FROM ranked
    WHERE rn <= 2
    GROUP BY user_id
)
SELECT user_id
FROM first_two
WHERE second_date IS NOT NULL
    AND (second_date - first_date) BETWEEN 1 AND 7
ORDER BY user_id;
在PostgreSQL中,解决方案使用公共表表达式(CTE)将问题拆分为逻辑清晰、易于阅读的步骤。
日期转换函数将时间戳转换为日期,窗口函数ROW_NUMBER()按时间顺序对购买记录进行排名。PostgreSQL原生的日期减法功能使最终的筛选条件简洁且高效。
MySQL解决方案:
WITH daily AS (
    SELECT DISTINCT user_id, DATE(created_at) AS purchase_date
    FROM amazon_transactions
),
ranked AS (
    SELECT user_id, purchase_date,
        ROW_NUMBER() OVER (PARTITION BY user_id ORDER BY purchase_date) AS rn
    FROM daily
),
first_two AS (
    SELECT user_id,
        MAX(CASE WHEN rn = 1 THEN purchase_date END) AS first_date,
        MAX(CASE WHEN rn = 2 THEN purchase_date END) AS second_date
    FROM ranked
    WHERE rn <= 2
    GROUP BY user_id
)
SELECT user_id
FROM first_two
WHERE second_date IS NOT NULL
    AND DATEDIFF(second_date, first_date) BETWEEN 1 AND 7
ORDER BY user_id;
MySQL的解决方案与PostgreSQL的结构类似,同样使用CTE和窗口函数。
主要区别在于使用DATE()函数提取日期、使用DATEDIFF()函数进行日期比较。MySQL 8.0+版本高效支持CTE,而早期版本则需要使用子查询。
SQLite解决方案:
WITH daily AS (
    SELECT DISTINCT user_id, DATE(created_at) AS purchase_date
    FROM amazon_transactions
),
ranked AS (
    SELECT user_id, purchase_date,
        ROW_NUMBER() OVER (PARTITION BY user_id ORDER BY purchase_date) AS rn
    FROM daily
),
first_two AS (
    SELECT user_id,
        MAX(CASE WHEN rn = 1 THEN purchase_date END) AS first_date,
        MAX(CASE WHEN rn = 2 THEN purchase_date END) AS second_date
    FROM ranked
    WHERE rn <= 2
    GROUP BY user_id
)
SELECT user_id
FROM first_two
WHERE second_date IS NOT NULL
    AND (julianday(second_date) - julianday(first_date)) BETWEEN 1 AND 7
ORDER BY user_id;
SQLite(3.25+版本)同样支持CTE和窗口函数,因此结构与前两款引擎完全一致。本例中唯一的区别是日期运算,使用julianday()函数而非原生减法或DATEDIFF()函数。
// 查询优化
本例中,索引也可用于窗口函数的高效分区,尤其是针对user_id字段。PostgreSQL可受益于对活跃用户的部分索引。
如果处理大型数据集,在PostgreSQL中还可考虑将daily CTE物化。为确保MySQL中CTE的最佳性能,请确保使用8.0+版本。
解答困难难度题目
// 面试题3:营收随时间变化趋势
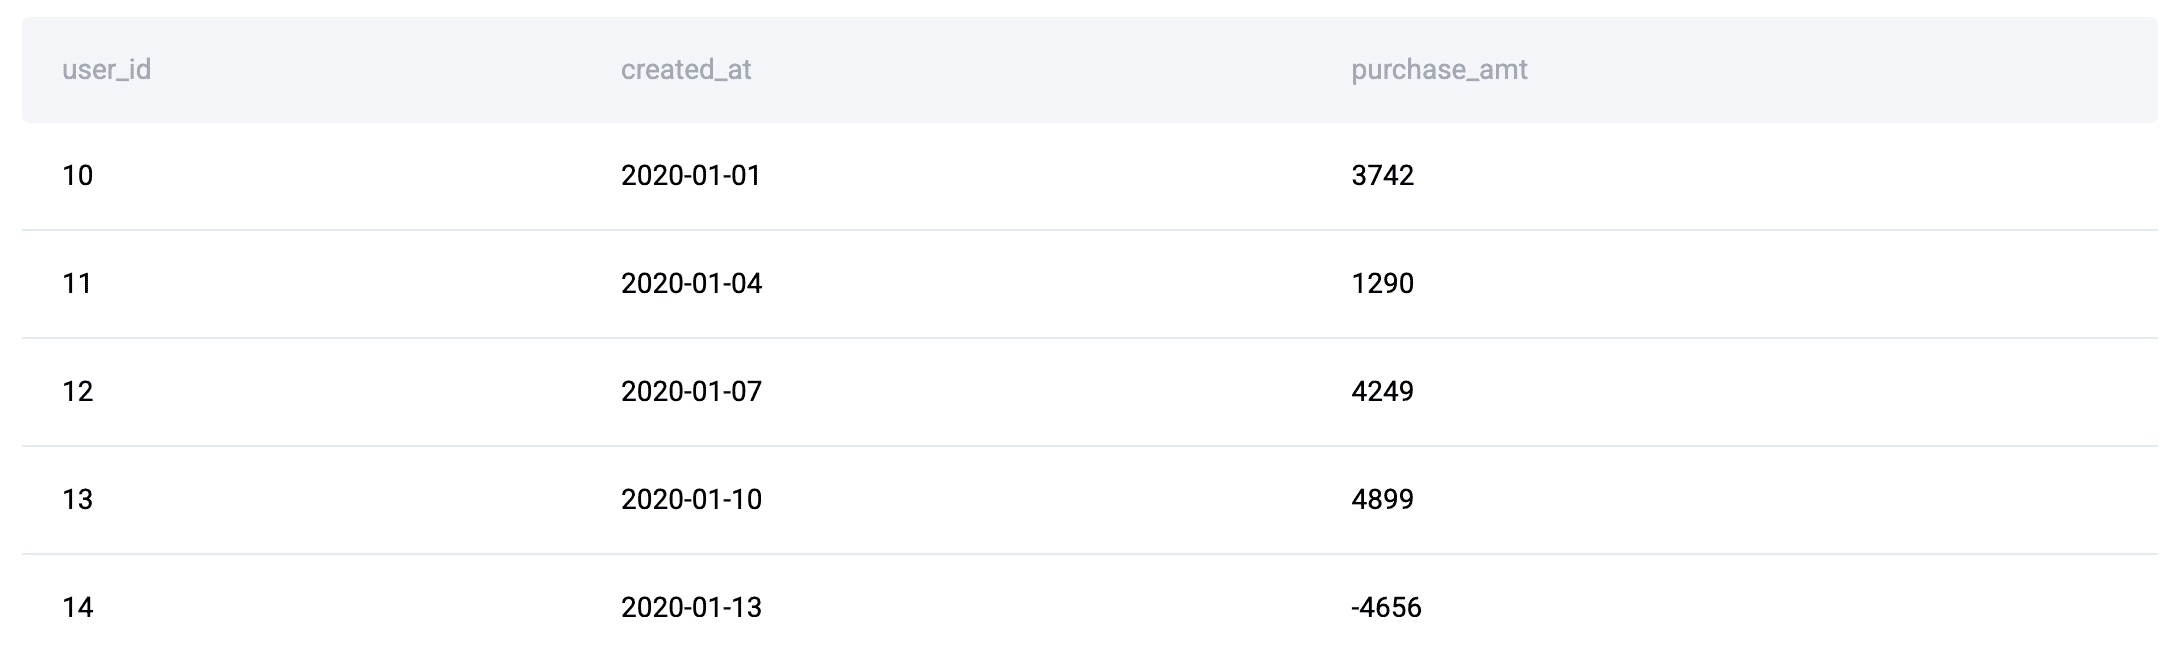
该面试题要求计算购买营收的3个月滚动平均值。
目标是输出年月值及其对应的滚动平均值,按时间顺序排序。需排除退货(购买金额为负)记录。
数据表:
amazon_purchases:包含购买记录,字段有user_id、created_at和purchase_amt。
首先,我们来看PostgreSQL解决方案:
SELECT t.month,
    AVG(t.monthly_revenue) OVER(
        ORDER BY t.month
        ROWS BETWEEN 2 PRECEDING AND CURRENT ROW
    ) AS avg_revenue
FROM (
    SELECT to_char(created_at::date, 'YYYY-MM') AS month,
        sum(purchase_amt) AS monthly_revenue
    FROM amazon_purchases
    WHERE purchase_amt > 0
    GROUP BY to_char(created_at::date, 'YYYY-MM')
    ORDER BY to_char(created_at::date, 'YYYY-MM')
) t
ORDER BY t.month ASC;
PostgreSQL在窗口函数方面表现出色,框架指定语句ROWS BETWEEN 2 PRECEDING AND CURRENT ROW精准定义了滚动窗口(当前行及前两行,即3个月)。
to_char()函数将日期格式化为年月字符串,用于分组操作。
接下来是MySQL解决方案:
SELECT t.`month`,
    AVG(t.monthly_revenue) OVER(
        ORDER BY t.`month`
        ROWS BETWEEN 2 PRECEDING AND CURRENT ROW
    ) AS avg_revenue
FROM (
    SELECT DATE_FORMAT(created_at, '%Y-%m') AS month,
        sum(purchase_amt) AS monthly_revenue
    FROM amazon_purchases
    WHERE purchase_amt > 0
    GROUP BY DATE_FORMAT(created_at, '%Y-%m')
    ORDER BY DATE_FORMAT(created_at, '%Y-%m')
) t
ORDER BY t.`month` ASC;
MySQL的实现方式在窗口函数的处理上与PostgreSQL完全一致,区别仅在于使用DATE_FORMAT()函数而非to_char()函数进行日期格式化。
注意:该引擎有特定的语法要求以避免关键字冲突,因此month字段需要用反引号(`)包裹。
最后是SQLite解决方案:
SELECT t.month,
    AVG(t.monthly_revenue) OVER(
        ORDER BY t.month
        ROWS BETWEEN 2 PRECEDING AND CURRENT ROW
    ) AS avg_revenue
FROM (
    SELECT strftime('%Y-%m', created_at) AS month,
        SUM(purchase_amt) AS monthly_revenue
    FROM amazon_purchases
    WHERE purchase_amt > 0
    GROUP BY strftime('%Y-%m', created_at)
    ORDER BY strftime('%Y-%m', created_at)
) t
ORDER BY t.month ASC;
SQLite中的日期格式化需要使用strftime()函数,且该引擎(3.25+版本)支持与PostgreSQL、MySQL相同的窗口函数语法。对于中小型数据集,性能表现相当。
// 查询优化
窗口函数的计算成本较高。
对于PostgreSQL,可考虑在created_at字段上创建索引;如果该查询频繁运行,可创建月度聚合的物化视图。
MySQL可受益于包含created_at和purchase_amt字段的覆盖索引。
对于SQLite,需使用3.25及以上版本才能支持窗口函数。
// 面试题4:共同好友的好友
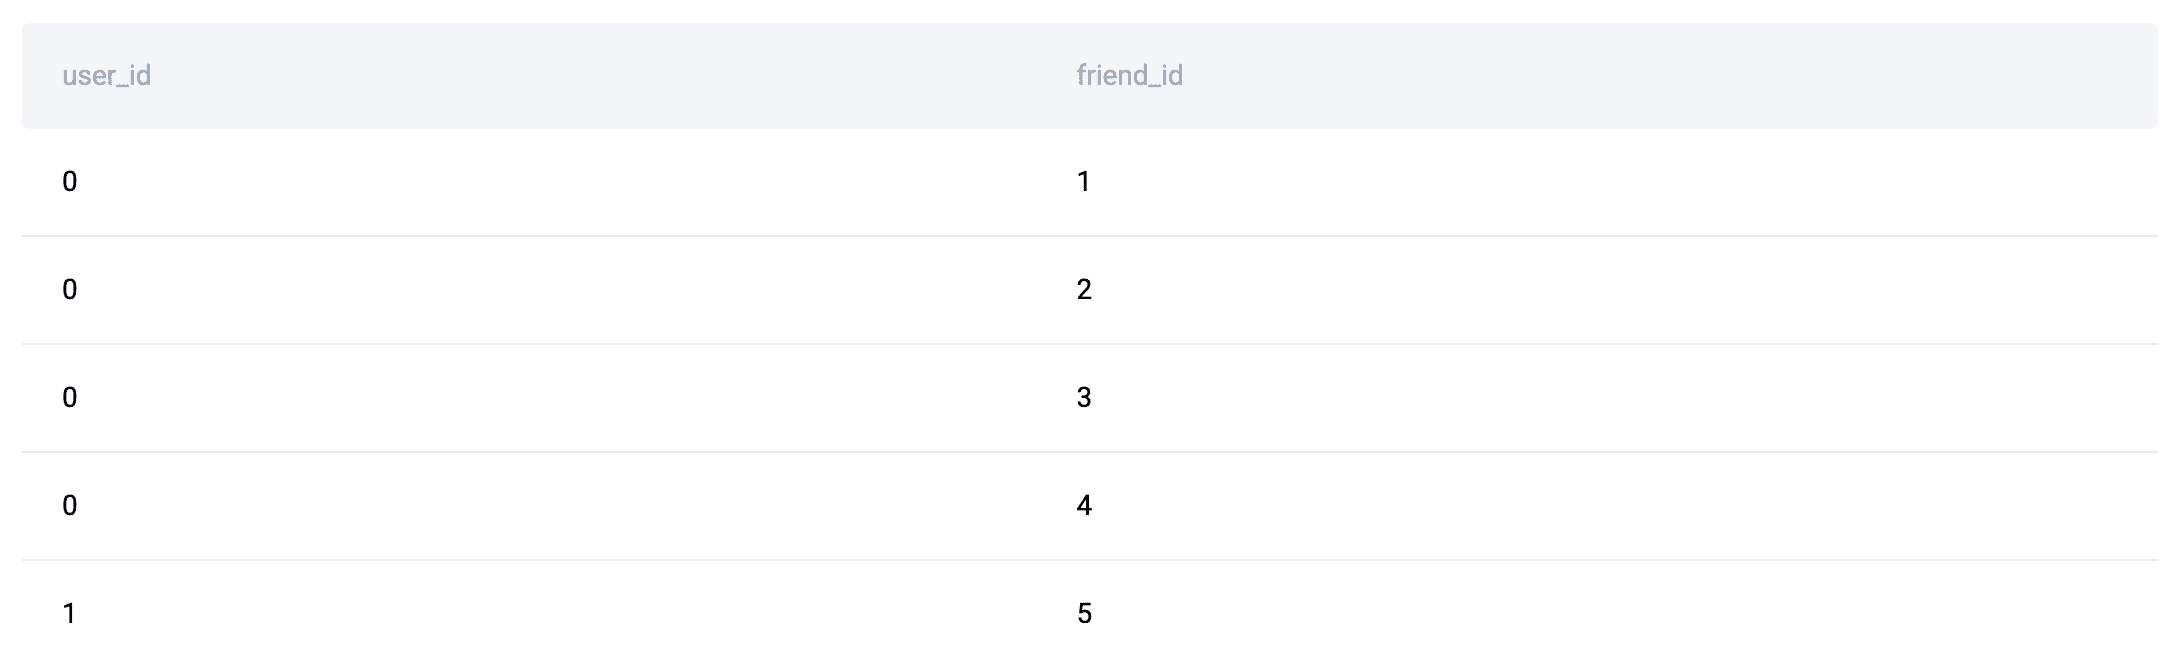
接下来的这道面试题,要求统计每位用户的好友中,同时也是该用户其他好友的好友的人数(本质上是社交网络中的共同关联)。目标是输出用户ID及其对应的这类共同好友-好友关系的数量。
数据表:
google_friends_network:包含好友关系记录,字段有user_id和friend_id。
PostgreSQL解决方案:
WITH bidirectional_relationship AS (
    SELECT user_id, friend_id
    FROM google_friends_network
    UNION
    SELECT friend_id AS user_id, user_id AS friend_id
    FROM google_friends_network
)
SELECT user_id, COUNT(DISTINCT friend_id) AS n_friends
FROM (
    SELECT DISTINCT a.user_id, c.user_id AS friend_id
    FROM bidirectional_relationship a
    INNER JOIN bidirectional_relationship b ON a.friend_id = b.user_id
    INNER JOIN bidirectional_relationship c ON b.friend_id = c.user_id
        AND c.friend_id = a.user_id
) base
GROUP BY user_id;
在PostgreSQL中,其复杂的查询规划器能高效处理这种多连接查询。
初始CTE创建了网络中双向的关系视图,随后通过三次自连接识别三角关系:A是B的好友,B是C的好友,且C也是A的好友。
MySQL解决方案:
SELECT user_id, COUNT(DISTINCT friend_id) AS n_friends
FROM (
    SELECT DISTINCT a.user_id, c.user_id AS friend_id
    FROM (
        SELECT user_id, friend_id
        FROM google_friends_network
        UNION
        SELECT friend_id AS user_id, user_id AS friend_id
        FROM google_friends_network
    ) AS a
    INNER JOIN (
        SELECT user_id, friend_id
        FROM google_friends_network
        UNION
        SELECT friend_id AS user_id, user_id AS friend_id
        FROM google_friends_network
    ) AS b ON a.friend_id = b.user_id
    INNER JOIN (
        SELECT user_id, friend_id
        FROM google_friends_network
        UNION
        SELECT friend_id AS user_id, user_id AS friend_id
        FROM google_friends_network
    ) AS c ON b.friend_id = c.user_id
        AND c.friend_id = a.user_id
) base
GROUP BY user_id;
MySQL的解决方案没有使用单个CTE,而是三次重复了UNION子查询。
虽然不够简洁,但这是MySQL 8.0之前版本的必要做法。现代MySQL版本可采用PostgreSQL的方式使用CTE,以提升可读性并可能改善性能。
SQLite解决方案:
WITH bidirectional_relationship AS (
    SELECT user_id, friend_id
    FROM google_friends_network
    UNION
    SELECT friend_id AS user_id, user_id AS friend_id
    FROM google_friends_network
)
SELECT user_id, COUNT(DISTINCT friend_id) AS n_friends
FROM (
    SELECT DISTINCT a.user_id, c.user_id AS friend_id
    FROM bidirectional_relationship a
    INNER JOIN bidirectional_relationship b ON a.friend_id = b.user_id
    INNER JOIN bidirectional_relationship c ON b.friend_id = c.user_id
        AND c.friend_id = a.user_id
) base
GROUP BY user_id;
SQLite支持CTE,处理该查询的方式与PostgreSQL完全一致。
然而,在处理大型网络时,性能可能会下降,这是因为SQLite的查询优化器相对简单,且缺乏高级索引策略。
// 查询优化
对于所有引擎,在(user_id, friend_id)上创建复合索引都能提升性能。在PostgreSQL中,当work_mem配置适当时,可对大型数据集使用哈希连接。
对于MySQL,需确保InnoDB缓冲池大小配置合理。SQLite在处理非常大的网络时可能会遇到困难,此时可考虑对数据进行反规范化处理,或在生产环境中预计算关系。
性能对比
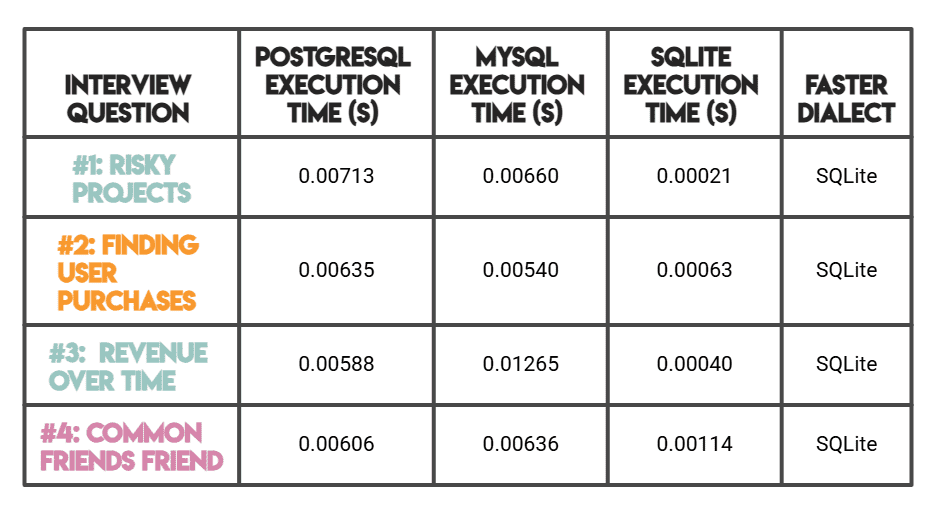
注意:如前所述,PostgreSQL和MySQL在StrataScratch平台(基于服务器)上进行基准测试,而SQLite则在本地内存中进行测试。
SQLite的执行时间显著更快,这是合理的——因其无服务器、零开销的架构(而非更优的查询优化)。
在服务器对服务器的对比中,MySQL在较简单的查询(第1、2题)上表现优于PostgreSQL,而PostgreSQL在复杂的分析工作负载(第3、4题)上速度更快。
关键性能差异分析
通过这些基准测试,我们发现了以下规律:
SQLite在所有四道题中都是最快的引擎,且往往领先幅度较大。这主要得益于其无服务器、内存中的架构——没有网络开销或客户端-服务器通信,对于小型数据集,查询执行几乎是瞬时的。
然而,这种速度优势在数据量较小时最为明显。
在复杂分析查询上,PostgreSQL的性能优于MySQL,尤其是涉及窗口函数和多个CTE的查询(第3、4题)。其复杂的查询规划器和丰富的索引选项,使其成为数据仓库和分析工作负载的首选——在这类场景中,查询复杂度比原始简洁性更重要。
MySQL在较简单的中等难度查询(第1、2题)上击败了PostgreSQL,凭借DATEDIFF()等简洁的语法要求提供了具有竞争力的性能。它的优势在于高并发事务型工作负载,不过现代版本也能很好地处理分析查询。
简而言之,SQLite在轻量级、嵌入式场景(中小型数据集)中表现突出;PostgreSQL是大规模复杂分析的最佳选择;而MySQL在性能和通用可靠性之间取得了良好的平衡。
总结
通过本文,你将了解PostgreSQL、MySQL和SQLite之间的一些细微差异,从而能够根据自身具体需求选择合适的工具。
再次强调:我们发现MySQL在稳定性能和通用可靠性之间取得了平衡,PostgreSQL则在具有复杂SQL功能的分析场景中表现出色,而SQLite为嵌入式环境提供了轻量级的简洁解决方案。
了解每个引擎如何处理特定的SQL操作,比单纯选择“最好”的引擎更能获得更好的性能。充分利用引擎特定的功能(如MySQL的覆盖索引或PostgreSQL的部分索引),为连接列和筛选列创建索引,并始终使用EXPLAIN或EXPLAIN ANALYZE子句来理解查询执行计划。
通过这些基准测试,希望你现在能够在数据库选择和优化策略上做出明智的决策,这些决策将直接影响你实现方案的性能。
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802022788号






