


 发帖

 雷达卡



引言
数据分析项目通常始于探索性的Python笔记本,但在某个阶段需要迁移到生产环境——如果规划不当,这个过程可能会充满挑战。
QuantumBlack公司开发的框架Kedro,是一款开源工具,它通过将项目结构、可扩展性和可复现性相关概念转化为实际操作,填补了实验性笔记本与生产就绪解决方案之间的空白。
本文将介绍并探索Kedro的主要功能,在深入学习这个用于处理实际数据分析项目的框架之前,先引导你了解其核心概念,帮助你更好地掌握该工具。
开始使用Kedro
使用Kedro的第一步,当然是在运行环境中安装它——理想环境是集成开发环境(IDE),因为Kedro在笔记本环境中无法充分发挥其功能。打开你常用的Python IDE(例如VS Code),在集成终端中输入以下命令:
pip install kedro
接下来,使用以下命令创建一个新的Kedro项目:
kedro new
如果命令执行成功,系统会询问你几个问题,包括项目名称。我们将项目命名为“客户流失预测器”(Churn Predictor)。如果命令执行失败,可能是因为安装了多个Python版本导致冲突。这种情况下,最简洁的解决方案是在IDE中使用虚拟环境。以下是创建虚拟环境的快速解决命令(如果之前创建Kedro项目的命令已成功执行,则可忽略这些命令):
python3.11 -m venv venv
source venv/bin/activate
pip install kedro
kedro --version
然后在IDE中选择以下Python解释器进行后续操作:./venv/bin/python。
如果一切顺利,此时在左侧(VS Code的“资源管理器”面板中),你将看到“churn-predictor”项目内部的完整项目结构。在终端中,导航到项目的主文件夹:
cd churn-predictor/
现在,让我们通过这个新创建的项目,初步了解Kedro的核心功能。
探索Kedro的核心元素
我们要介绍并亲手创建的第一个元素是“数据目录”(data catalog)。在Kedro中,这个元素负责将数据定义与主代码分离。
项目结构中已经创建了一个空文件,将作为数据目录。我们只需找到该文件并填充内容即可。在IDE的资源管理器中,进入“churn-predictor”项目,找到“conf/base/catalog.yml”并打开,然后添加以下内容:
raw_customers:
  type: pandas.CSVDataset
  filepath: data/01_raw/customers.csv

processed_features:
  type: pandas.ParquetDataset
  filepath: data/02_intermediate/features.parquet

train_data:
  type: pandas.ParquetDataset
  filepath: data/02_intermediate/train.parquet

test_data:
  type: pandas.ParquetDataset
  filepath: data/02_intermediate/test.parquet

trained_model:
  type: pickle.PickleDataset
  filepath: data/06_models/churn_model.pkl
简而言之,我们刚刚定义了(尚未创建)五个数据集,每个数据集都有一个可访问的键或名称:raw_customers、processed_features等。我们稍后将创建的主要数据管道,能够通过这些名称引用这些数据集,从而将输入/输出操作与代码抽象并完全分离。
现在,我们需要一些数据作为上述数据目录定义中的第一个数据集。对于本示例,你可以获取这份合成生成的客户数据样本,下载后将其集成到你的Kedro项目中。
接下来,导航到“data/01_raw”目录,创建一个名为“customers.csv”的新文件,并将我们将使用的示例数据集内容添加进去。最简单的方法是在GitHub上查看数据集文件的“原始”内容,全选、复制,然后粘贴到你在Kedro项目中新建的文件里。
现在,我们将创建一个Kedro管道(pipeline),用于描述将应用于原始数据集的数据分析工作流程。在终端中输入以下命令:
kedro pipeline create data_processing
该命令会在“src/churn_predictor/pipelines/data_processing/”目录下创建多个Python文件。现在,我们打开“nodes.py”并粘贴以下代码:
import pandas as pd
from typing import Tuple

def engineer_features(raw_df: pd.Datafr ame) -> pd.Datafr ame:
    """为建模创建衍生特征。"""
    df = raw_df.copy()
    df['tenure_months'] = df['account_age_days'] / 30
    df['avg_monthly_spend'] = df['total_spend'] / df['tenure_months']
    df['calls_per_month'] = df['support_calls'] / df['tenure_months']
    return df

def split_data(df: pd.Datafr ame, test_fraction: float) -> Tuple[pd.Datafr ame, pd.Datafr ame]:
    """将数据拆分为训练集和测试集。"""
    train = df.sample(frac=1-test_fraction, random_state=42)
    test = df.drop(train.index)
    return train, test
我们刚刚定义的两个函数充当“节点”(node),可以在可复现、模块化的工作流程中对数据集进行转换。第一个函数通过从原始特征创建多个衍生特征,执行一些简单的示例性特征工程;第二个函数定义了将数据集划分为训练集和测试集的逻辑,例如用于后续的机器学习建模。
同一子目录下还有另一个Python文件:pipeline.py。我们打开它并添加以下内容:
from kedro.pipeline import Pipeline, node
from .nodes import engineer_features, split_data

def create_pipeline(**kwargs) -> Pipeline:
    return Pipeline([
        node(
            func=engineer_features,
            inputs="raw_customers",
            outputs="processed_features",
            name="feature_engineering"
        ),
        node(
            func=split_data,
            inputs=["processed_features", "params:test_fraction"],
            outputs=["train_data", "test_data"],
            name="split_dataset"
        )
    ])
这里蕴含着Kedro的核心优势:注意管道中节点的输入和输出所使用的名称。就像乐高积木一样,我们可以灵活地引用数据目录中的不同数据集定义——当然,首先从我们之前创建的包含原始客户数据的数据集开始。
要使所有功能正常运行,还需要完成最后几个配置步骤。用于数据划分节点的测试集比例,已定义为需要传入的参数。在Kedro中,我们通过将这些“外部”参数添加到“conf/base/parameters.yml”文件来定义它们。在这个目前为空的配置文件中,添加以下内容:
test_fraction: 0.2
此外,默认情况下,Kedro项目会隐式导入PySpark库的模块,而我们实际上并不需要这些模块。在“src”子目录下的“settings.py”文件中,我们可以通过注释并修改现有代码的前几行来禁用它,如下所示:
# 实例化的项目钩子。
# from churn_predictor.hooks import SparkHooks  # noqa: E402

# 钩子按后进先出(LIFO)顺序执行。
HOOKS = ()
保存所有更改,确保你的运行环境中已安装pandas,然后准备从IDE终端运行项目:
kedro run
首次运行可能成功,也可能失败,具体取决于安装的Kedro版本。如果运行失败并出现“DatasetError”错误,可能的解决方案是执行“pip install kedro-datasets”或“pip install pyarrow”(或两者都执行),然后再次尝试运行。
顺利的话,你会看到一系列“INFO”信息,告知你数据工作流程的不同阶段——这是一个好迹象。在“data/02_intermediate”目录中,你会找到多个包含数据处理结果的Parquet文件。
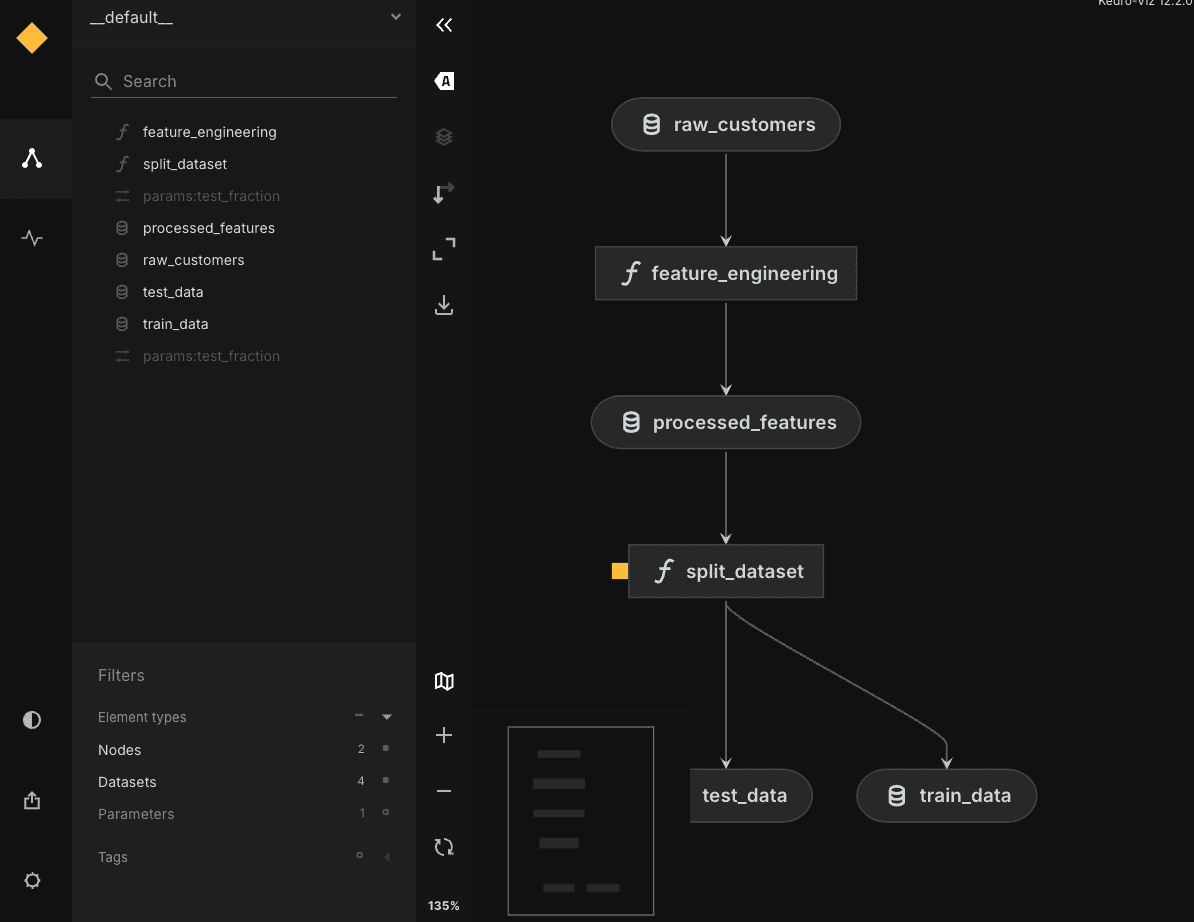
最后,你可以选择执行“pip install kedro-viz”并运行“kedro viz”,在浏览器中打开你的工作流程交互式图表,如下所示:
总结
我们将在未来的文章中进一步探索这个工具的更多功能。如果你能看到这里,说明你已经成功构建了第一个Kedro项目,并了解了其核心组件和功能,以及它们之间的交互方式。
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802022788号






