


 发帖

 雷达卡



引言
当你解决了足够多的面试类数据问题后,会发现一个有趣的现象:数据集的“形状”会悄悄决定你的编码风格。时间序列表会促使你使用窗口函数;星型模型会推动你使用连接链和GROUP BY(分组);涉及两个Datafr ame的pandas任务则几乎必然会用到.merge()(合并)和isin()(包含判断)方法。
本文将把这种直觉性的认知转化为可量化的结论。通过一系列具有代表性的SQL和pandas问题,我们将识别基本的代码结构特征(CTE的使用频率、窗口函数的使用情况、常见的pandas技巧等),并说明哪些特征会占主导地位及其背后的原因。
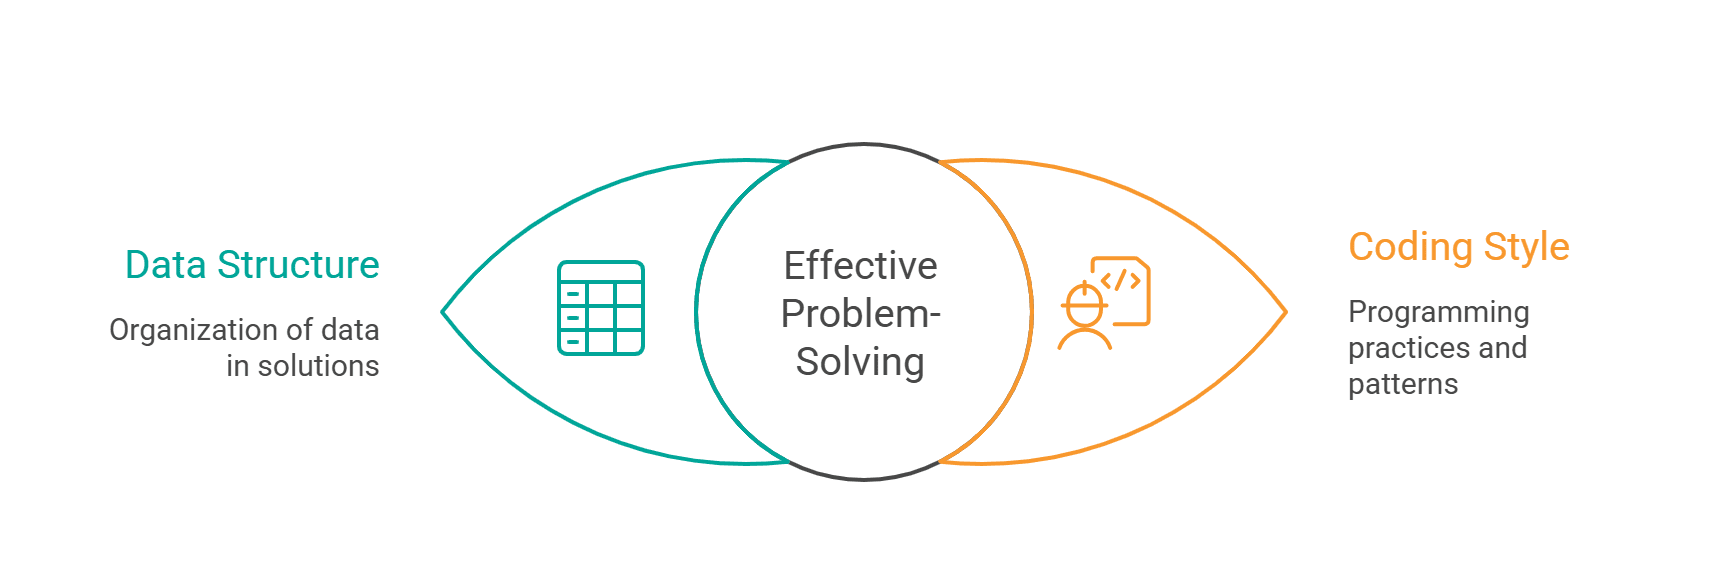
数据结构为何会改变编码风格
数据问题不仅仅关乎逻辑,更像是包裹在表格中的一系列约束条件,主要体现在以下几个方面:
依赖其他行的行(时间、排名、“前一个值”)
如果每一行的答案都依赖于相邻行(例如:昨天的温度、上一笔交易、累计总额),解决方案自然会倾向于使用窗口函数,如LAG()(前一个值)、LEAD()(后一个值)、ROW_NUMBER()(行号)和DENSE_RANK()(密集排名)。
例如,来看这道面试题中的表格:
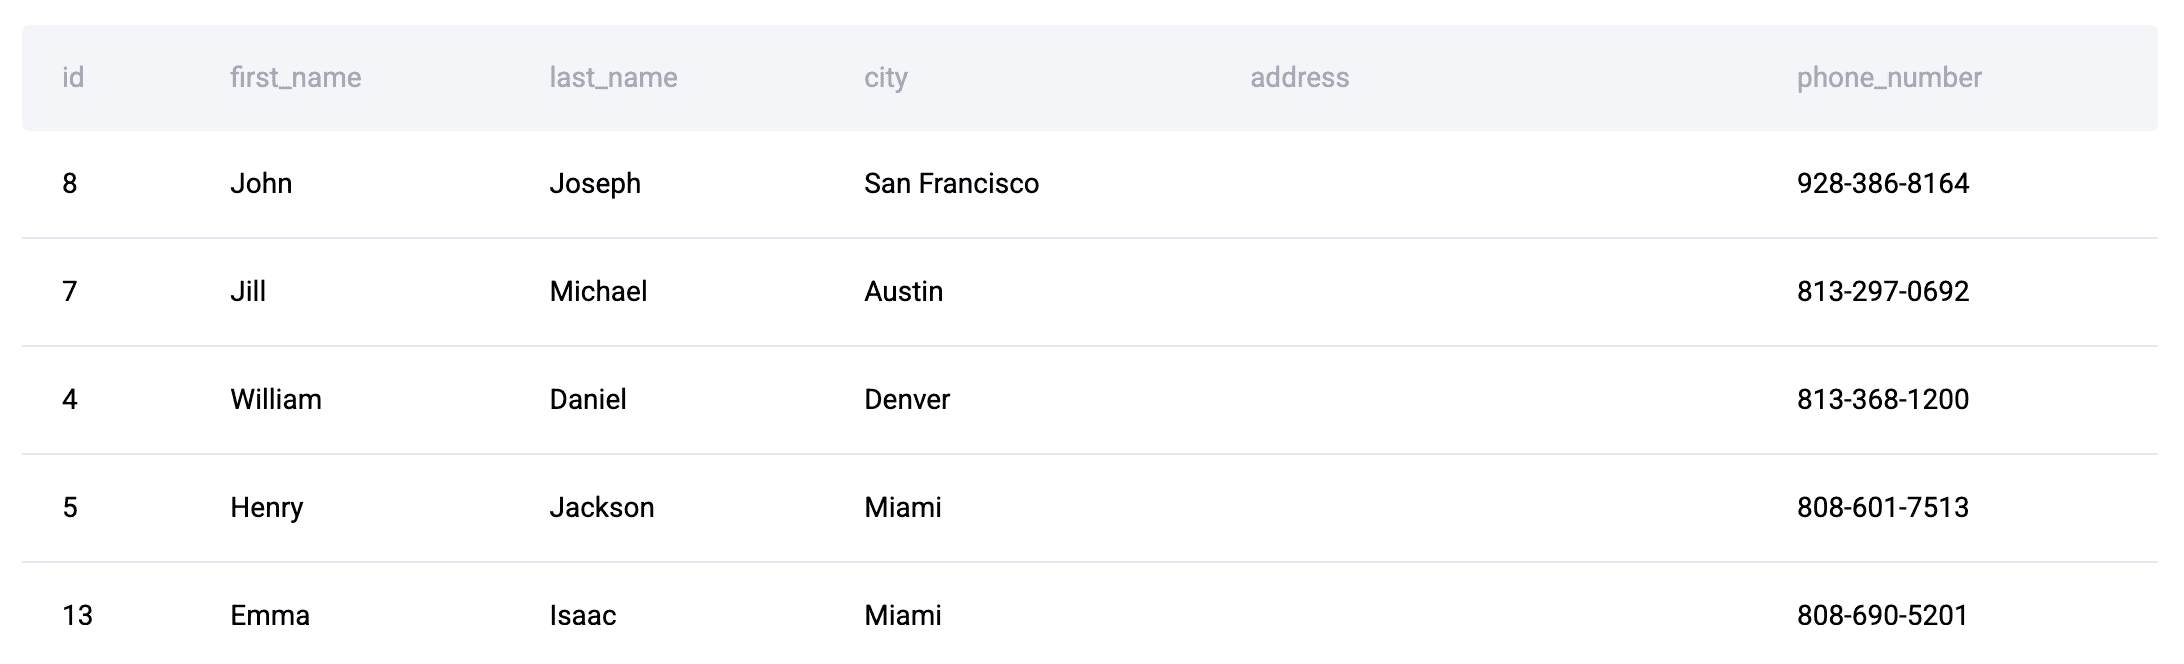
某客户在某一天的结果无法通过孤立分析确定。在按客户-日期维度聚合订单成本后,必须将每一行与同一天其他客户的结果进行比较,才能确定哪个总额最高。
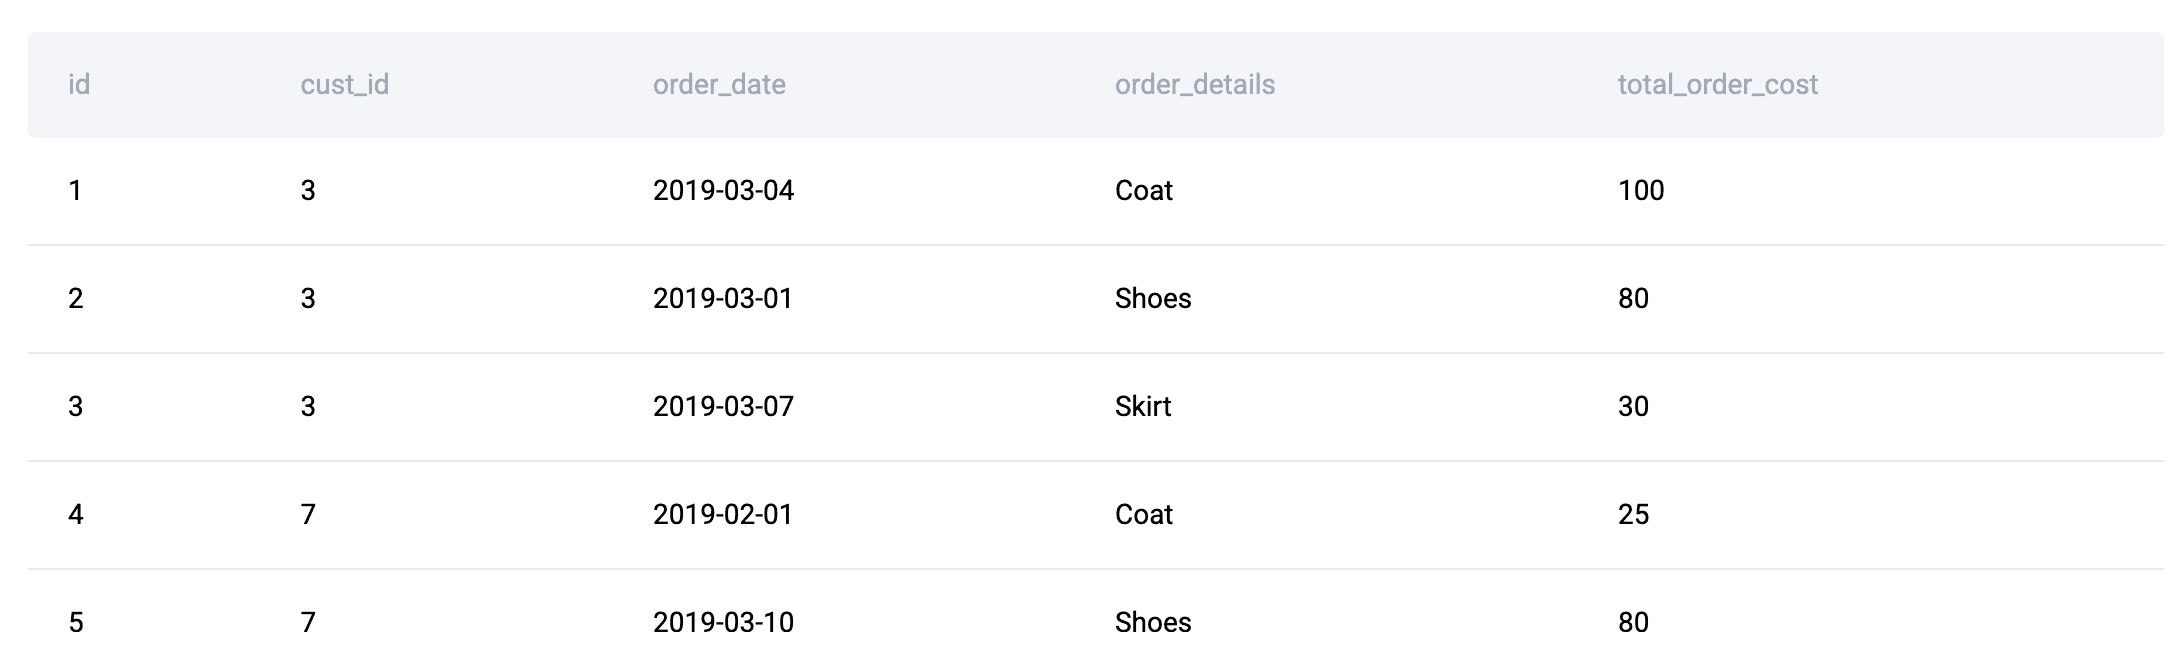
由于某一行的答案取决于它在同一时间分区内相对于其他行的排名,这种数据集形状自然会导向使用RANK()(排名)或DENSE_RANK()等窗口函数,而不仅仅是简单的聚合操作。
具有角色分工的多表(维度表与事实表)
当一个表描述实体(维度表),另一个表描述事件(事实表)时,解决方案往往会采用“JOIN + GROUP BY”模式(SQL)或“.merge() + .groupby()”模式(pandas)。
例如,在这道面试题中,数据表如下:
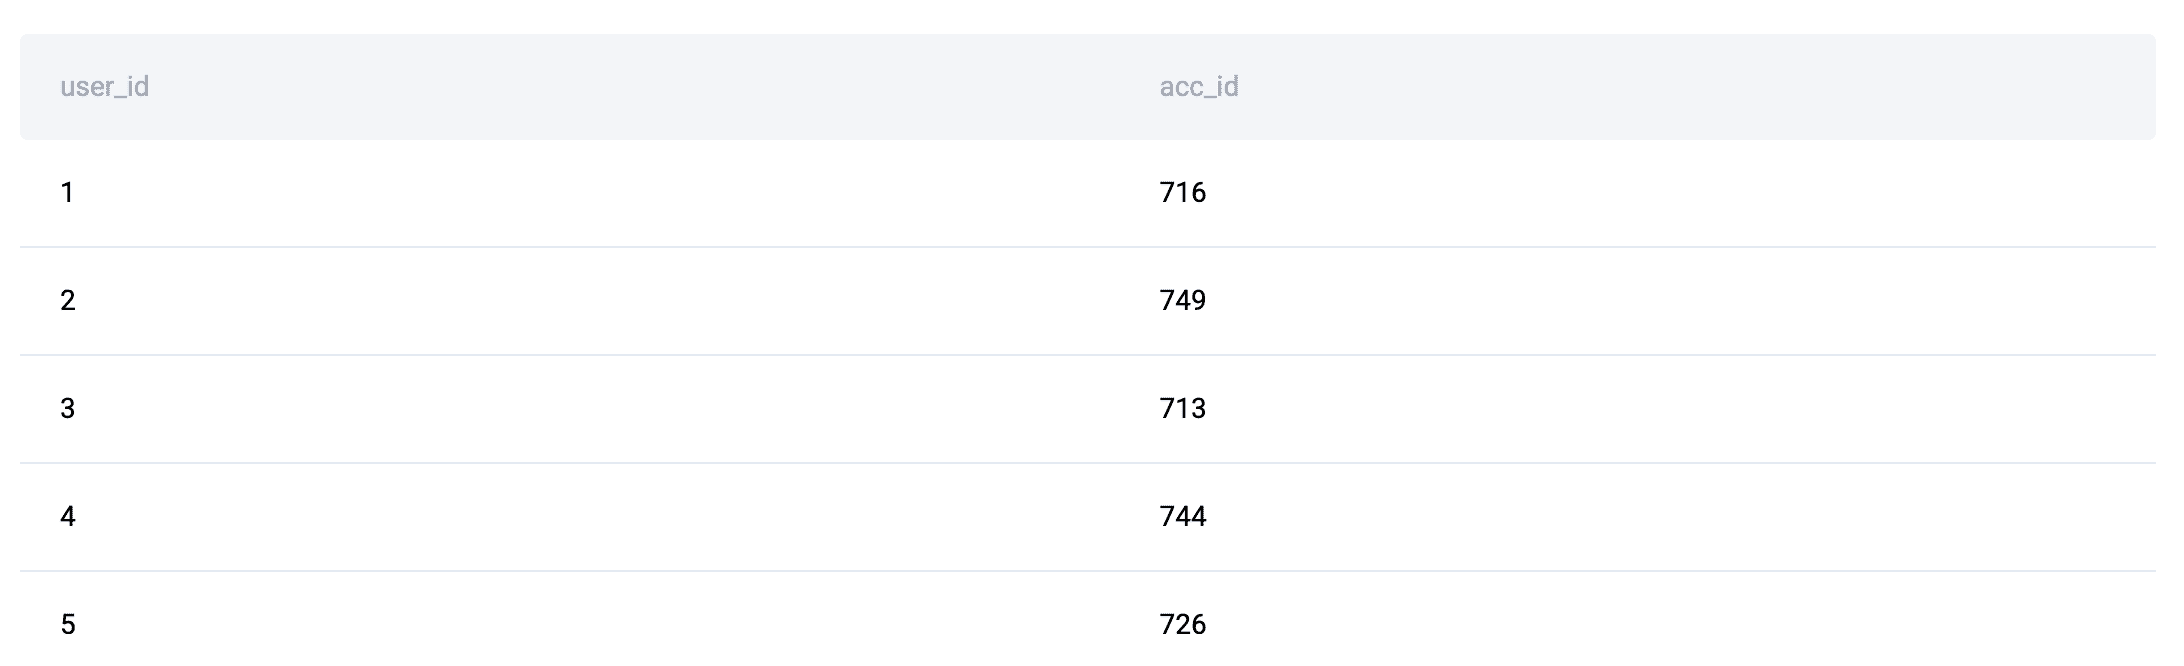
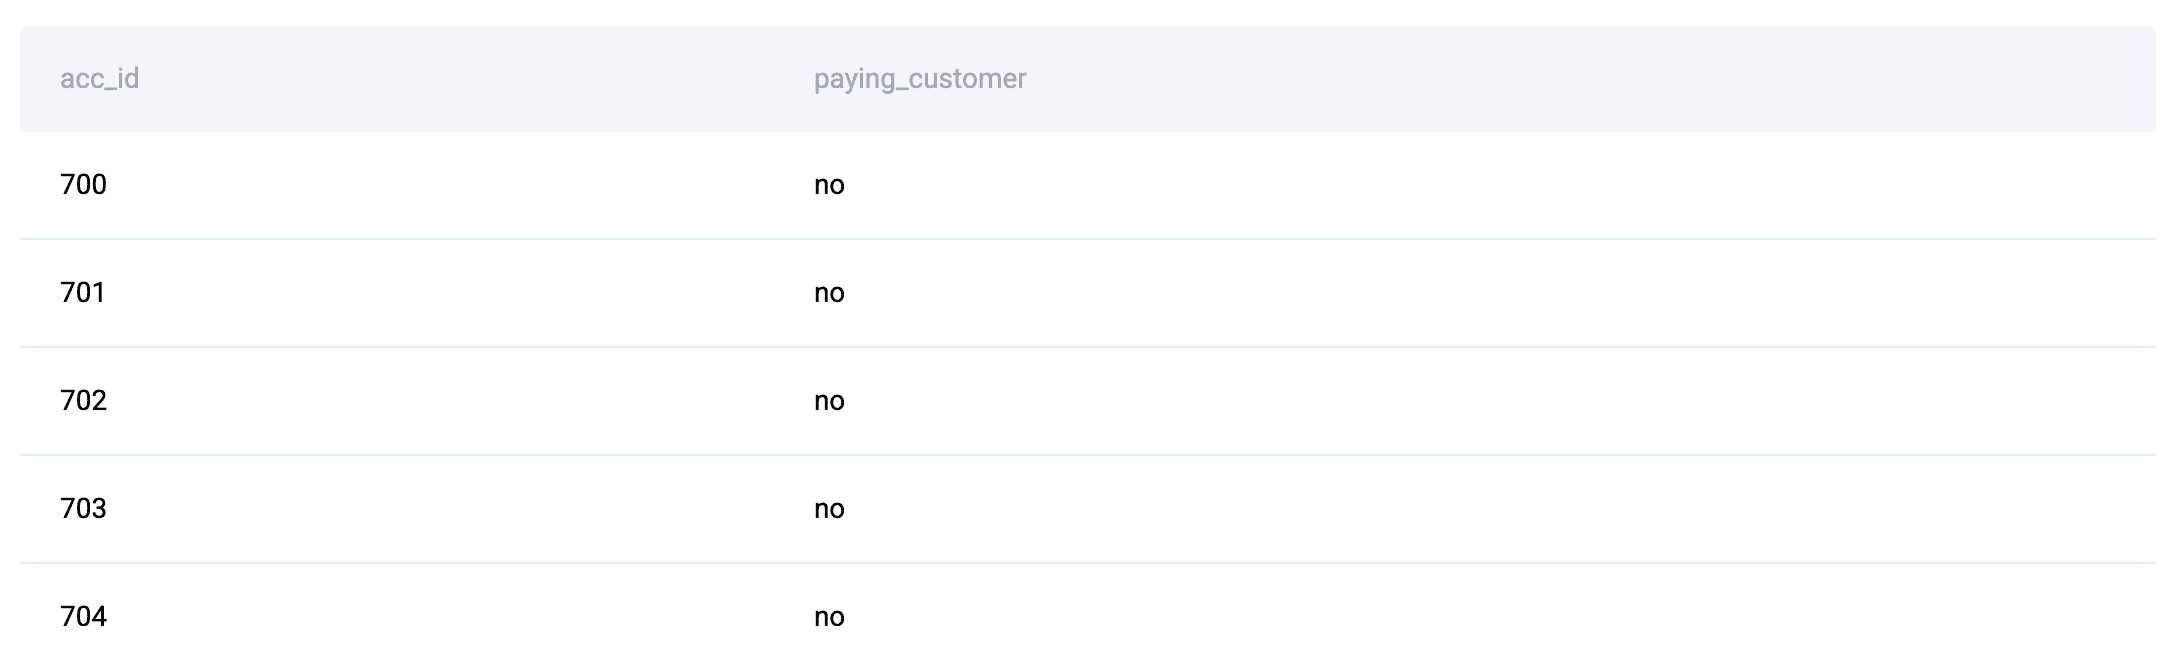
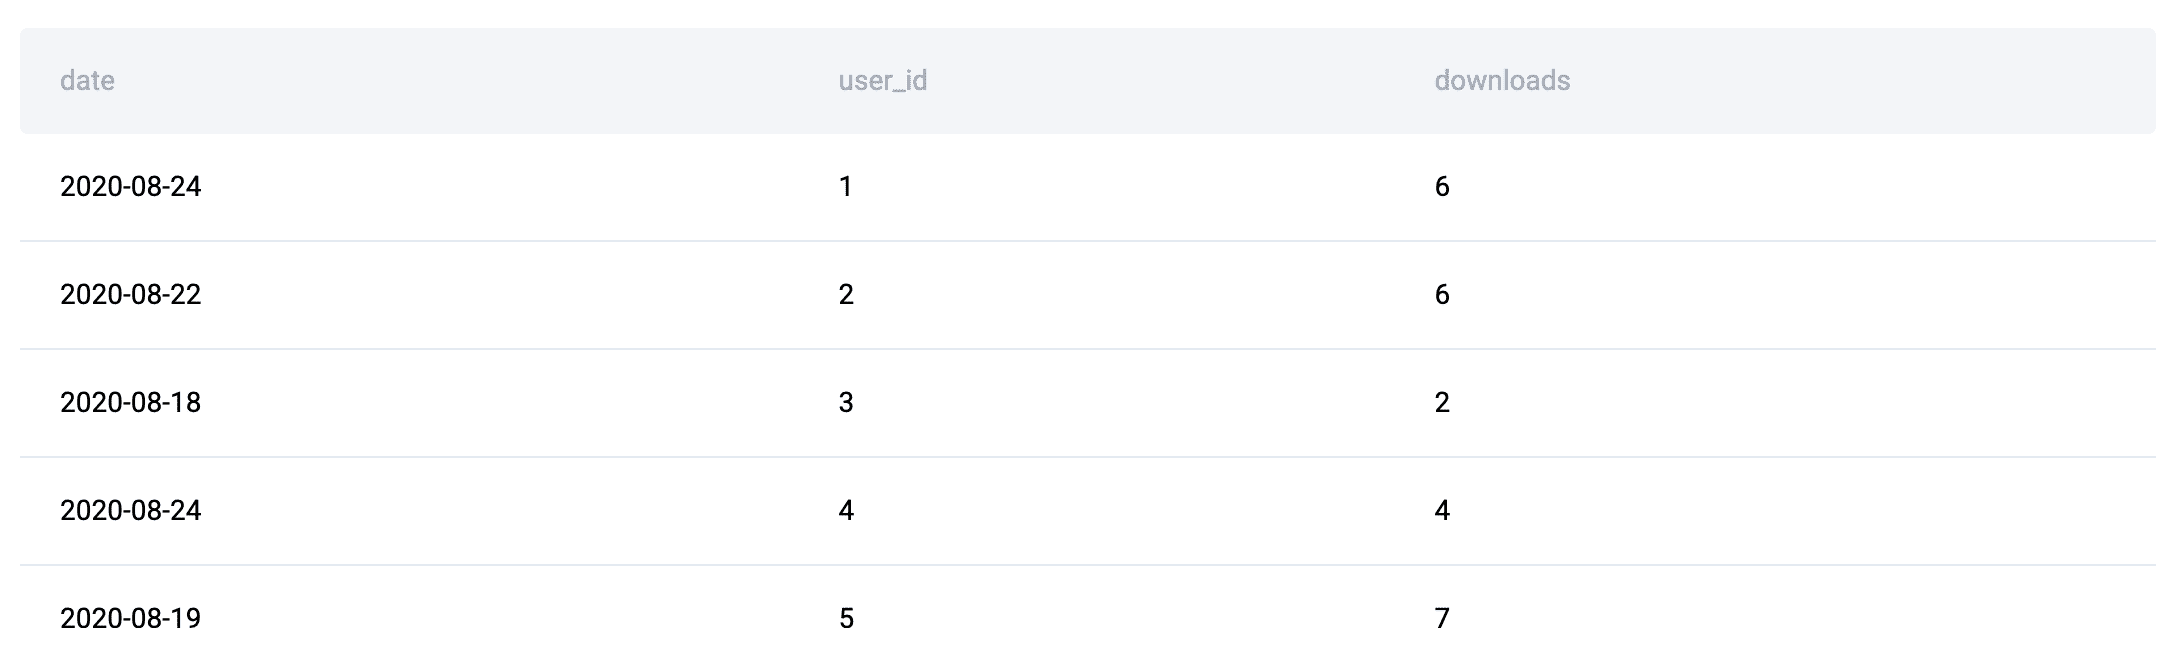
在这个示例中,由于实体属性(用户和账户状态)与事件数据(下载记录)是分离的,逻辑上必须先通过JOIN(连接)将它们重组,然后才能进行有意义的聚合(这正是维度表的作用)。这种事实模式就催生了“JOIN + GROUP BY”的解决方案。
包含排除逻辑的小体量输出(反连接模式)
诸如“谁从未做过X”这类问题,通常会转化为“LEFT JOIN ... IS NULL”(左连接+空值判断)或“NOT EXISTS”(不存在)(SQL),或“~df['col'].isin(...)”(pandas中取反的包含判断)。
我们的测量对象:代码结构特征
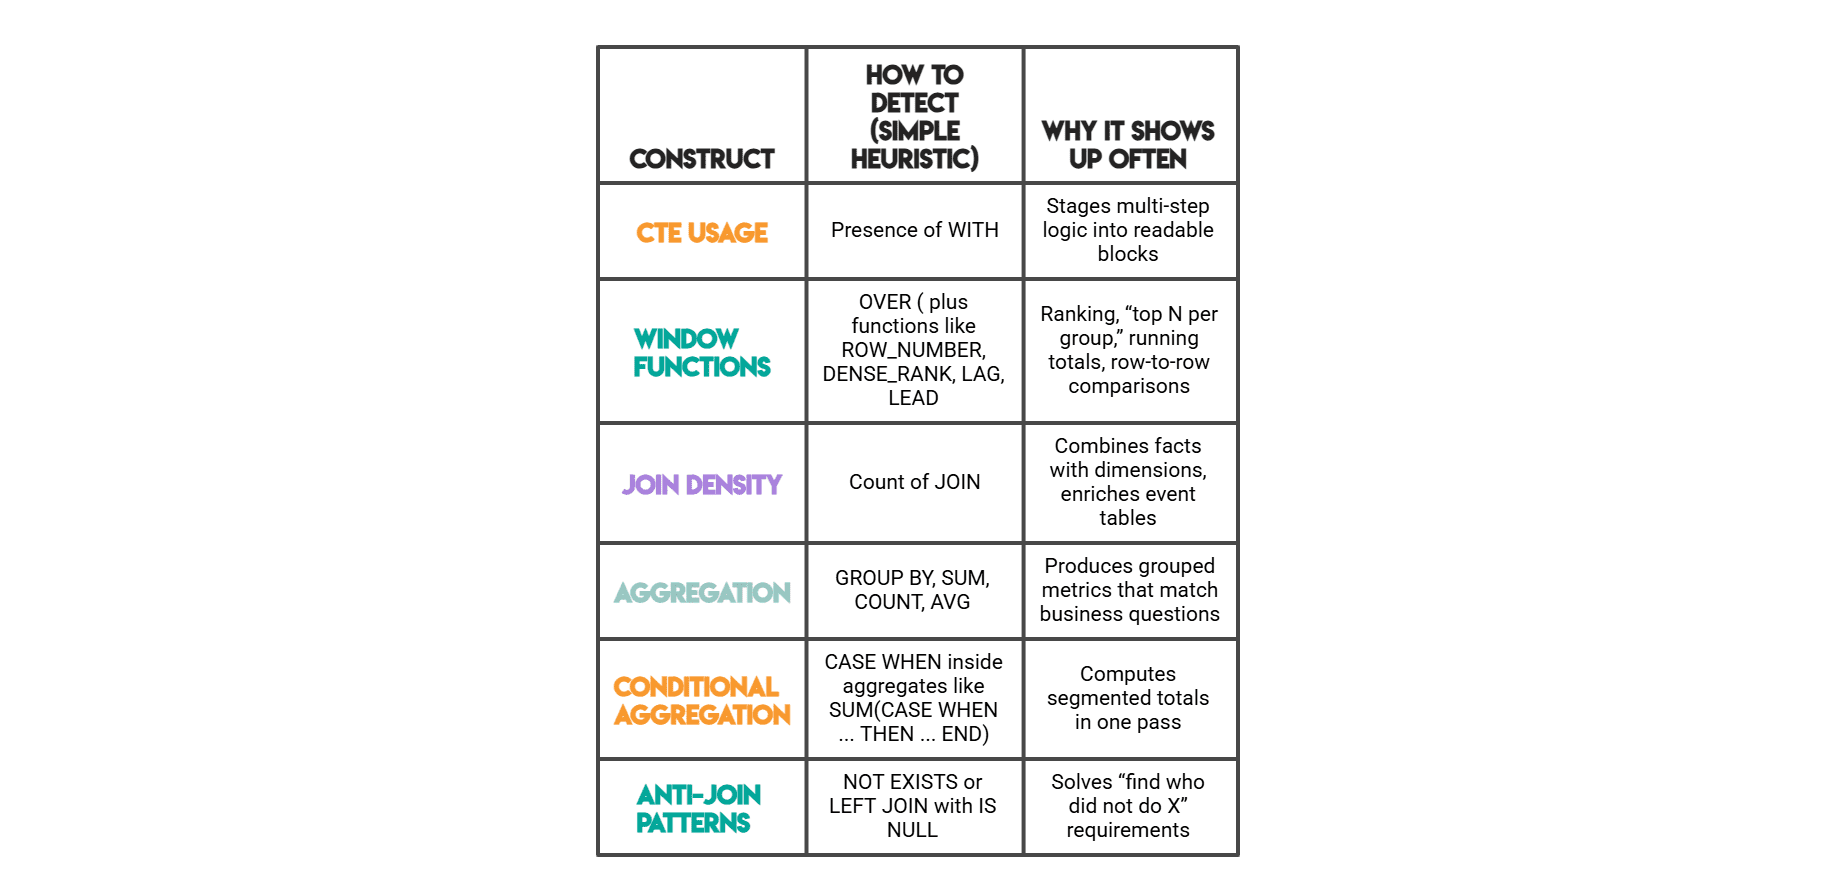
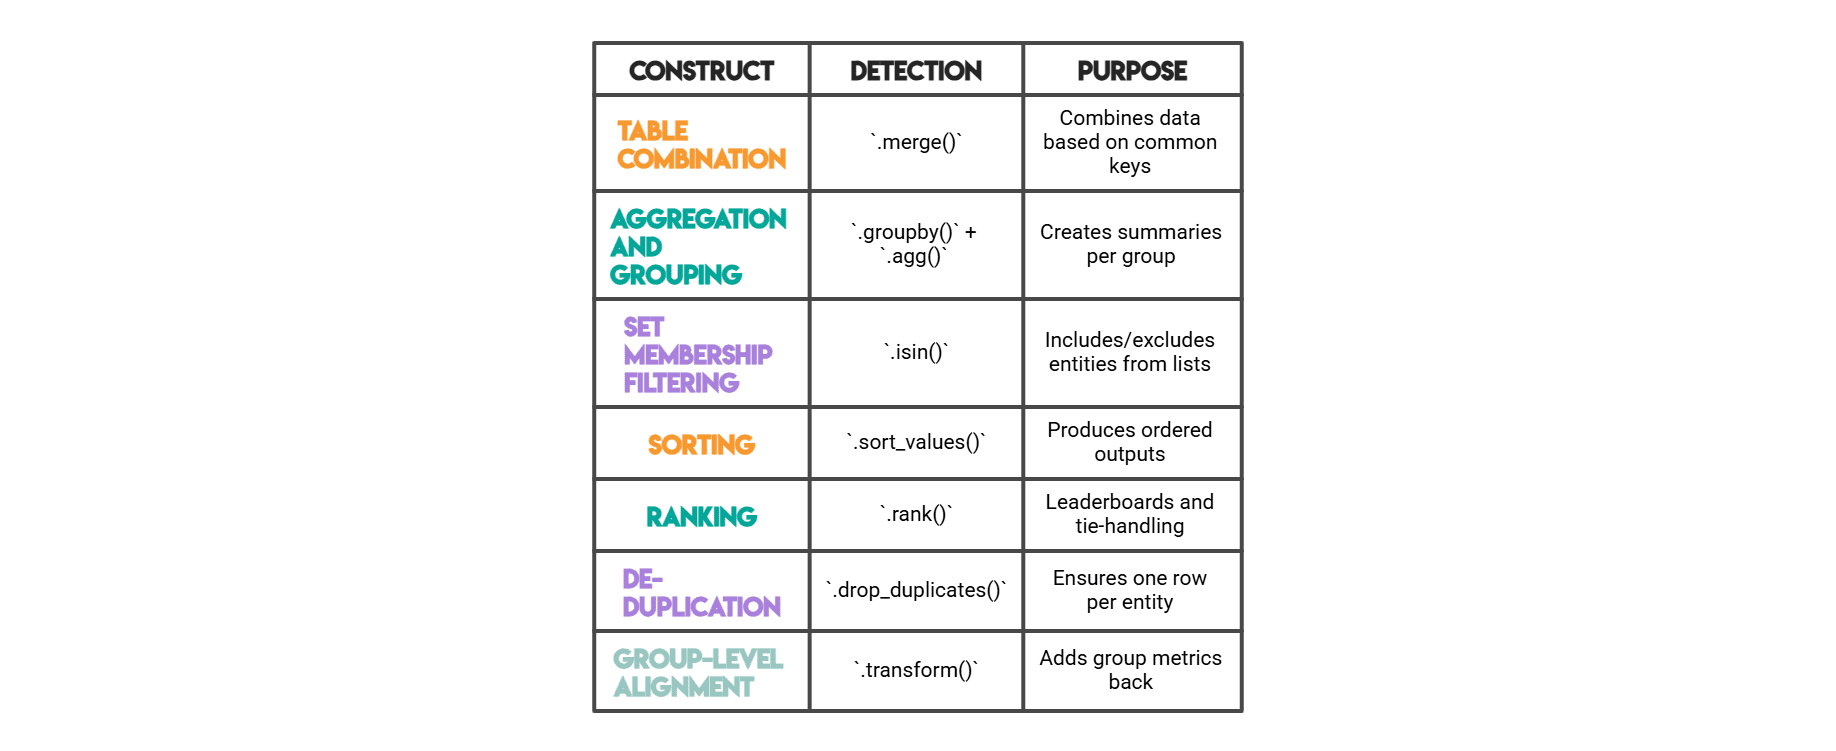
为了比较不同解决方案的“编码风格”,我们需要确定一组可从SQL文本和Python代码中提取的可观察特征。
这些特征可能无法完美反映解决方案的质量(例如:正确性或效率),但它们可以作为可靠的信号,反映分析师与数据集的交互方式。
我们测量的SQL特征
我们测量的pandas特征
哪些结构最常见
要超越轶事性观察并量化这些模式,需要一种更直接、一致的方法,从解决方案代码中直接提取结构信号。
为了让这个工作流程有具体的支撑,我们使用了StrataScratch平台上所有的教学类问题。
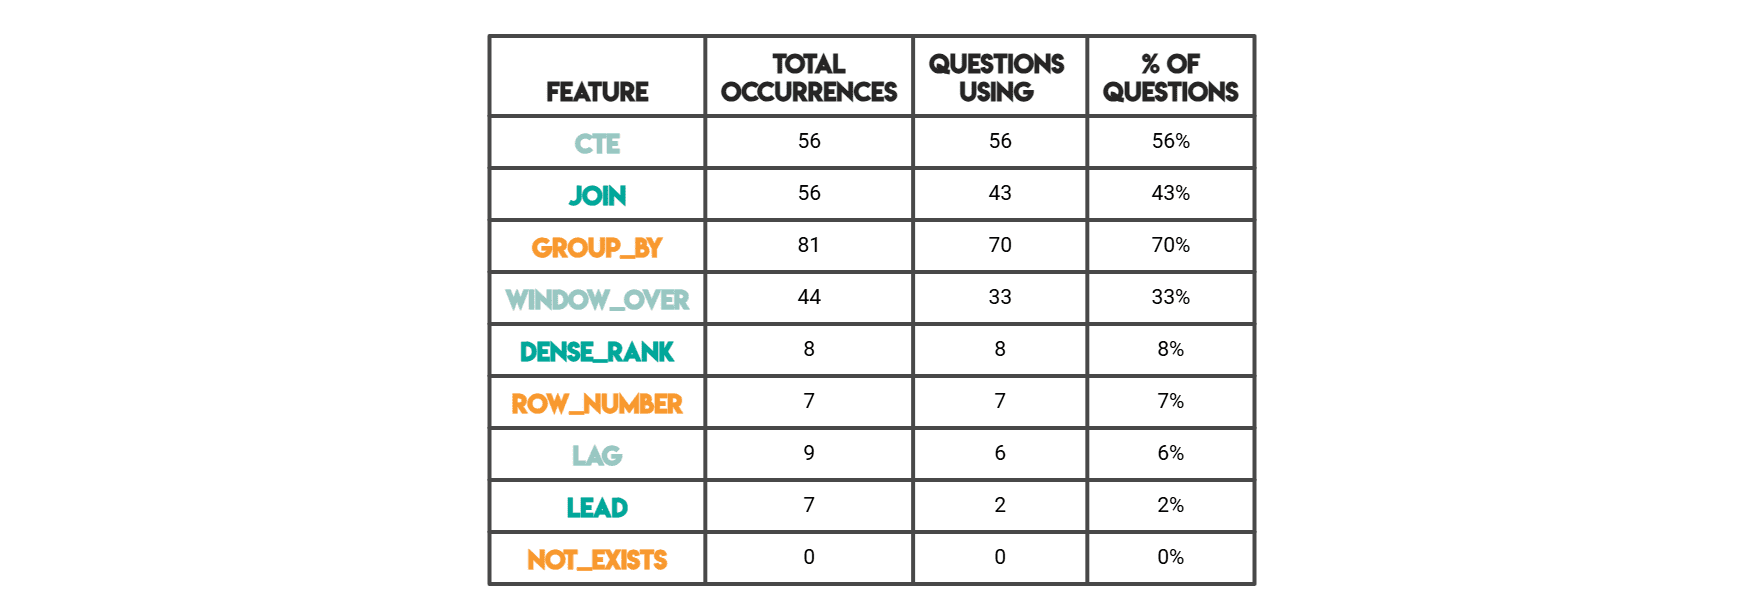
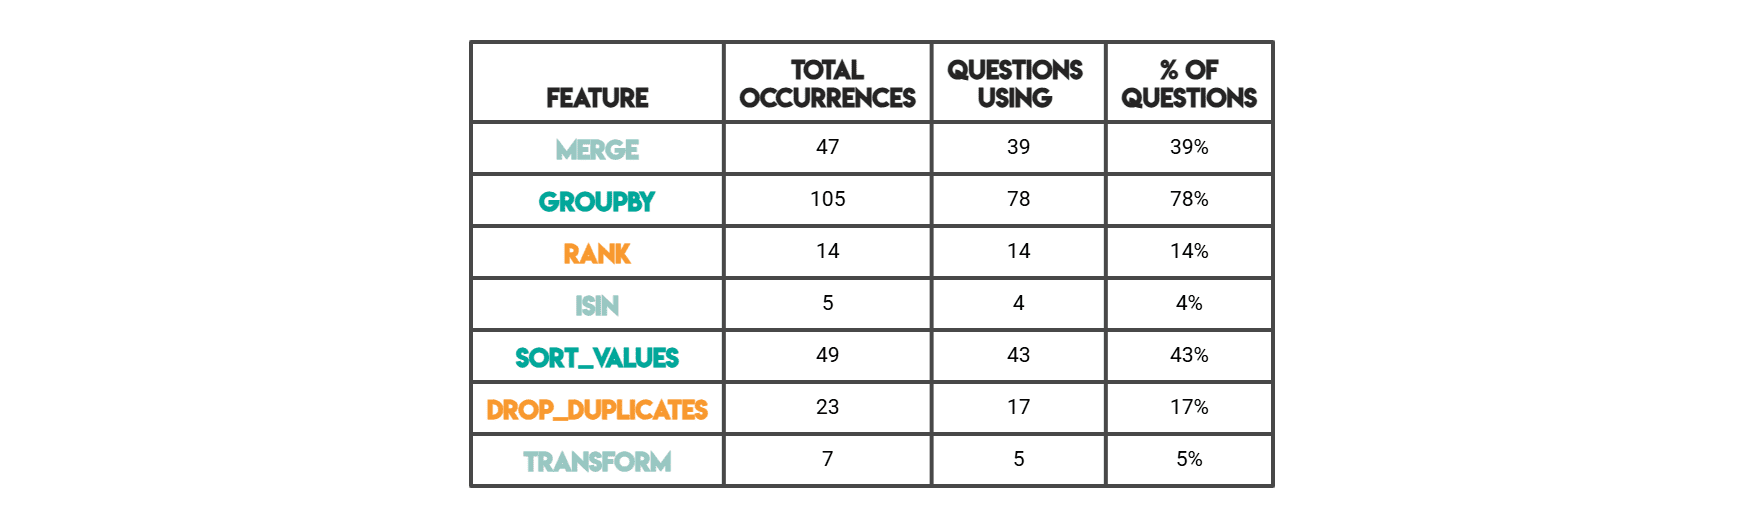
在下方的结果中,“总出现次数”是该模式在所有代码中出现的原始次数(例如:一道题的解决方案可能使用3次JOIN,这3次都会被计入);“涉及问题数”指至少使用过该特征的不同问题数量(即每个问题按“使用/未使用”二元统计)。
这种方法将每个解决方案简化为一组有限的可观察特征,使我们能够一致、可复现地比较不同问题的编码风格,并将数据集结构与主导结构直接关联起来。
SQL特征统计
pandas特征统计(Python解决方案)
特征提取代码
以下是我们使用的代码片段,你可以将其应用于自己的解决方案(或用自己的语言重新表述答案),从代码文本中提取特征。
SQL特征提取(示例)
import re
from collections import Counter

sql = # 在此处插入代码

SQL_FEATURES = {
    "cte": r"\bWITH\b",
    "join": r"\bJOIN\b",
    "group_by": r"\bGROUP\s+BY\b",
    "window_over": r"\bOVER\s*\(",
    "dense_rank": r"\bDENSE_RANK\b",
    "row_number": r"\bROW_NUMBER\b",
    "lag": r"\bLAG\b",
    "lead": r"\bLEAD\b",
    "not_exists": r"\bNOT\s+EXISTS\b",
}

def extract_sql_features(sql: str) -> Counter:
    sql_u = sql.upper()
    return Counter({k: len(re.findall(p, sql_u)) for k, p in SQL_FEATURES.items()})
pandas特征提取(示例)
import re
from collections import Counter

pandas = # 在此处粘贴代码

PD_FEATURES = {
    "merge": r"\.merge\s*\(",
    "groupby": r"\.groupby\s*\(",
    "rank": r"\.rank\s*\(",
    "isin": r"\.isin\s*\(",
    "sort_values": r"\.sort_values\s*\(",
    "drop_duplicates": r"\.drop_duplicates\s*\(",
    "transform": r"\.transform\s*\(",
}

def extract_pd_features(code: str) -> Counter:
    return Counter({k: len(re.findall(p, code)) for k, p in PD_FEATURES.items()})
接下来,我们详细谈谈我们观察到的模式。
SQL使用频率亮点
“每日最高值”和支持并列排名的任务中,窗口函数使用激增
例如,在这道面试题中,要求我们计算每日每个客户的总额,然后选择每天的最高值(包括并列情况)。这种需求自然会导向使用RANK()或DENSE_RANK()等窗口函数,并按日期分段。
解决方案如下:
WITH customer_daily_totals AS (
  SELECT
    o.cust_id,
    o.order_date,
    SUM(o.total_order_cost) AS total_daily_cost
  FROM orders o
  WHERE o.order_date BETWEEN '2019-02-01' AND '2019-05-01'
  GROUP BY o.cust_id, o.order_date
),
ranked_daily_totals AS (
  SELECT
    cust_id,
    order_date,
    total_daily_cost,
    RANK() OVER (
      PARTITION BY order_date
      ORDER BY total_daily_cost DESC
    ) AS rnk
  FROM customer_daily_totals
)
SELECT
  c.first_name,
  rdt.order_date,
  rdt.total_daily_cost AS max_cost
FROM ranked_daily_totals rdt
JOIN customers c ON rdt.cust_id = c.id
WHERE rdt.rnk = 1
ORDER BY rdt.order_date;
这种“先聚合,再按日期排名”的两步法,说明了为什么窗口函数非常适合“每组最高值”且需要保留并列情况的场景,也解释了为什么单纯的GROUP BY逻辑无法满足需求。
当问题涉及分步计算时,CTE的使用会增加
CTE(公共表表达式)(或多个CTE)可以使每个步骤清晰可读,并且更容易验证中间结果。
这种结构也反映了分析师的思考方式:将数据准备与业务逻辑分离,使查询更易于理解、调试,并能根据需求变化进行调整。
“JOIN + 聚合”成为多表业务指标的默认模式
当度量值位于一个表、维度位于另一个表时,通常无法避免使用JOIN子句。连接完成后,GROUP BY(分组)和条件总额(SUM(CASE WHEN ... THEN ... END))通常是最简洁的实现路径。
pandas方法亮点
只要答案依赖多个表,就会出现.merge()(合并)
这道面试题就是pandas模式的典型示例。当行程数据与支付或折扣逻辑分布在不同的列和表中时,通常需要先合并数据,然后再进行计数或比较。
import pandas as pd
orders_payments = lyft_orders.merge(lyft_payments, on='order_id')
orders_payments = orders_payments[(orders_payments['order_date'].dt.to_period('M') == '2021-08') & (orders_payments['promo_code'] == False)]
grouped_df = orders_payments.groupby('city').size().rename('n_orders').reset_index()
result = grouped_df[grouped_df['n_orders'] == grouped_df['n_orders'].max()]['city']
表合并完成后,解决方案的其余部分就简化为常见的.groupby()(分组)和比较步骤,这也凸显了在pandas中,初始的表合并如何简化后续逻辑。
这些模式反复出现的原因
基于时间的表通常需要窗口逻辑
当问题涉及“每日总额”、“日期间比较”或“每天最高值选择”时,通常需要有序逻辑。因此,带有OVER(分区)的排名函数很常见,尤其是在需要保留并列情况时。
多步骤业务规则适合分步实现
有些问题混合了过滤规则、连接和计算指标。虽然可以将所有逻辑写入单个查询,但这会增加阅读和调试的难度。CTE通过将数据增强与聚合分离,使验证更简单,这与“高级版vs免费版”(Premium vs Freemium)模型的思路一致。
多表问题自然会增加连接密度
如果一个指标依赖于存储在不同表中的属性,就必须进行连接。表合并后,分组汇总就是自然而然的下一步。这种整体模式在StrataScratch平台上那些混合事件数据和实体档案的问题中反复出现。
实用收获:更快、更简洁的解决方案
如果输出结果依赖于有序行,可优先使用ROW_NUMBER()或DENSE_RANK()等窗口函数;
如果问题要求“先计算A,再根据A计算B”,使用WITH块(CTE)通常能提高清晰度;
如果数据集分散在多个实体中,提前规划JOIN(连接),并在编写最终SELECT(查询)前确定分组键;
在pandas中,当逻辑涉及多个Datafr ame时,将.merge()(合并)作为默认选择,然后通过.groupby()(分组)和清晰的过滤构建指标。
结论
编码风格遵循数据结构:基于时间和“每组最高值”的问题往往会用到窗口函数;多步骤业务规则往往会用到CTE;
多表指标会增加JOIN(连接)的使用频率,而pandas则通过.merge()(合并)和.groupby()(分组)反映了这些相同的操作模式。
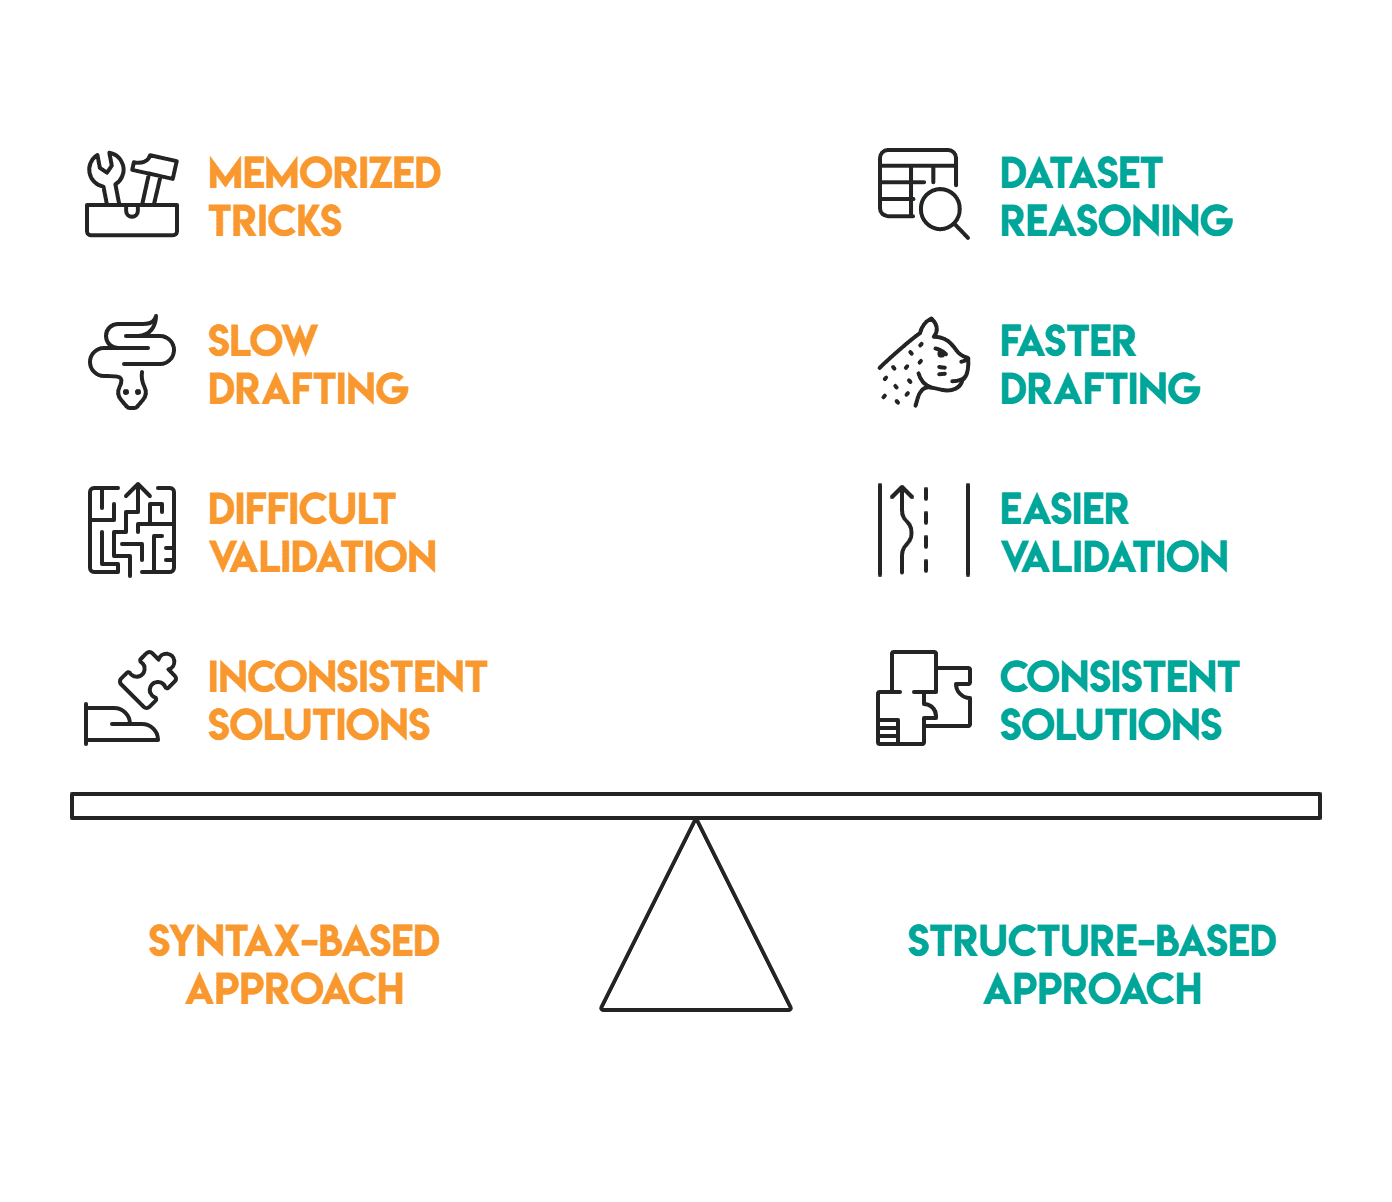
更重要的是,尽早识别这些结构模式,可以显著改变你解决新问题的方法。你不再需要从语法或记忆的技巧入手,而是可以从数据集本身进行推理:这是“每组最大值”问题吗?是多步骤业务规则吗?是多表指标吗?
这种思维方式的转变,能让你在编写任何代码之前就预判出主要框架。最终,这会加快解决方案的起草速度,简化验证过程,并使SQL和pandas代码更加一致——因为你是在响应数据结构,而不仅仅是问题文本。
一旦你学会识别数据集的形状,就能尽早预判主导结构。这会让解决方案的编写更快、调试更简单,并且在面对新问题时更具一致性。
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802022788号






