


 发帖

 雷达卡



故事渐入佳境
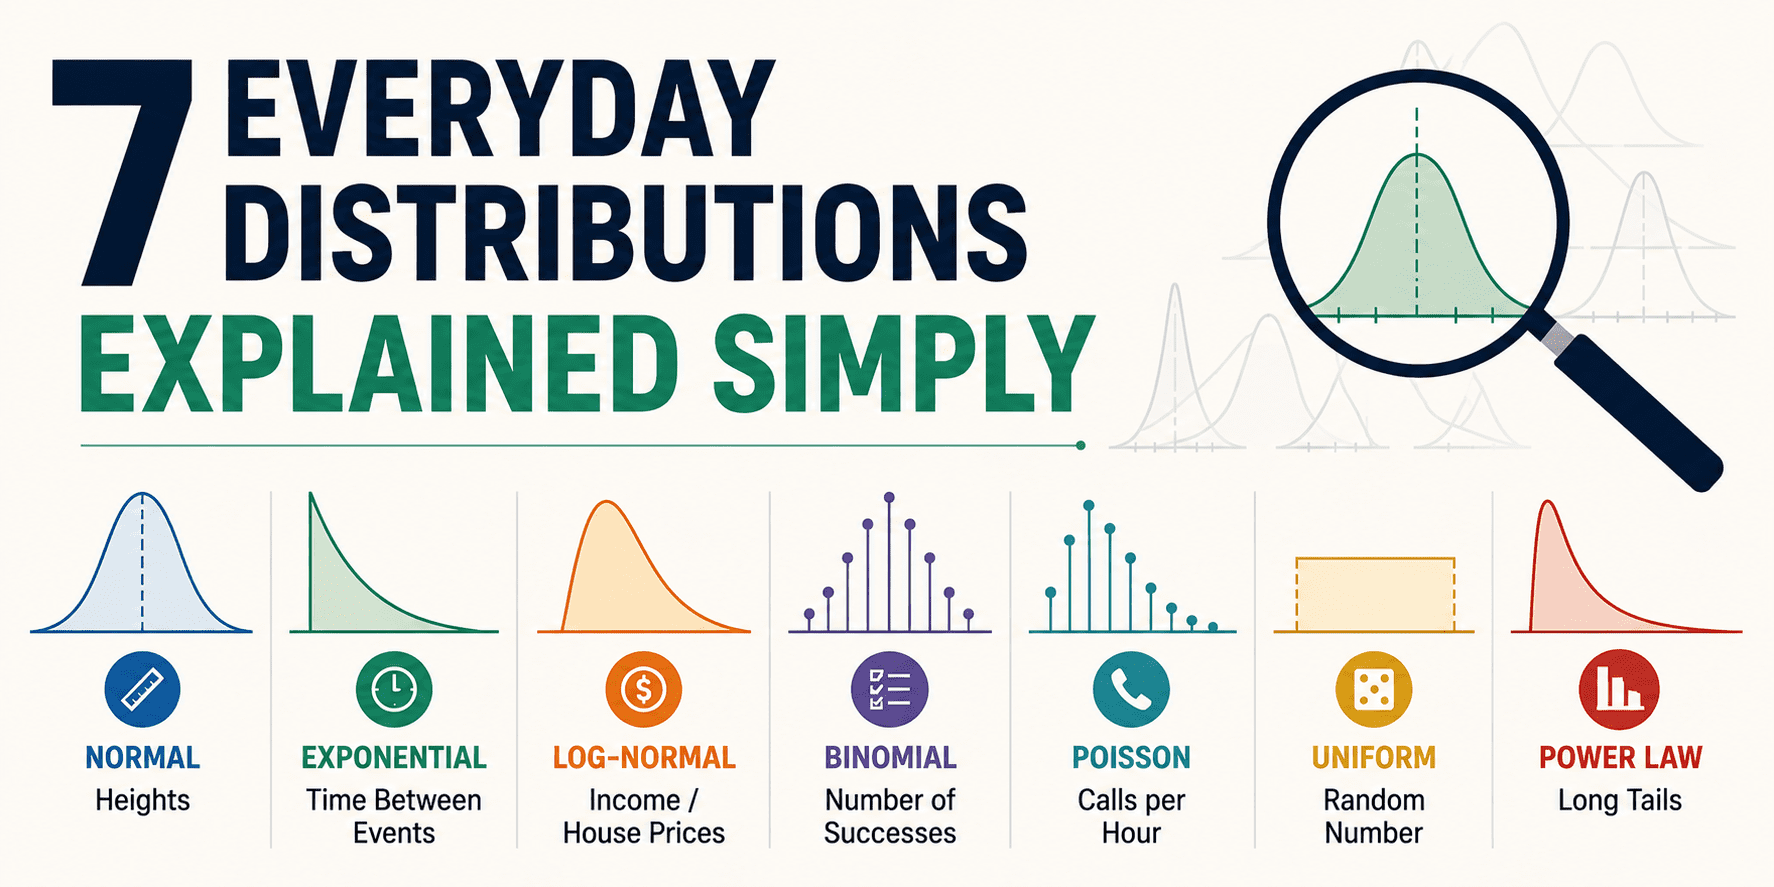
你可能听过有人说“这是正态分布”,说得像一句能解释一切的魔咒。事实上,分布不过是描述数字在现实生活中呈现规律的“故事”——有些故事是平滑的曲线,有些是起伏的块状,还有些本质上就是包装更精致的抛硬币游戏。
本文将带你快速了解7种日常分布,一旦掌握识别方法,你会发现它们在生活中随处可见。无需复杂数学,拒绝专业壁垒,只希望让你恍然大悟:“哦,原来这些数字会这样变化是有原因的。”一旦开始发现这些规律,统计学就不再是一门枯燥的学科,而会变成你解读世界的“作弊码”。
1. 正态分布
“大多数事物集中在中间”的曲线
正态分布是经典的钟形曲线,当一个数值受到许多微小、独立的因素影响(这些因素或使其升高、或使其降低)时,就会呈现这种分布。可以把它想象成一个团队项目:每个人都贡献一点力量,最终结果大多时候都会接近平均值。
日常示例:
特定年龄和人群的身高、微小的测量误差、大群体的考试成绩,以及如果你每天生活比较规律,“回复一封邮件需要的时间”。
它之所以被称为“正态”,核心在于其对称性:大多数数值都集中在中间区域,离中心越远,数值出现的概率就越低。当人们说“偏离两个标准差”时,其实就是在说“对于这个钟形曲线来说,这种情况相当罕见”。
2. 均匀分布
“所有结果概率均等”的模式
均匀分布是一种不偏不倚的分布——某个范围内的每一种结果,出现的概率都是相同的。
完美的示例通常是人为创造的:
掷一枚公平的骰子、从洗匀的牌堆中随机抽一张牌、生成0到1之间的随机数,或是转动等分的抽奖转盘。
在现实生活中,真正的均匀分布很少见,因为世界本身就存在各种偏差。即便如此,它作为一种模型依然非常实用。如果你要模拟随机性,或是建立一个基准假设,均匀分布就是最简洁的“起点”分布。
此外,均匀分布分为两种类型:
离散均匀分布(如掷骰子得到1-6的点数)
连续均匀分布(如0到1之间的任意数值)
3. 二项分布
“成功次数”计数器
当你遇到以下情况时,就可以使用二项分布:
尝试次数固定
每次尝试的结果只有“是”或“否”(成功或失败)
每次尝试的成功概率保持不变
它描述的是你能获得的成功次数的分布规律。
日常示例:
100名收件人中打开你邮件的人数、20次罚球中你投中的次数、建筑工地中你佩戴个人防护装备(PPE)的次数。
二项分布本质上是一种结构化的表述方式:“给定N次尝试和概率p,最可能出现的成功次数是多少?”
它也是许多“转化率”思维背后的核心分布。当有人说“我们的注册率是8%”时,二项分布就在背后默默计算——哪些波动是正常的,哪些是值得怀疑的。
4. 泊松分布
“一段时间内事件发生次数”追踪器
当你要统计在一段时间或空间内随机发生的事件(尤其是相对罕见、相互独立的事件)时,泊松分布就是你的首选。
日常示例:
每小时的客户支持工单数量、长文档中每页的错别字数量、5分钟内经过检查站的汽车数量、流量稳定时一天的网站注册量、小型企业接到的来电数量。
泊松分布有一个非常明确的特点:它关注的是“窗口内的事件计数”——不是“事件是否发生”,而是“发生了多少次”。
它也是第一个让很多人恍然大悟的分布:“原来统计学真的能模拟这种情况?”因为它对现实中杂乱无章的事件计数,有着出人意料的预测效果。
5. 指数分布
“下一个事件发生前的等待时间”模型
如果说泊松分布统计的是“一个窗口内发生的事件次数”,那么指数分布则恰好相反,它回答的是:“下一个事件还要多久才会发生?”
一些示例包括:
下一个支持工单到达前的等待时间、队列中两次到达之间的间隔、安静的商店里下一位顾客进店前的时间、某些简化可靠性模型中系统随机故障的间隔时间。
用通俗的话来说:如果事件是以稳定的速率随机发生的,那么已经等待了10分钟,并不会让下一个事件“更该发生”。这在情感上可能让人觉得奇怪,因为人类天生喜欢寻找规律,但当潜在过程大致符合“无记忆性”时,指数分布依然是基于历史数据模拟时间间隔的有效方法。
6. 对数正态分布
“右偏、长尾”的现实检验
当一个变量是由多个因素“相乘”而非“相加”产生时,就会出现对数正态分布。这种乘法特性使得分布呈现出“大多数数值较小或中等,少数数值极大”的特点。
它的应用场景包括:
收入、许多市场的房价、项目完成时间、文件大小、网站会话时长,以及社交帖子的传播范围。
这种分布也解释了为什么“平均值”有时会具有误导性。对于对数正态数据,少数极大值会拉高平均值,即便大多数数值都集中在低得多的区间。这就是为什么在这类场景中,中位数往往能更真实地反映实际情况。
7. 幂律分布
“少数巨头,海量小分子”的模式
幂律分布是长尾分布的极端形式。当大结果虽然罕见,但并不像正态分布所预测的那样罕见时,就会呈现这种分布——它的“尾巴”始终很“厚重”。
你可以在以下场景中看到它的身影:
城市规模、社交媒体粉丝数、各网页的网站流量、各产品的销售额、某些简化模型中的财富分布,以及特定词汇在语言中的出现频率。
它的核心逻辑很简单:少数事物占据了总量的主导地位,它们的影响力远高于该领域中的大多数个体。这一点也体现在宇宙中物质的聚集趋势上——如果我们暂且忽略引力动力学、暗物质和宇宙膨胀,这也是为什么宇宙中存在广阔的虚空,而非每个区域都均匀分布着小型星系。
总结
有趣的是:要熟练运用分布,你不需要记住复杂的公式,只需学会解读数据所讲述的“故事”。
开始像这样给各种规律贴上“标签”,你的直觉会迅速变得敏锐。统计学会变成一种更接近“有依据的模式识别”的能力。
当你再看到生活中的各种数字——从收件箱的邮件动态到流量峰值——你会更清晰地判断:哪些是正常情况,哪些是随机波动,哪些才是真正值得深入探究的异常。
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802022788号






