


 发帖

 雷达卡



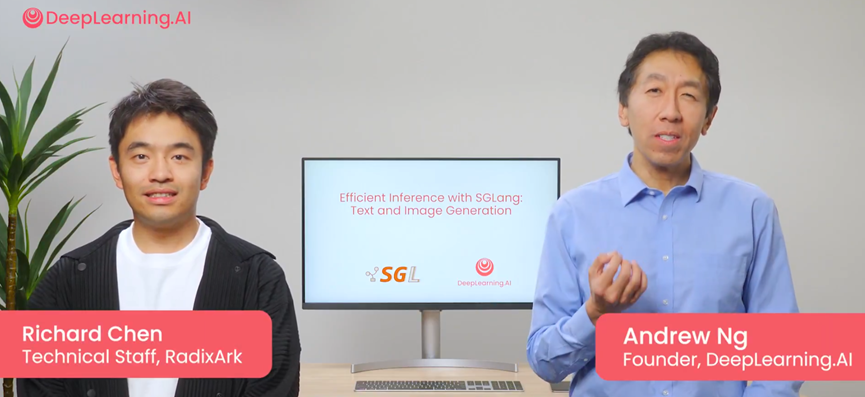
今天,全球AI大牛吴恩达又推荐新课程SGLang!
这次不是空谈理论,而是实打实教你怎么从大模型嘴里抠出算力省成本。大模型跑起来贵得离谱,罪魁祸首就是海量重复计算。
这个课直接教你上手SGLang框架的缓存黑科技,不管多少用户挤在一起,共享上下文只算一次!
不光能搞定文本的KV缓存,连扩散模型生图都能顺便提速,一套打法直接通吃。
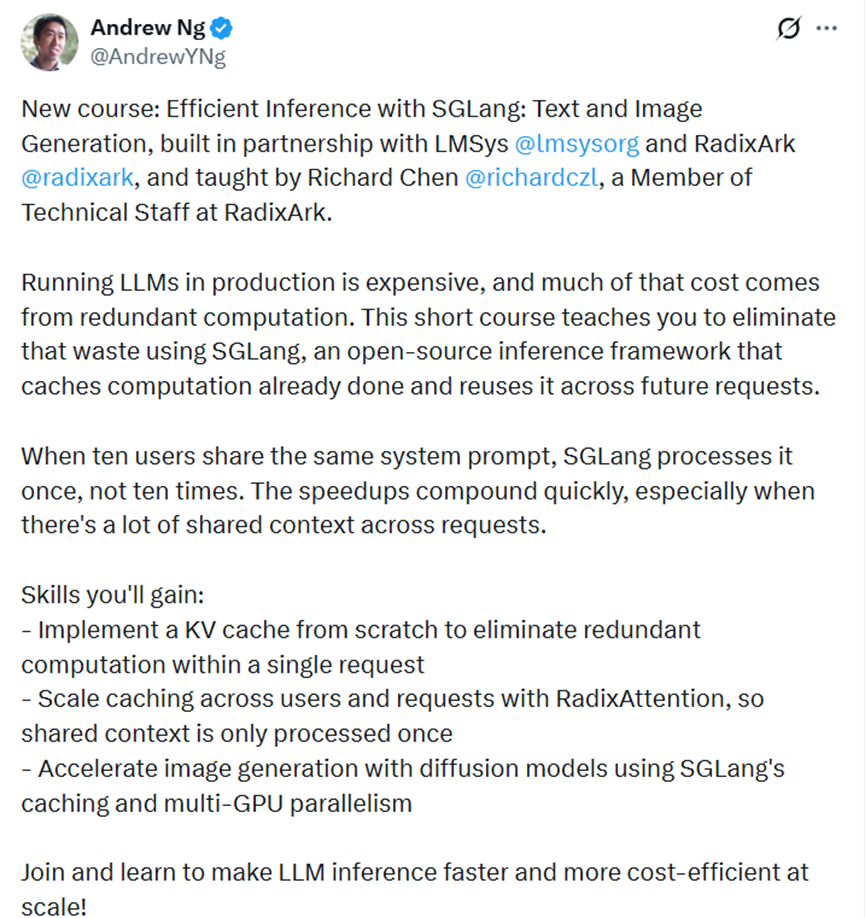
课程地址:https://www.deeplearning.ai/short-courses/efficient-inference-with-sglang-text-and-image-generation/
你能从这门课学到什么
其实做过大模型生产部署的朋友应该都有体会,大模型跑起来贵,核心问题就是冗余计算太多。
比如同一个系统提示、同一段共享上下文,每次有新请求过来,模型都得从头再算一遍,相当于做了无数次无用功,算力和时间全浪费在这了。
而SGLang这个开源推理框架,核心就是解决这个问题,把已经算完的结果存起来,后续请求直接复用,从根上把这些浪费的成本砍掉。
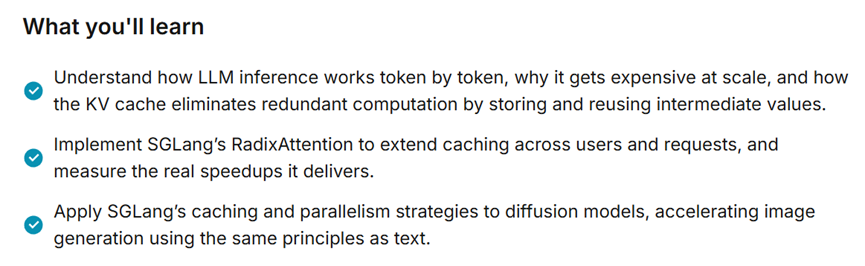
第一招:吃透底层逻辑,手搓KV缓存
彻底搞明白大语言模型逐token推理的底层逻辑,知道为啥大模型规模化部署的时候成本居高不下。
靠存储和复用中间计算值,把没必要的重复计算全砍掉,这也是大厂能用它把算力成本直接砍半的关键。
第二招:掌握核心杀手锏,基数注意力
亲手实现SGLang里的基数注意力,学会在多用户、多请求的实际场景里扩展缓存。
自动识别不同请求之间的共享前缀,同一个系统提示绝不算第二次,实测提速效果极其明显。
第三招:一套打法通吃,给图像生成提速
比较实用的是,能把SGLang的缓存和并行策略直接迁移到扩散模型上,用优化文本生成的思路,给图像生成也提提速,一套方法通吃两个场景性价比拉满。
课程主要内容介绍
入门先从大语言模型推理的基础认知开始,不绕弯子,直接讲模型怎么处理输入的token,怎么一个接一个生成输出的token,把计算成本一步步累积的过程讲透,让你先明白问题到底出在哪。
接着会从0开始教你实现注意力机制,还会手把手搭KV缓存,把注意力计算里的中间键值张量存起来反复用。
先把单请求内的冗余计算解决掉,这是基础中的基础,也是后续所有优化的前提,更是大厂实操中最常用的基础技巧。
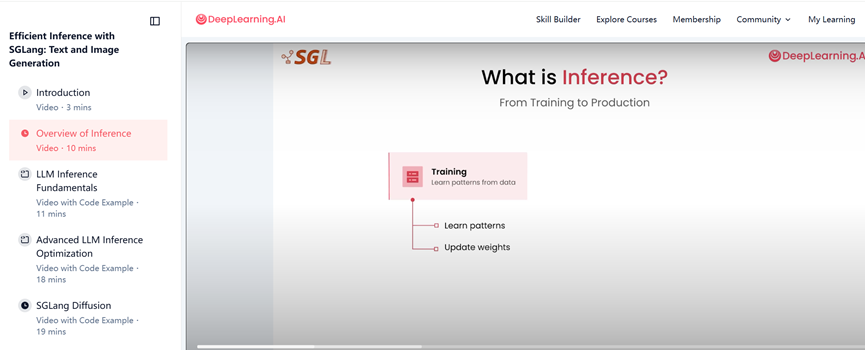
基础打牢之后,就会进阶到SGLang的核心优化点基数注意力。简单说就是用基数树的方式,自动识别不同用户、不同请求之间的共享前缀。
比如大家都用同一个系统提示的话,这部分就不用重复计算了,直接实现跨请求的KV缓存共享。
这个优化在实际的多用户部署场景里,提速效果特别明显,也是SGLang的核心竞争力之一,更是大厂能实现算力成本砍半的关键操作。
学会了文本生成的优化,课程会把这套思路迁移到图像生成上,毕竟扩散模型做图像生成的时候,也会遇到类似的计算效率问题。
这里会教你把SGLang的缓存策略应用到扩散模型中,还会讲多GPU并行的思路,让图像生成的速度再上一个台阶。
相当于把学到的方法做了一次实战迁移,确保你不是只懂理论,而是会实际应用,就像大厂里的实操场景一样,学完就能用。
最后课程还会聊一聊大语言模型推理领域的未来发展方向,讲一讲现在的新兴技术,还有这次学到的这些优化原理,怎么适配后续的技术迭代。
让你不光能解决当下的问题,还能对未来的技术趋势有个大致的判断,做到知其然也知其所以然。
这个课程还是有一定门槛的,主要面向的是做大模型开发、生产环境部署和推理优化的开发者,还有机器学习相关的从业者。
不用非得是资深的算法工程师,只要你会点Python,对大模型的基本概念有了解,比如知道什么是token、什么是注意力机制,就能跟着课程一步步学下来。
课程里都是实操为主,代码示例也都是能直接跑的,不会讲太多晦涩的理论和公式,新手也能跟上节奏,毕竟连吴恩达都推荐,就是希望更多人能学会这套大厂级的优化技巧。
想系统掌握AI核心技能、获取行业认可资质?
CAIE注册人工智能工程师认证
助你拓宽职业赛道,成为AI领域持证实力派

企业、高校及渠道合作
请联系微信:FYLlaoshi

 京公网安备 11010802022788号






