关注CAIE,国内头部AI人才认证、培训体系,助你在职场升职加薪。CAIE,全称 Certifed Artifcial Intelligence Engineer(人工智能工程师),简称 CAIE(赛一) ,是人工智能领域的技能等级认证。旨在评估和培养具备
人工智能理论基础与实战能力的职业人士。
最近计算机视觉圈迎来重磅突破,延世大学和成均馆大学联手研发出了3DreamBooth模型,攻克了3D视频生成的诸多行业痛点,把3D感知视频定制技术推到了新高度。
以往AI生成定制化3D视频,总逃不过视角变换主体变形、细节模糊、动作固化的问题。
而3DreamBooth不仅完美解决了这些难题,还打造了专属评估套件,让动态3D视频生成终于实现了保真又丝滑。
<iframe class="video_iframe rich_pages" data-src="https://mp.weixin.qq.com/mp/readtemplate?t=pages/video_player_tmpl&action=mpvideo&auto=0&vid=wxv_4438529624561713154" data-mpvid="wxv_4438529624561713154" data-vidtype="2" data-cover="http%3A%2F%2Fmmbiz.qpic.cn%2Fmmbiz_jpg%2FjuxlRdXDvzESV17icfcxMoy0wKJbcuWoCYcJiar7rMlBXM8NZ5whiaGzG2O5GWAANAxicCgPyTSSuVfNDNlyFjjkBjKjcPWm8ffgLLiaAkd1OoME%2F0%3Fwx_fmt%3Djpeg" data-ratio="1.7777777777777777" data-w="1920"></iframe>Github:https://github.com/Ko-Lani/3DreamBooth
咱们看下这个模型生成的案例。提示词:玛丽莲 梦露在好莱坞的化妆间里,面带微笑地亲吻着一个毛绒玩具,化妆镜前亮着灯泡。
<iframe class="video_iframe rich_pages" data-src="https://mp.weixin.qq.com/mp/readtemplate?t=pages/video_player_tmpl&action=mpvideo&auto=0&vid=wxv_4438532736215318530" data-mpvid="wxv_4438532736215318530" data-vidtype="2" data-cover="http%3A%2F%2Fmmbiz.qpic.cn%2Fsz_mmbiz_jpg%2FjuxlRdXDvzFRzQ1Xd3fMwmXpe5oT2jDUlGZS9iawS1icIRqQpwQupuVuWBvMBnj9Qe9ic4x0ADp7bF8YENNKcY8ld577jLuprPMfAlAfjBLfA0%2F0%3Fwx_fmt%3Djpeg" data-ratio="1.7777777777777777" data-w="1280"></iframe>戴着手套的手将飞行员太阳镜放在一个毛绒玩具上,冷蓝色和洋红色的节日彩灯,透过窗户可以看到白雪皑皑的城市。
<iframe class="video_iframe rich_pages" data-src="https://mp.weixin.qq.com/mp/readtemplate?t=pages/video_player_tmpl&action=mpvideo&auto=0&vid=wxv_4438593024117538818" data-mpvid="wxv_4438593024117538818" data-vidtype="2" data-cover="http%3A%2F%2Fmmbiz.qpic.cn%2Fsz_mmbiz_jpg%2FjuxlRdXDvzEyIEvQXcfiaqeA8lq8p8UGLCk7XTlNY096f1UZ3rTnGa4mzp2D6DqwTtFfQGjG78Xw00GdqP5OPC9sWzJ62MNL2IlPPZz25icE8%2F0%3Fwx_fmt%3Djpeg" data-ratio="1.7777777777777777" data-w="1280"></iframe>一台抓娃娃机抓住一个毛绒玩具,并缓慢地将其旋转360°,背景是霓虹街机灯光。
<iframe class="video_iframe rich_pages" data-src="https://mp.weixin.qq.com/mp/readtemplate?t=pages/video_player_tmpl&action=mpvideo&auto=0&vid=wxv_4438532459592433665" data-mpvid="wxv_4438532459592433665" data-vidtype="2" data-cover="http%3A%2F%2Fmmbiz.qpic.cn%2Fsz_mmbiz_jpg%2FjuxlRdXDvzGtAQnHaDRj4tOfRFC6xU6m8HpnwR06VXiaXMVdBgf4LEn24g83zQlYPhkJB9QicATklbwBWNpNQcEpUricAibjJEtelhib1qicM0U8c%2F0%3Fwx_fmt%3Djpeg" data-ratio="1.7777777777777777" data-w="1280"></iframe>看完这些超真是的3D视频案例,咱们聊聊早期3D视频生成有哪些局限性。
早期的文字定制法,受限于文字的信息表达能力,根本抓不住物体的精细纹理和复杂结构。
后来出现的视觉适配器,能保住2D图像的细节,可应用到视频中,一切换视角就露馅。
再加上多视角视频数据集的稀缺,用少量视频微调模型,很容易让模型只记住固定动作,换个运动方式就无法适配。
简单来说,过去的AI只认识物体的平面视角,没有建立立体认知,自然做不出视角一致的动态3D视频。
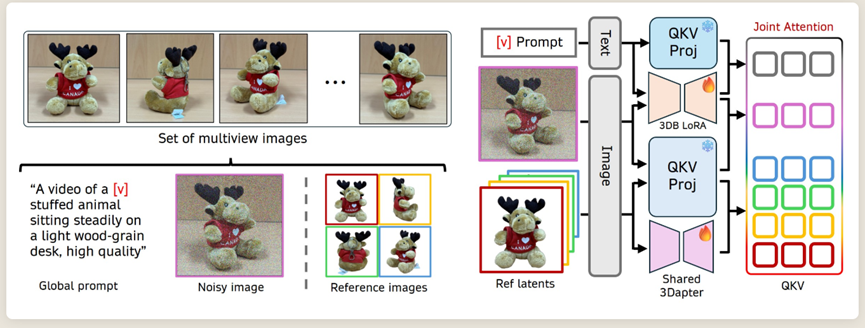
而3DreamBooth框架的核心,就是靠3DreamBooth和3Dapter两个模块协同工作,把物体的空间结构和视频的时间运动拆分开来学习,从根源上解决了此前的技术难题。
其中3DreamBooth的核心作用,是给模型刻入物体的3D记忆,同时还不会让模型记混动作。
最巧妙的设计,是利用单帧训练方式分离3D特征和动态特征,研究团队发现物体的核心特征都是空间属性,和运动状态无关。
而视频扩散模型有个特性,仅输入单帧图片时,时间注意力机制会自动失效,所有学习都会聚焦在空间特征上,无需修改模型结构,就能实现空间和时间特征的自然分离。
训练时,只需将物体不同角度的静态照片当作单帧视频喂给模型,搭配含专属标识V和物体类别的固定提示词,让模型把物体各角度的空间特征都融入标识V中。
同时借助LoRA低秩适配技术,不改动模型原有的预训练参数,仅增加少量可训练权重,既保留模型原本的动态生成能力,又把物体的3D结构刻入其中。
这个模块无需依赖稀有的多视角视频数据集,靠静态照片就能完成训练,充分利用了预训练视频模型本身的3D感知能力。
3Dapter是一个视觉条件模块,直接将物体的图像特征输入模型,跳过文字中转环节,让信息传递更直接。
它的训练分两步走,先通过大量纯白背景和实景配对的物体图做单视角预训练,让模块学会从单张图中抓取核心特征,再和3DreamBooth联合训练,针对具体物体做适配。
联合训练时会选取物体360度无死角的多视角图,去掉背景后喂给3Dapter,所有视角图由同一个3Dapter处理,既保证特征一致性,又控制参数数量。
而且模型会为每个视角图分配专属时序索引,防止特征混淆,还能自动筛选参考图,生成某一视角画面时,只提取最相关的几何特征,让生成效果更精准。
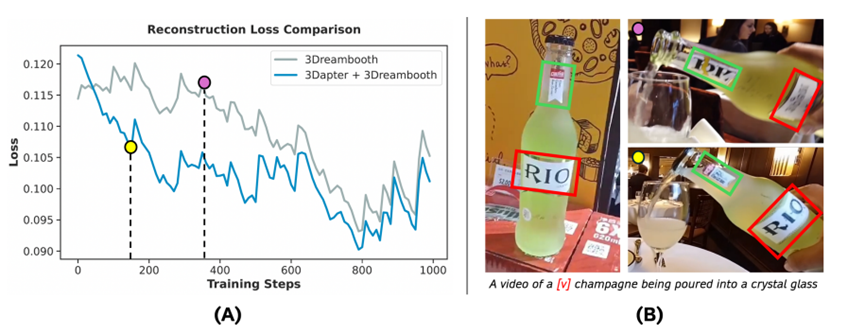
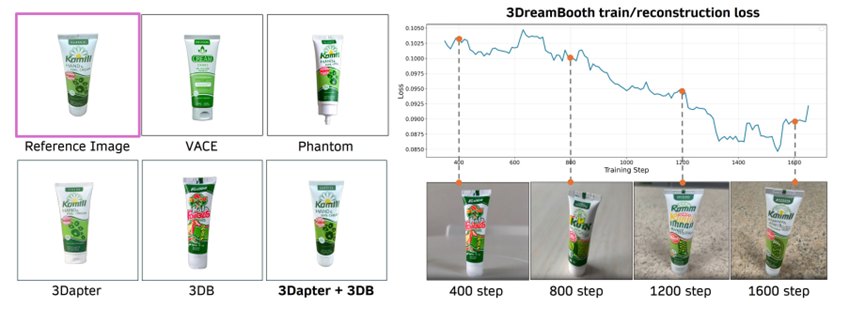
二者配合实现了1+1>2的效果,3Dapter提供精准视觉细节,让3DreamBooth专注学习3D几何变换。
3DreamBooth搭建好3D结构框架,让视觉细节能精准贴合,不会出现细节到位但结构变形的情况。
为了让3D视频定制有统一的评估标准,研究团队还打造了3D-CustomBench评估套件,精选30个3D结构复杂、纹理精细的物体,保证每个物体都有360度完整视角图。
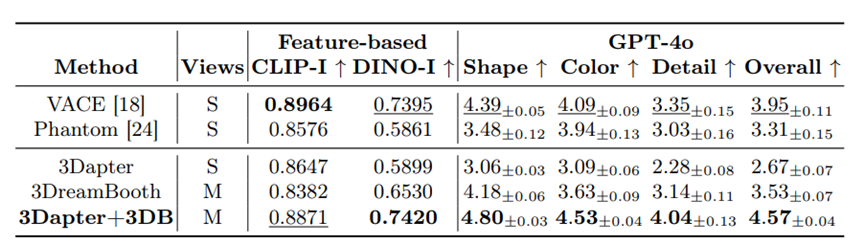
实测中,3DreamBooth的表现更是亮眼,以HunyuanVideo-1.5为基础模型,仅训练不到1亿个参数,占基础模型的1.15%,算力成本大幅降低。
其倒角距离仅0.0177,比主流的Phantom模型近乎减半,3D几何保真性拉满。
GPT-4o对其形状、颜色、细节的保真性打分近乎满分,而且在保证3D保真的同时,视频的画面质量、流畅度和文本契合度都毫不逊色。
消融实验也证明,只有3DreamBooth和3Dapter结合,才能实现结构准、细节满、训练快的效果。
此外,3DreamBooth的算力成本低到离谱,3Dapter预训练仅需4张RTXPro6000显卡、4天就能完成,单个物体的定制化训练。
一张同款显卡13分钟即可搞定,远低于此前VACE、Phantom等模型的算力要求,大幅降低了研究和商用的门槛。
想系统掌握AI核心技能、获取行业认可资质?
CAIE注册人工智能工程师认证
助你拓宽职业赛道,成为AI领域持证实力派
企业、高校及渠道合作
请联系微信:FYLlaoshi



 发帖

 雷达卡




 京公网安备 11010802022788号






