


 发帖

 雷达卡



现在做AI开发,对接不同大模型厂商要写一堆适配代码,想监控、评估AI请求还得自己搭一套复杂的系统,又费时间又费精力,关键是还搞不明白到底哪里出问题。
今天介绍一个超好用的开源Bifrost,让你开发AI应用时,不用再跟慢接口、多厂商适配、难监控这些问题死磕,效率直接拉满。

开源地址:https://github.com/maximhq/bifrost
咱先说说最爽的一点!Bifrost的核心就是快,比市面上常见的LiteLLM网关P99延迟快90倍,这意味着用户用你的AI应用时,再也不会卡半天等响应。

一站式标准化适配,不管是OpenAI、Anthropic、阿里云通义千问、腾讯混元,还是Azure、Bedrock这些,Bifrost都给你做好了适配。
你不用再为了对接不同厂商写一堆重复的适配代码,就像有个万能转换器,不管什么接口规格,接上Bifrost就能用,省下来的时间能多写好几个核心功能。
还有就是它的容灾机制,这才是生产环境最需要的定心丸。大模型服务偶尔抽风或者超时是常态,要是没有重试机制,用户体验直接归零。
Bifrost内置了非常强大的重试和回退逻辑,一旦主模型挂了,它能自动无缝切换到你预设的备用模型。

这对用户来说意味着服务几乎不会中断,这种高可用性对商业项目来说简直就是救命稻草,再也不用半夜爬起来看报警日志了。
还有一个很有意思的功能是负载均衡。如果你手里有多个模型的APIKey,或者想混合使用不同的供应商,它可以根据你的配置把请求分发出去。
这不仅避免了单点故障,还能帮你根据成本或者速度优先级来调度资源。简单说就是让你的算力资源利用率最大化,甚至在某些按量计费的场景下还能帮你省钱。

此外,Bifrost的语义缓存插件也很香,比如用户问过的相似问题,不用再重复调用大模型,直接从缓存里取结果,不仅响应快到离谱,还能省一大笔API费用。
配置也简单,在helmvalues里开启semanticCache,填好OpenAI的嵌入模型Key就行,相当于给你的AI应用加了个“记忆大脑”,常用问题秒回。
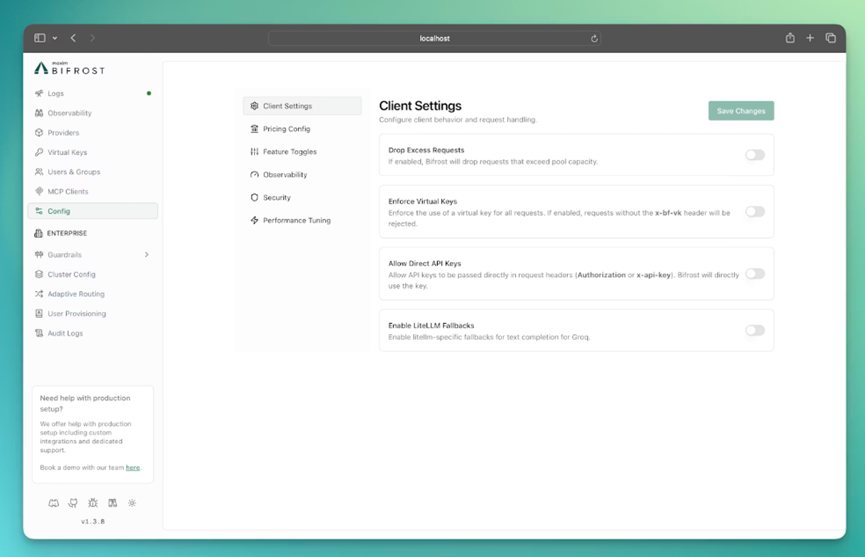
还有很多其他玩法,比如你可以在它这一层加上自定义的日志记录,把每一次请求的耗时和Token消耗都记下来,这对于分析成本和控制预算非常有帮助。
甚至你还可以基于它做一些二次开发,把它当作一个中间件,塞进你现有的微服务架构里,让它成为整个AI系统的流量入口,统一管控所有的模型调用,这在企业级落地的时候简直是神技。
Bifrost绝对是那种你用了一次就离不开的工具,特别适合那些正在做大模型应用落地、需要对接多个模型供应商、或者对服务稳定性有极高要求的开发者。
想转型AI,不被时代淘汰
CAIE注册人工智能工程师认证
岗位能力 × AI工具 ×转型方向 × 场景落地 = 新AI职业价值
扫码免费领取《AI工程师入门学习指南》

 京公网安备 11010802022788号






