


 发帖

 雷达卡



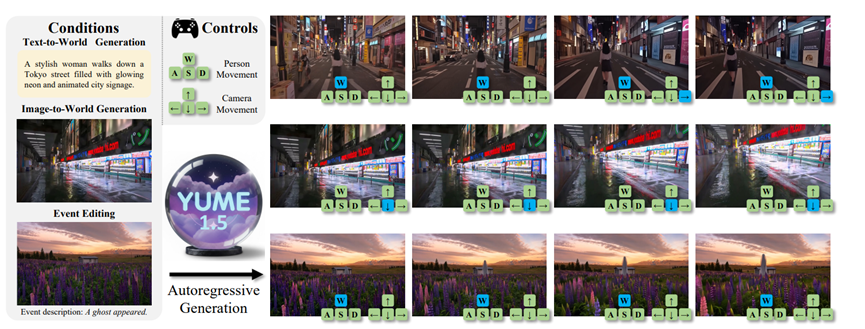
现在大家对虚拟世界的期待真的越来越高了,不管是玩游戏、搞仿真还是想在元宇宙里社交,都想要那种能随便逛、看着真实、还能自由互动的环境。
最近复旦大学、上海人工智能实验室和上海创新研究院开源了大世界模型Yume1.5。生成的世界不仅能靠文字控制,还能实时互动在里面游玩。
下面是生成的虚拟世界,赛博朋克、古文明、青山绿水能让你随意穿梭、游玩。
其实这些年视频生成技术已经进步不少了,像Google的Lumiere、OpenAI的Sora,还有开源的Stable Video Diffusion,生成的视频画质和连贯性都越来越棒。但真要用来做能无限探索的虚拟世界,就会发现一堆让人头疼的问题。
第一个问题就是不接地气。很多模型都是用游戏数据集训练的,生成的场景看着就很假,跟真实城市里的动态环境完全不是一回事。
游戏里的行人、车辆运动都有固定规律,可现实世界里的情况复杂多了,这些模型根本还原不出来,沉浸感一下就没了。
第二个是慢得让人抓狂。扩散模型本身计算量就大,生成一段视频要等好久。之前我了解过Wan-2.1生成一段标准视频要611秒,Matrix-Game更夸张要971秒,这哪能叫实时互动啊,等视频生成完,探索的兴致都没了。
第三个是不够灵活。以前的模型要么靠键盘鼠标机械控制,要么只能按固定脚本走,没法用自然语言触发随机事件。想让虚拟世界里突然下场雨,或者有只猫跑过马路,根本做不到,玩一会儿就觉得无聊了。
这三个问题缠在一起,让虚拟世界一直停留在看着还行但不好玩的阶段,而Yume1.5直接解决了这三大难题。
长视频生成最头疼的就是,生成的画面越多,电脑要记的历史信息就越多,最后慢得像蜗牛。以前的办法要么是直接删掉早期的画面,导致后面生成的内容和前面脱节;要么是简单压缩一下,远处的场景就变得模糊不清。
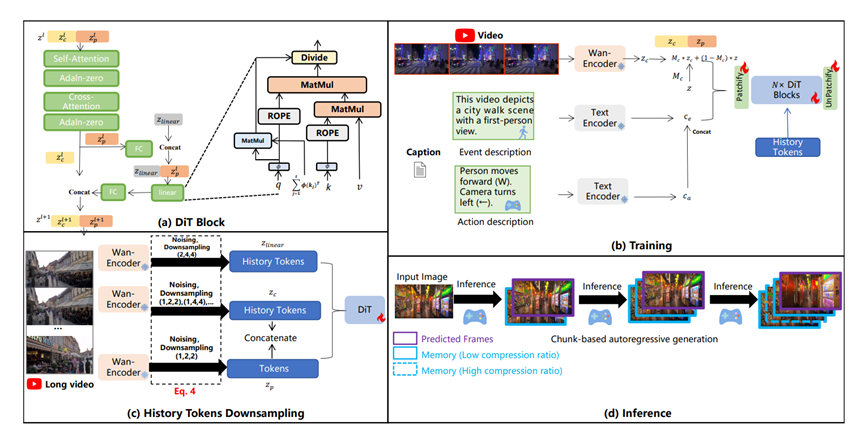
Yume1.5的TSCM建模就聪明多了,它给历史画面做了双重瘦身。一方面按时间远近调整压缩力度,刚生成的近景少压缩点,保留更多细节;
早一点的远景就多压缩点,但关键信息一点不丢,就像我们看远处的东西不用看清每一根草,知道大概轮廓就行。另一方面还会给画面的“数据通道”减肥,把没用的信息过滤掉,让电脑处理起来更快。
这么一套操作下来,不管生成多长的视频,电脑都能轻松应对。视频块数量超过8个以后,推理速度就稳定下来了,再也不会越生成越慢,而且指令响应也更精准了。
实时性是虚拟世界的命根子,要是操作一下等半天,谁还愿意玩。Yume1.5用了两个办法来提速,效果直接拉满。
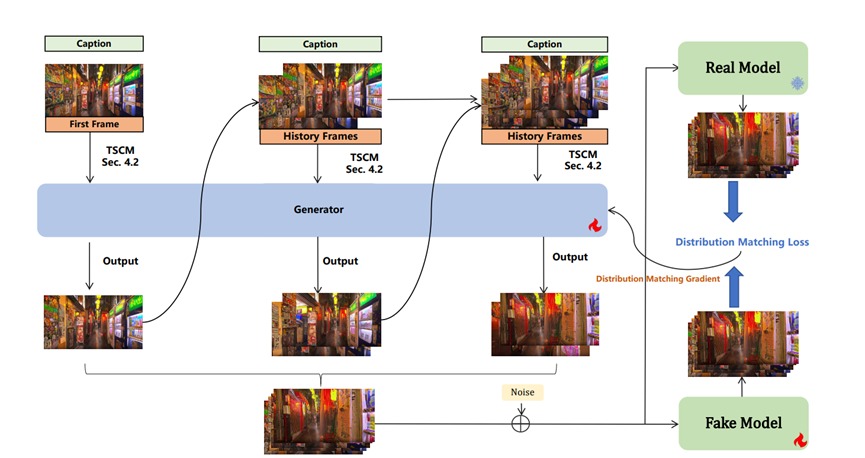
首先是“蒸馏”技术,就像老师把知识浓缩了教给学生,研究团队让一个“学生模型”跟着“老师模型”学,老师要50步才能完成的生成任务,学生4步就搞定了,而且效果还差不多。
它还用TSCM代替了传统的缓存方式,解决了快速生成时容易出错的问题。这么一来,Yume1.5在540p分辨率下每秒能生成12帧画面,完全能满足实时互动。
对比一下以前的模型,Wan-2.1每秒才0.016帧,Matrix-Game更是只有0.01帧,这速度提升简直是革命性的。
以前的模型只能机械控制,Yume1.5直接实现了文本自由,这才是最让人惊喜的地方。它会把我们输入的文字分成两部分来理解,一部分是场景和事件描述,比如“阳光明媚的欧洲街道 行人悠闲散步”;另一部分是动作控制,比如“向前向右移动”。
这样一来,我们既可以用键盘鼠标直接控制角色移动和相机视角,也可以输入文字指令让虚拟世界发生各种事情。
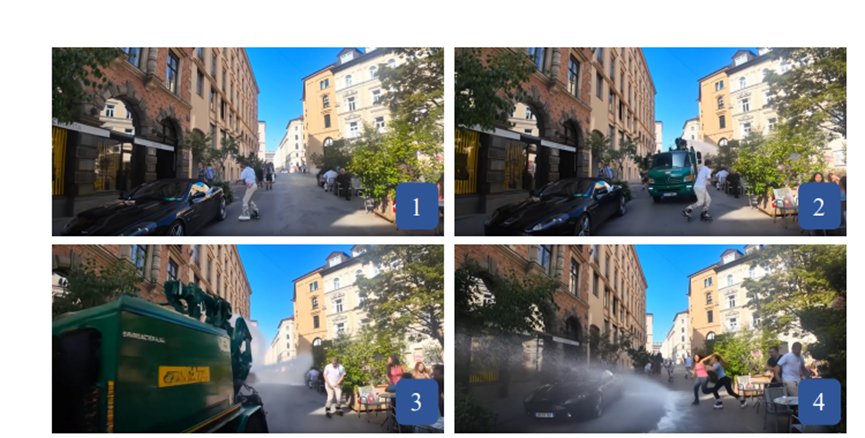
想让街道上突然出现洒水车,或者让一群鸽子飞过天空,只要打一句话就行,虚拟世界瞬间就变得生动有趣多了。
为了让模型更好地理解文字和画面的关系,研究团队还专门建了三个数据集,有真实世界的视频,有合成的高清素材,还有专门描述各种事件的样本,总共有13万多条数据。模型在这些数据上交替训练,既能还原真实场景,又能精准响应文本指令。
为了测试Yume1.5,研究团队进行了全面测试。在核心性能上,Yume1.5生成一段96帧、分辨率544×960的视频只需要8秒,而Wan-2.1要611秒,Matrix-Game要971秒,Yume之前的版本也要572秒。
在指令跟随能力上,Yume1.5的得分达到0.836,远超其他模型,基本上我们说什么,它就能做什么。
在长视频生成上,Yume1.5的稳定性也很出色。生成30秒的视频,分成6个5秒片段来看,后面的片段画质和美学得分都很稳定,不会出现越生成越差的情况。第6个片段的美学得分0.523,比没用到这些技术的基线模型高不少;
图像质量得分0.601,也比基线模型的0.542提升明显。
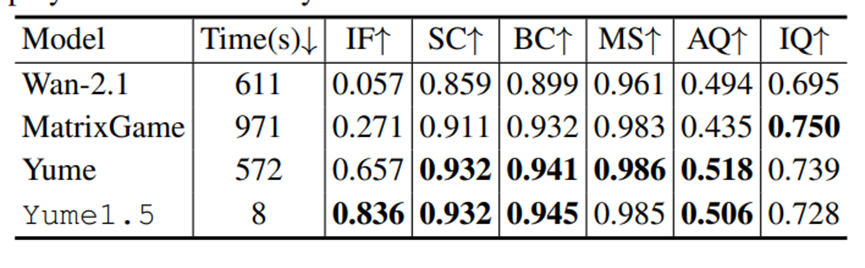
消融实验也证明了各个模块的作用,去掉TSCM之后,指令跟随能力从0.836降到了0.767,而且视频越长,速度差距越明显。
实际生成的效果也很惊艳,就拿欧洲风格的城市街道来说,行人走路自然,车辆行驶流畅,建筑细节丰富,光影效果也符合现实规律。
用键盘控制相机移动,场景过渡很平滑;输入文本指令让行人躲避洒水车,模型能实时生成对应的动态画面,一点都不违和。
有人会问既然Yume1.5这么强,有什么应用场景吗?应用前景真的太广了,我随便说几个。
游戏开发肯定是最先受益的,以前做一款开放世界游戏,要大量美术人员画场景、做动画,成本高还耗时间。
现在有了Yume1.5,开发者只要输入文本描述,就能生成无限延展的游戏世界,玩家还能通过文字触发随机事件,游戏的可玩性和沉浸感直接拉满,独立游戏开发者也能轻松做出大作。
虚拟仿真领域也能用,交通管理部门可以用它生成不同的交通场景,模拟早晚高峰或者突发事故,为交通规划提供数据支持;应急管理部门可以构建灾害模拟场景,用来做应急演练,既安全又省钱。
元宇宙和虚拟社交也会因为它变得更有意思,大家可以用文字自定义虚拟空间,邀请朋友一起探索,说句话就能触发互动事件,比如一起在海边点燃篝火,或者在未来科技城里看飞行汽车,沉浸式社交终于不再是口号。
Yume1.5真的让我看到了交互式虚拟世界的未来。以前我们觉得虚拟世界离日常生活很远,现在有了这样的技术,或许用不了多久,我们就能轻松创建自己的虚拟空间,和朋友在里面自由探索、互动玩耍。
直接把自己内置在虚拟世界中,赛博永生真的要实现了。
开源地址:https://github.com/stdstu12/YUME
想转型AI,不被时代淘汰
CAIE注册人工智能工程师认证
岗位能力 × AI工具 ×转型方向 × 场景落地 = 新AI职业价值
扫码免费领取《AI工程师入门学习指南》

 京公网安备 11010802022788号






