


 发帖

 雷达卡



当下普遍存在一种认知误区:只要将大语言模型接入生产系统或应用程序,模型就能自主解答各类用户问题。但事实并非如此。大语言模型即便性能强大,也和所有人工智能模型一样,依赖数据支撑。绝大多数大模型都存在知识截断特性,即训练数据存在固定的时间截止点。当用户询问截止时间之后的各类信息时,模型依然会生成回答,但答案往往存在错误。
这类错误回答被统称为大模型幻觉,本质上是信息错配导致的必然结果。大模型的训练数据是互联网的静态快照,但对接客服机器人的用户、使用内部AI助手的企业管理者、依托产品智能助手开展工作的销售团队,都需要实时、最新的数据信息。突发新闻、政策更新、竞品定价调整、接口文档迭代等实时动态信息,都不在大模型的原生认知范围内。因此必须借助全新的外部实时数据锚定模型输出,才能确保模型那些看似笃定的回答,真正具备准确性。
何为大模型事实锚定?
大模型事实锚定,是指在模型生成内容的过程中,为其接入最新的外部实时信息。未经过锚定优化的原生大模型,仅依靠训练数据和用户输入提示词生成内容。该模式可适配多数常规场景,但无法应对需要实时信息的提问,例如最新的税务法规、财务申报准则等。而经过锚定优化的生产级大模型,可接入实时知识源,大幅降低幻觉概率,输出结果更可靠。
我们可以将其直观理解为:未锚定的大模型如同断网的推理工具,而完成实时数据锚定的大模型,可实时联网检索最新信息。大模型实现锚定的方式包括接入外部动态数据源、检索系统或实时网页数据。目前最主流的实现方案是检索增强生成(RAG),但下文将说明,即便RAG技术也存在固有局限性。
检索增强生成在生产场景中的短板
检索增强生成(RAG)的核心逻辑,是在用户发起查询时,从预构建的向量库(多为向量数据库)中筛选相关上下文,输入大模型辅助生成回答。该技术通过接入企业内部文档、产品说明等外部知识,有效优化模型输出效果。但RAG仅适用于静态稳定的知识库场景,其输出精度完全依赖检索数据的时效性。
向量库的数据需要持续迭代更新,才能保障RAG系统获取最新信息。一旦数据接入存在延迟,模型就会输出过时内容,再次引发幻觉问题。
而实时网页数据彻底打破了这一局限:向量库为大模型提供的是某一固定时间节点的静态数据快照,实时网页数据则为模型提供持续更新的真实动态信息。网页实时数据不仅解决了数据时效性问题,还能覆盖长尾、未被索引的冷门信息。即便向量库中没有匹配的语义片段,接入实时网页检索的大模型依然可以输出精准答案。
实时网页数据的价值毋庸置疑,但搭建、维护大模型与网页检索的联动框架流程复杂,而托管式搜索基础设施可完美解决这一难题。
适配大模型的托管式搜索基础设施
托管式搜索基础设施无需开发者自主搭建爬虫工具,即可快速获取实时搜索结果,简化搜索数据的全流程检索工作,让开发者专注于生产级大模型系统的研发优化。无论是单独使用,还是与RAG系统搭配部署,该基础设施都能轻松实现大模型的实时网页数据锚定。
主流托管式搜索工具主要分为四类:传统搜索接口、搜索引擎结果页(SERP)接口、大模型原生搜索平台、大模型内置搜索工具。
传统搜索接口可筛选输出精简的搜索结果;搜索引擎结果页(SERP)接口可提供完整、结构化的全网搜索页面数据。SerpApi即为典型的网页搜索接口,支持将百余种搜索引擎的实时结果无缝接入各类应用。Tavily、Exa等新兴大模型原生工具,通过结果重排序、内容摘要精简等优化,降低大模型的集成难度。大模型内置搜索工具适配性最强,但输出结果较为精简,且数据源可控性较低。
各类方案在可控性、透明度、集成难度上各有优劣,但核心作用一致:依托实时网页数据完成大模型事实锚定。搭建好该基础能力后,即可将搜索结果接入大模型工作流水线。
实时网页搜索接入大模型流水线的主流架构模式
将实时网页数据接入大模型流水线时,需综合考量模型权限、延迟容忍度、运维复杂度三大核心要素。行业内主流有三种架构模式,各有对应的适配场景与优劣取舍。
一、优先搜索流水线
该模式逻辑简单直白:先检索,后生成。用户发起提问后,系统会优先调用搜索接口,将实时检索结果拼接至提示词中,为大模型生成回答提供实时上下文支撑。整体架构与RAG高度相似,核心区别在于上下文来源——RAG依托静态向量库,该模式依托实时网页数据。
该方案适配需要高频检索实时数据的场景,尤其适合已有RAG流水线的业务系统。具备部署简单、逻辑确定、延迟较低的优势,所有请求均遵循统一的单次检索流程。但缺点也十分明显:机制僵化,无论用户提问是否需要实时数据,都会强制触发搜索,且无法根据中间结果优化检索指令、调整检索范围。
二、工具调用模式
工具调用模式由大模型自主决策检索行为:用户提问后,模型先自主判断现有上下文是否足够支撑回答,若信息不足,则主动调用搜索接口获取实时数据,再基于检索结果生成最终答案。部分系统支持模型多次调用工具,迭代优化、拓展检索内容。
该模式适配仅部分提问需要实时数据的场景,相比优先搜索流水线,可规避无效检索,灵活性与资源利用率更高。但架构复杂度更高,模型自主控制检索时机与检索方式,问题排查与调试难度更大。
相较于优先搜索流水线,该模式将控制权从系统端转移至模型端,但整体仍为单次决策逻辑,不支持迭代式深度检索。
三、智能迭代循环模式
智能迭代循环是具备迭代推理能力的大模型系统,模型可自主完成推理、工具调用、方案优化的闭环流程,直至完成复杂任务。该模式主要适配竞品分析、产品故障排查等单次检索无法解决的复杂场景,大模型智能体可按需多次发起网页搜索,逐步探索、验证信息、优化回答精度。
该架构更适配需要规划能力与策略性分析的任务,模型不再局限于简单问答,而是扮演智能研究助手的角色。与前两种模式不同,其检索行为并非单次决策,而是推理与检索交替推进的迭代循环过程。
高灵活性伴随更高的成本与复杂度:多次工具调用会增加接口调用成本与响应延迟,且系统的搭建、调试、管控难度远高于前两种模式。
代码示例:基于实时搜索数据实现大模型事实锚定
以下为基于SerpApi实现的优先搜索流水线Python示例代码,通过实时网页搜索完成大模型事实锚定:
# 导入依赖库
import serpapi
import openai

# 实时网页搜索(基于SerpApi)
def get_search_results(query):
    client = serpapi.Client(api_key="你的SerpApi接口密钥")
    results = client.search({"q": query})

    # 提取前5条核心摘要信息
    snippets = []
    for r in results.get("organic_results", [])[:5]:
        snippets.append({
            "title": r.get("title"),
            "snippet": r.get("snippet"),
            "link": r.get("link")
        })

    return snippets

# 拼接实时上下文,构建大模型提示词
def build_prompt(user_question, search_results):
    context = "\n\n".join(
        f"{r['title']}\n{r['snippet']}"
        for r in search_results
    )

    return f"""
你是一名依托实时网页数据作答的智能助手。
请基于以下上下文信息回答用户问题。

参考上下文:
{context}

用户问题:
{user_question}

回答:
"""

# 调用大模型(以OpenAI为例)
def ask_llm(prompt):
    client = openai.OpenAI(api_key="你的OpenAI接口密钥")

    response = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt}]
    )

    return response.choices[0].message.content

# 完整流水线执行逻辑
def answer_question(question):
    search_results = get_search_results(question)
    prompt = build_prompt(question, search_results)
    return ask_llm(prompt)

# 调用示例
print(answer_question("大模型事实锚定的最新技术趋势是什么?"))
预期输出示例(内容会随实时信息迭代更新):
大模型事实锚定的最新技术趋势主要包含以下几点:
1. 公开数据预训练优化:开发者聚焦利用公开数据集优化大模型底座基础能力,夯实模型底层知识储备;
2. 检索增强生成(RAG)迭代升级:该技术通过外部信息检索与文本生成相结合的模式,让模型依托外部实时数据,输出更精准、贴合上下文的回答;
3. 领域专属数据微调:针对细分行业场景微调模型,让模型精准适配特定领域的业务逻辑与场景需求,大幅提升专项任务表现。
以上技术趋势均旨在缓解大模型幻觉问题,提升模型输出内容的准确性与场景适配度。
非Python开发者也可快速适配,SerpApi支持ja vasc ript、Ruby、Rust等多种编程语言,同时兼容谷歌表格等工具。
部署须知:运行代码需提前安装依赖库(pip install serpapi、pip install openai),同时准备好大模型厂商接口密钥(如OpenAI,按量计费)与托管式搜索服务密钥(如SerpApi,提供免费试用额度)。SerpApi官方提供丰富的教程与集成指南,可快速搭建基于实时搜索的锚定型大模型应用。
总结
想要规避大模型在实时事件、产品定价、政策规范等场景的幻觉问题,必须为模型接入最新的外部数据完成事实锚定。RAG技术可为用户提问提供有效上下文支撑,但静态向量库的数据极易过时。而实时网页搜索可完美弥补数据时效性短板,大幅提升大模型在高速迭代场景中的输出可靠性。
托管式搜索基础设施屏蔽了实时网页数据获取的复杂技术细节,开发者可通过三种主流架构将实时数据接入大模型流水线:优先搜索流水线、工具调用模式、智能迭代循环模式,三种方案在可控性、响应延迟、运维复杂度上各有取舍。
其中,优先搜索流水线是实现成本最低、最简单的实时数据锚定方案,核心逻辑为模型生成内容前强制触发实时搜索,上文代码示例即基于SerpApi实现了该架构。
如需进一步探索实践,可使用SerpApi在线实验平台测试实时搜索数据,该平台支持谷歌搜索、AI智能摘要等各类搜索接口的调试与落地。
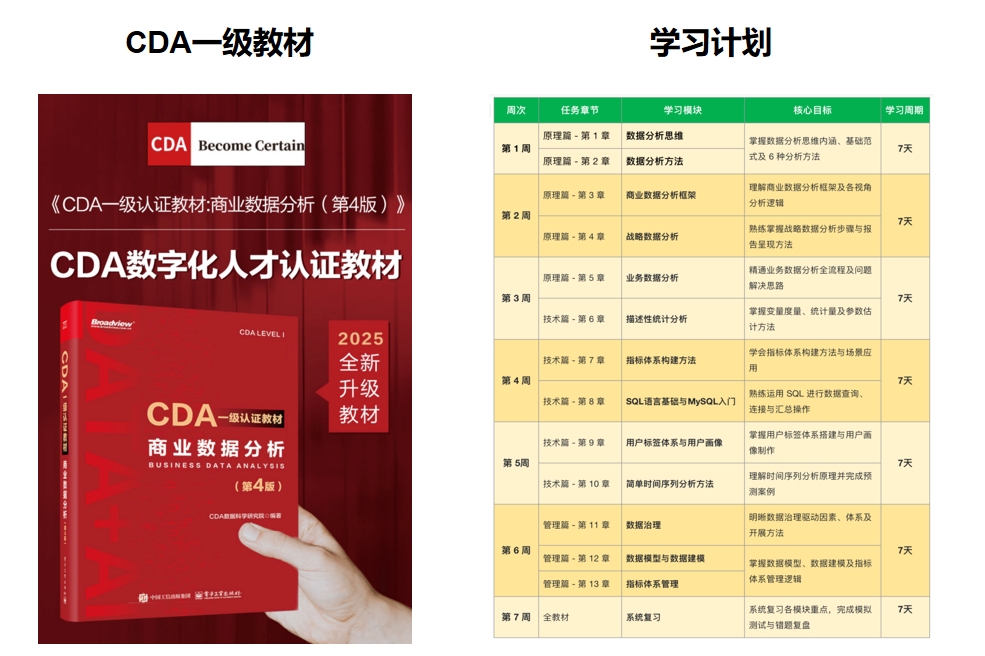
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802022788号






