


 发帖

 雷达卡



系统上线测试的第三周,一位学员向我反馈了一个错误答案。
她向智能问答助手提问,咨询我某篇生成式 AI 教程中的知识点。AI 给出的答案看似无误,实则存在偏差——我早在两个月前就重写更新了这部分内容,但我的 RAG 系统调取了六个月前的旧版本资料。答案不算明显错误,却足以误导用户。
学员误以为是自己理解有误,但问题根源不在用户,而是我的系统在沿用早已迭代废弃的旧内容授课。
我正在为自己的技术教育平台 EmiTechLogic 搭建一套 RAG 智能助手,依托平台内容库,让 AI 基于我原创的文章精准作答。此前我已撰文介绍过初代架构,初代架构在试运行阶段表现稳定,但正式面向真实用户开放后,真正的核心问题才彻底暴露。
我查阅检索日志后找到了问题根源:向量数据库中同时存储着同一内容的新旧两个版本。旧版本因词汇匹配度更高、余弦相似度得分更高,始终排在检索结果首位,新版本只能位居第二、甚至第三。
我原本默认新文档会自动优先展示,但余弦相似度的排序逻辑并非如此。
系统始终严格按照预设规则运行,而这恰恰是问题的核心所在。
该问题普遍存在于各类检索场景中:我更新的 Python 教程、修订的模型对比指南,旧版本内容始终凭借词汇匹配优势优先浮现。我搭建的 AI 工具,一直在悄无声息地向用户输出废弃过时的知识点。
以下是同一查询、同一语料库下,原生 RAG 的实际检索表现:
查询:API 接口的限流规则是什么?是否会触发 429 报错?
原生 RAG 检索结果
1. 【策略文档 v1】 时长:540天 | 已失效 | 相似度:0.447
内容:API 限流规则为每分钟100次请求……
2. 【今日公告】 时长:0天 | 有效 | 相似度:0.329
3. 【老旧教程】 时长:600天 | 已失效 | 相似度:0.303
一份时隔540天的失效文档稳居榜首,48小时内发布的最新官方公告却位列第二。传统检索机制只匹配文本词汇,完全不识别内容时效性。
我此前默认流水线中会自带时效性校验逻辑,但实际并未配置,这是被所有人忽略的关键漏洞。
本文将详细分享我的解决方案:在向量检索结果与大语言模型之间,搭建一层时序处理层,让 RAG 系统具备时间感知能力。
核心速览
简言之:向量检索无法判断信息的有效时间,仅能匹配文本相似度。我在检索与生成环节之间新增重排序步骤:彻底剔除失效过时信息、强化限时有效内容权重、通过指数衰减算法优先选取新文档。核心难点在于平衡时效性与相关性,避免“新鲜内容”覆盖“精准内容”。
一句话总结:原生 RAG 找相似内容,时序 RAG 找有效内容。
完整开源代码:https://github.com/Emmimal/temporal-rag/
适用场景
适用于所有知识库动态迭代更新的 RAG 系统。如果你的系统曾基于已更新、废弃、替换的文档输出看似可信、实则错误的答案,本文方案完全适配。
尤其适配高频迭代场景:API 与产品文档、故障应急处理库、客服知识库、企业内部维基与规章制度、持续更新的教育内容平台。
若你的知识库静态不变、内容无过期迭代属性、过时信息不会造成任何负面影响,则无需部署该方案。
向量检索为何天生缺失时间感知
标准 RAG 流水线的逻辑为:文档向量化、查询语句向量化、匹配高相似度向量、推送结果至大模型处理。这套逻辑在静态知识库中运行稳定,但如果持续更新内容、迭代文档,就会产生隐性故障,且往往只有用户反馈问题后才会被发现。
向量数据库仅能计算向量间的夹角相似度,无法区分文档是一周前更新、还是半年前的旧内容。
行业常规解决方案为删除旧文档、添加元数据过滤,但这两种方式仅能短期生效。一旦再次更新内容,旧问题会立刻复发。即便给旧文档设置20%的权重惩罚,只要词汇匹配度足够高,依旧会优先排序。
深入排查后我发现,这并非单一的“内容过时”问题,而是三类独立的时序缺陷,需要针对性逐一解决,统一归类处理只会治标不治本。
三大时序问题与专属解决方案
我将 RAG 系统的时序缺陷拆解为三类场景,匹配对应的修复策略,彻底解决内容过时、失效、迭代冲突问题:
1. 内容过期:事实已失效
部分文档存在明确过期时间,过期后内容不再属实。这类内容不能仅做降权处理,必须在进入模型推理前彻底过滤剔除,避免输出错误信息。
2. 限时有效:仅特定时段成立的事实
部分信息具备强时效性、短有效期,例如网站故障公告、48小时临时政策调整。在有效期内,这类信息是知识库的核心关键内容;有效期结束后,内容即刻失效作废。
3. 版本迭代:内容已被新版本替换
这是我遇到的核心痛点:更新文档后,新旧版本共存于向量库。旧版本因词汇丰富、匹配度高始终优先排序。该场景无需剔除或强行加权,只需引入时间衰减算法,让新版本随时间自然获得更高排序权重,逐步替代旧内容。
| 问题类型 | 问题本质 | 错误解决方案 | 正确解决方案 |
|---|---|---|---|
| 内容过期 | 事实已不再成立 | 权重降权 | 排序前强制剔除 |
| 限时有效 | 短期有效、具备紧急性 | 按普通内容处理 | 有效期内加权优先展示 |
| 版本迭代 | 内容已被新版本替代 | 强制剔除旧版本 | 时间衰减加权,新版本优先 |
传统方案的误区是将过期文档、限时公告、迭代旧内容归为同一类问题,采用统一规则处理,无法适配不同场景的检索需求。
与现有学术研究的差异
现有时序检索研究方案包括:图检索、时间戳嵌入、检索器内置时序先验、时序语言模型、联网实时检索等。但这类方案均需要重构底层架构、替换模型或改造检索引擎,成本极高,无法快速落地于已上线的生产系统。
因此我设计了检索后重排序架构:在稠密段落检索下游新增重排序步骤,无需改动原有检索器、无需更换嵌入模型、无需重构基础设施。仅需为所有文档添加时间戳,查询时执行一次时序重排序,即可快速适配存量系统。
该方案可快速落地生产环境,无需大规模重构,完美适配已上线业务系统。
自研方案:时序处理层架构
我最终搭建的时序层,部署在向量检索器与大语言模型之间,完全不改动原有检索逻辑。系统依旧会先基于余弦相似度召回Top20候选文档,再通过时序层完成分类、过滤、重排序,最终推送优质内容至大模型。
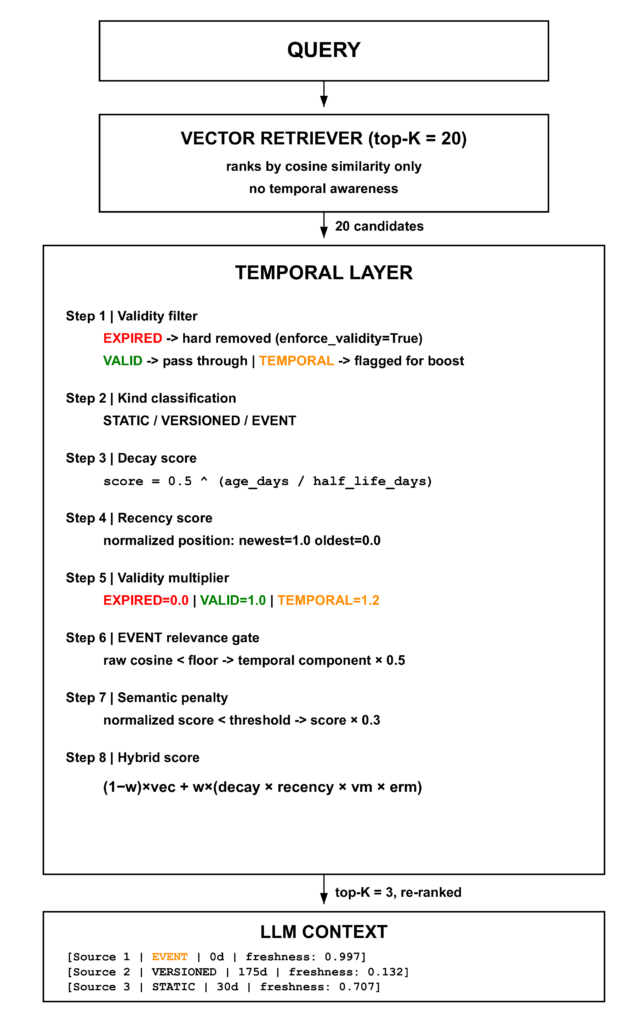
整体流程:用户查询 → 向量检索召回候选内容 → 时序层基于衰减算法与时序权重处理 → 筛选Top3时序最优内容送入模型上下文窗口。整套架构实现了原生语义检索结果向时序感知检索结果的升级。
核心设计:双维度独立分类体系
本方案的核心设计亮点为两个相互独立的分类维度,而非单一时序判定,精准区分不同内容的时间属性与处理逻辑。
维度一:内容有效状态(三类)
1. 已过期:曾经属实,当前已失效。排序前强制剔除。
2. 永久有效:无时间限制的恒定事实,按常规规则打分排序。
3. 限时生效:当前处于有效时间窗口内的紧急内容,专属加权提权。
传统系统仅区分“有效/过期”两类状态,缺失限时生效内容的独立判定维度。系统无法区分常规制度更新与临时故障公告,导致紧急时效性内容无法优先展示,有效期结束后又无法自动标记过期。
核心简化逻辑代码:仅事件类文档可进入限时生效状态,版本迭代类、静态参考类文档均默认永久有效。
# 限时生效状态仅针对事件类文档开放
# 版本迭代、静态参考文档不触发限时生效机制
if self.kind == DocumentKind.EVENT:
    return ValidityState.TEMPORAL

return ValidityState.VALID  # 带生效时间的迭代文档仍归为永久有效
维度二:文档内容类型(三类)
1. 静态内容:无时间属性的恒定事实,如定义、数学公式、参考资料。
2. 迭代内容:会持续更新迭代的内容,如规章制度、教程文档、技术规范。
3. 事件内容:仅特定时段有效的临时信息,如官方公告、系统故障通知。
该分类是保障排序精准度的关键。初代方案曾出现漏洞:将新版公司制度判定为临时事件,导致永久制度被过度加权置顶。制度更新与临时故障公告虽均为最新内容,但逻辑完全不同——制度需长期生效、缓慢衰减,临时公告仅短期有效、过期作废。
优化规则:仅事件类内容可享受紧急加权特权,常规迭代、静态内容不触发临时提权。
示例:
v2版本制度:类型=迭代内容 | 状态=有效 | 优先级:替代v1旧版本
今日公告:类型=事件内容 | 状态=限时生效 | 剩余有效期42小时
即便两份文档发布时间一致,内容类型不同,排序逻辑与权重衰减规则也完全不同。
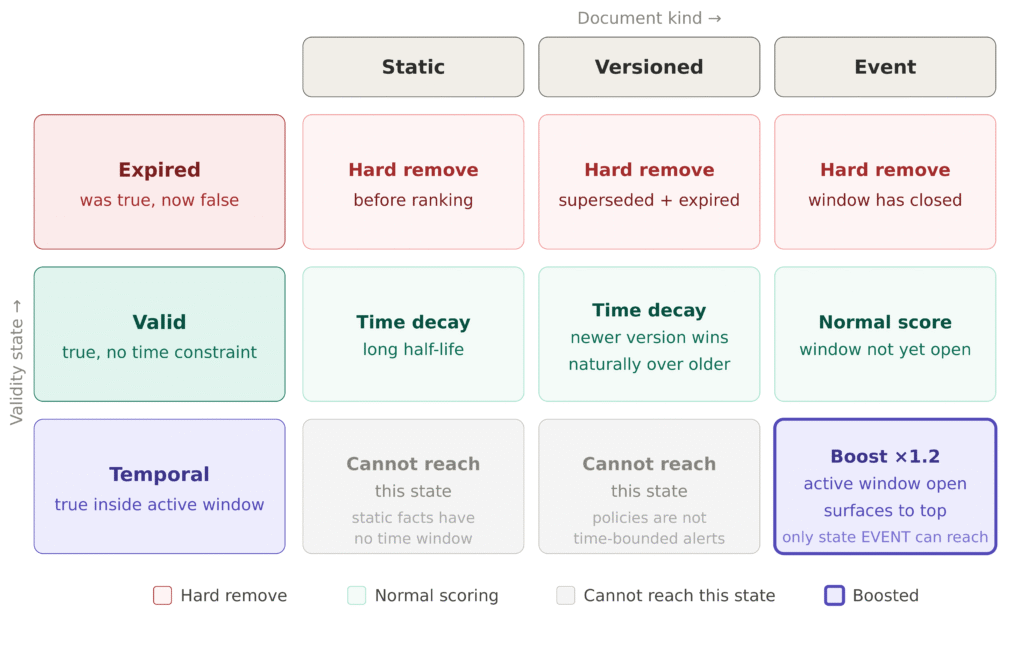
双维度联动规则:仅「限时生效+事件类」内容可加权提权;所有过期内容强制剔除;静态、迭代内容无法进入限时生效状态。
混合打分公式
文档最终得分融合语义相似度与多维时序信号,平衡相关性与时效性:
最终得分 = 语义惩罚系数 × [(1-时序权重)×向量相似度得分 + 时序权重×(衰减得分×近新得分×有效状态系数×事件相关性系数)]
各参数详解:
1. 向量相似度得分:归一化至0-1区间,基于候选池相对值计算;
2. 衰减得分:基于文档时长的指数衰减算法,适配信息检索时效性排序通用逻辑:衰减值 = 0.5^(文档天数/半衰期天数)。可自定义不同内容的衰减速度:新闻半衰期7天、法律文档半衰期365天;
3. 近新得分:候选池内相对时效性对比,最新文档得分最高、最旧最低,保证优先选取当前候选池内最优新鲜内容;
4. 有效状态系数:过期内容=0.0(兜底剔除)、永久有效=1.0(正常打分)、限时生效=1.2(加权提权);
5. 事件相关性系数:仅针对事件类内容生效。原始余弦相似度达标=1.0(全额加权),未达标=0.5(减半加权);
6. 语义惩罚系数:相似度达标=1.0(无惩罚),相似度过低=0.3(相关性惩罚);
7. 时序权重:平衡语义相关性与时效性,我的生产平台配置为0.4,即60%权重为语义匹配、40%权重为时序时效,杜绝新鲜低相关内容覆盖精准旧内容。
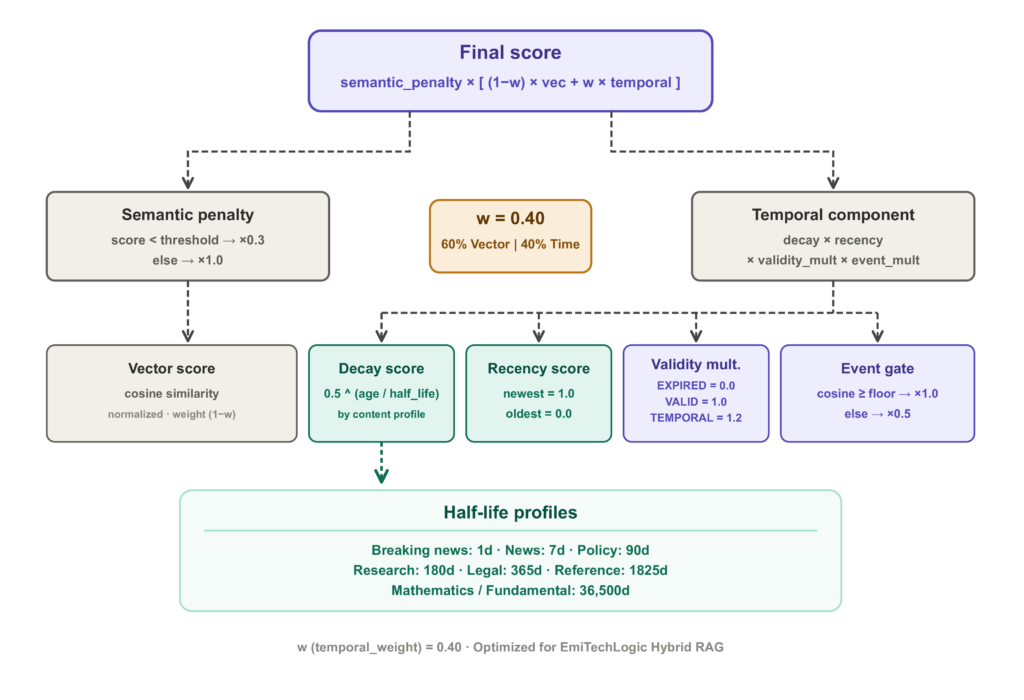
所有候选文档均需经过该公式计算后,才可送入大模型推理,严格平衡相关性与时效性。
关键优化:事件相关性门槛机制
初代时序层上线后暴露新问题:最新的网站维护公告会凭借时效加权优势,抢占“团队健康状况”等无关查询的检索首位。单纯的时效性优先毫无意义,新鲜内容必须同时满足相关性要求。
为此我新增原始相似度门槛机制:事件类内容仅当原始余弦相似度达标阈值时,才可享受时效加权;相关性不达标,自动取消时效优势。
def _event_relevance_multiplier(self, doc, state, raw_vector_score) -> float:
    # 非事件类内容,不触发相关性校验
    if doc.kind != DocumentKind.EVENT:
        return 1.0
    # 非限时生效状态,不触发加权
    if state != ValidityState.TEMPORAL:
        return 1.0
    # 校验原始相似度是否达标
    floor = self.config.event_min_raw_vector_score
    return 1.0 if raw_vector_score >= floor else 0.5
选用原始相似度而非归一化相似度的原因:原始相似度为绝对判定标准,不受候选池整体质量影响。即便所有检索结果质量都很差,无关内容的原始相似度依旧趋近于0,可精准拦截新鲜但无关的内容;而归一化相似度为相对值,容易产生“矮子里拔将军”的误判。
阈值适配规则:
- TF-IDF/稀疏嵌入模型:门槛值设为0.20(原生匹配得分偏低);
- text-embedding-3-small、all-MiniLM-L6-v2等稠密嵌入模型:门槛值设为0.35-0.50(原生得分偏高,需提高筛选标准)。
四大场景实测对比:原生 RAG VS 时序 RAG
以下为同查询、同数据集下,两种方案的真实运行结果,直观体现时序层优化效果。
场景一:API 限流规则(过期内容误导风险)
查询:API 接口的限流规则是什么?是否会触发 429 报错?
原生 RAG 结果
1. 【策略v1】540天 | 已过期 | 相似度0.447(每分钟100次请求限流)
2. 【今日公告】0天 | 有效 | 相似度0.329
3. 【老旧教程】600天 | 已过期 | 相似度0.303
时序 RAG 结果
1. 【今日公告】时长0.3天 | 事件类 | 限时生效(剩余42小时) | 最终得分1.079
核心说明:临时生效公告优先级最高,当前限流规则已临时暂停
2. 【策略v2】时长175天 | 迭代类 | 有效 | 最终得分0.573
核心说明:最新正式策略,完全替代v1旧版本
3. 【近期资讯】时长30天 | 静态类 | 有效 | 最终得分0.509
已剔除内容:策略v1、老旧教程
新增展示内容:最新策略v2、近期资讯
优化效果:原生 RAG 输出过时的100次/分钟限流规则,时序 RAG 优先展示临时暂停政策,同步推送最新1000次/分钟的正式限流标准,彻底规避错误答案。
场景二:大模型缩放研究(学术结论迭代更新)
查询:大模型规模扩大后,性能是否会持续提升?
原生 RAG 结果
1. 【老旧教程】600天 | 已过期 | 相似度0.226
2. 【2022研究】730天 | 有效 | 相似度0.141
3. 【2026研究】120天 | 有效 | 相似度0.136
时序 RAG 结果
1. 【2026研究】静态类 | 有效 | 得分0.662(最新最优研究结论)
2. 【2022研究】静态类 | 有效 | 得分0.600(经典参考结论)
3. 【往期资讯】静态类 | 有效 | 得分0.476
已剔除内容:过期老旧教程
新增展示内容:往期行业资讯
优化效果:原生 RAG 优先推送过时结论,时序 RAG 剔除无效内容,置顶2026年最新算力最优缩放研究成果,贴合当前学术共识,修正了早期模型性能随规模无限提升的旧结论。
场景三:团队与公司现状(兼顾新旧完整信息)
查询:当前研发团队与公司整体运营状况如何?
原生 RAG 结果
1. 【往期资讯】400天 | 有效 | 相似度0.600
2. 【新版教程】85天 | 有效 | 相似度0.385
3. 【老旧教程】600天 | 已过期 | 相似度0.304
时序 RAG 结果
1. 【往期资讯】静态类 | 有效 | 得分0.602(历史参考信息)
2. 【近期资讯】静态类 | 有效 | 得分0.543(最新现状信息)
3. 【新版教程】迭代类 | 有效 | 得分0.519(最新版本内容)
已剔除内容:老旧过期教程
新增展示内容:近期官方资讯
优化效果:实时公告因相似度0.165未达0.2门槛,不强行加权,避免无关干扰。模型可同时读取新旧资讯,完整掌握团队发展变化,原生 RAG 仅展示片面旧信息。
场景四:系统故障查询(紧急内容防埋没)
查询:当前是否存在 API 故障或限流暂停政策?
原生 RAG 结果
1. 【策略v1】540天 | 已过期 | 相似度0.390
2. 【策略v2】175天 | 有效 | 相似度0.267
3. 【今日公告】0天 | 有效 | 相似度0.101(被埋没的紧急内容)
时序 RAG 结果
1. 【策略v2】迭代类 | 有效 | 得分0.641(最新正式规则)
2. 【今日公告】事件类 | 限时生效 | 得分0.465(相关性不足,加权减半)
3. 【近期资讯】静态类 | 有效 | 得分0.082(相关性过低惩罚)
已剔除内容:过期策略v1
优化效果:紧急公告成功上浮,摆脱垫底位置。因“故障”与“系统升级”词汇匹配度低,未登顶,若使用稠密嵌入模型可进一步提升精准度。
生产环境迭代优化:解决各类边缘问题
1. 老旧优质内容的适配策略
部分旧内容未失效、但时效性不足,不宜单独作为答案输出。为此新增弱内容配对机制:老旧低分时内容仅可与新鲜高分内容搭配展示,禁止单独推送;彻底失效内容直接剔除。
示例:
【失效旧研究】衰减分0.100 → 直接剔除
【偏弱旧研究】衰减分0.351 → 必须搭配新鲜内容展示
【优质新研究】衰减分0.891 → 独立正常展示
2. 得分与置信度解耦
高分不代表高置信度。若两篇文档得分接近但内容冲突,系统需降低置信度、禁止笃定输出。为此新增置信度分级机制,通过分差判定可信度:
- 差距明显、单一最优:高置信度
- 得分接近、内容冲突:低置信度
- 常规稳定内容:中置信度
3. 精准日志溯源机制
新增按查询ID分类的失败日志,精准定位文档剔除原因,快速排查线上问题。
常见剔除原因:迭代内容过期、静态内容陈旧、新鲜内容相关性不足、超出有效时间窗口等。
4. 版本内容冲突烈度检测
区分普通文字修改与核心事实变更,根据冲突烈度动态调整权重与置信度:核心数据大幅变更,新版适度加权,同时降低模型输出置信度,保证答案准确且严谨。
5. 用户时间意图精准匹配
针对用户指定时间范围的查询,新增时间解析过滤器:用户明确时间区间时,强制筛选对应时段文档、关闭时序衰减;无时间指定时,默认开启时序优化,杜绝系统主观臆断。
6. 动态时序权重适配
根据查询语义动态调整时序权重:时效性敏感问题拉高权重,静态知识性问题降低权重,适配不同查询需求。
示例:
- 「当前限流规则」:时序权重0.7(重时效)
- 「限流规则近期变更」:时序权重0.55(兼顾时效与历史)
- 「余弦相似度原理」:时序权重0.2(侧重静态知识)
7. 版本链去重优化
在时序层处理前新增版本链去重,自动剔除同内容的旧迭代版本,仅保留最新版,彻底解决多版本共存导致的模型答案矛盾、折中输出问题。
差异化半衰期:不同内容分时衰减
统一半衰期无法适配全场景内容,新闻、政策、学术、数学知识的时效性完全不同。我为七类内容定制专属衰减参数:
- 突发资讯:半衰期1天,时序权重0.70
- 常规新闻:半衰期7天,时序权重0.55
- 规章制度:半衰期90天,时序权重0.45
- 学术研究:半衰期180天,时序权重0.35
- 法律条文:半衰期365天,时序权重0.25
- 参考资料:半衰期1825天,时序权重0.10
- 数学定理:半衰期36500天,时序权重0.01(近乎永久有效)
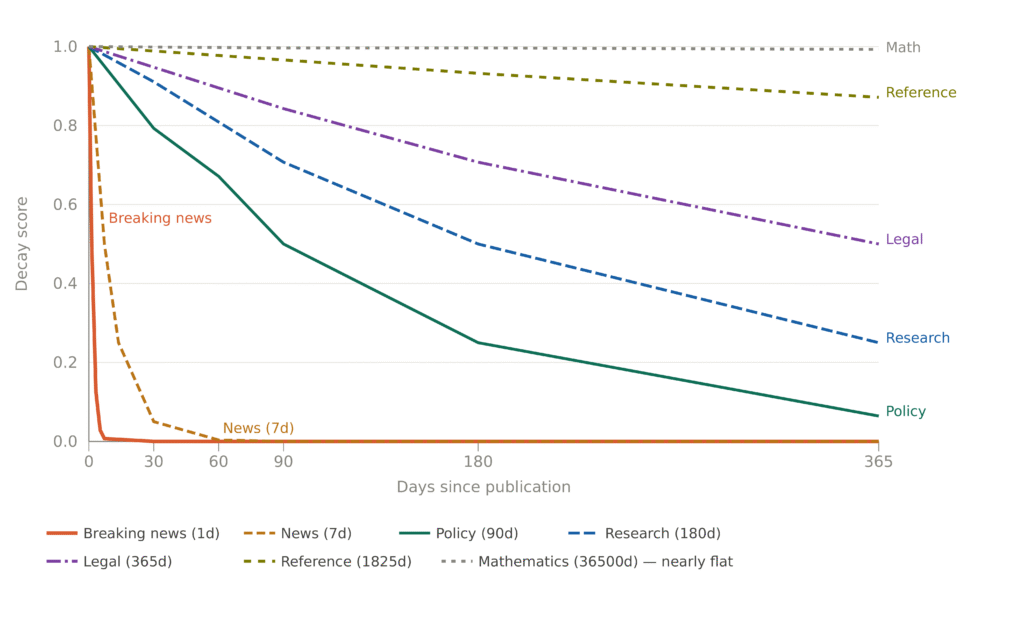
同时新增衰减下限机制:避免经典静态知识因年代久远被过度降权,保证老旧高价值内容的检索优先级,平衡时效性与内容价值。
方案性能与落地成本
时序重排序单次查询仅增加15-30毫秒耗时,相较于大模型1-4秒的推理耗时,性能损耗可忽略不计。
无需改造搜索引擎、向量数据、嵌入模型,纯Python后置处理逻辑,可无缝对接所有存量 RAG 系统。
最低部署要求:所有文档配置创建时间戳;配置生效/失效时间、内容类型可进一步提升效果,无额外元数据可默认按静态永久内容运行,优于原生 RAG。
方案局限性(客观说明)
1. 隐性过期问题未完全解决:无明确过期时间的废弃接口、过时教程,无法自动识别失效,仍需依赖规则兜底;
2. 内容冲突无自动消解:时序层仅筛选最新最优内容,多内容观点冲突的问题,需由大模型自主整合判别;
3. 阈值需模型适配:相似度门槛、半衰期参数为通用基准,需根据自身模型、业务场景微调;
4. 无通用最优参数:各行各业对“过时”的定义不同,需基于真实业务查询数据迭代调优。
核心总结
RAG 时序问题的本质,并非检索错误内容,而是系统无法判别信息的有效时间,仅能匹配文本相似度。
整套方案的核心是双维度分类体系:通过「有效状态」判定内容处理方式(剔除、正常、加权),通过「内容类型」界定时间迭代逻辑(静态、迭代、临时事件),彻底解决传统时序方案的误判问题。
搭配事件相关性门槛,杜绝新鲜无关内容挤占检索结果,最终实现:不牺牲语义相关性、兼顾内容时效性,让 RAG 从“找相似文本”升级为“找真实有效信息”。
快速部署指南
完整代码(temporal_rag.py、demo.py、advanced.py)已开源,包含完整状态判定、多类型衰减配置、序列感知检索、时效性评估接口。基于确定性 TF-IDF 嵌入,无需密钥,可直接复现本文所有实验结果。
git clone https://github.com/Emmimal/temporal-rag/
cd temporal-rag
pip install numpy
python demo.py
参考文献
RAG 基础理论
[1] Lewis 等. (2020). 面向知识密集型 NLP 任务的检索增强生成. NeurIPS 2020.
[2] Gao 等. (2024). 大语言模型检索增强生成技术综述.
模型时序推理研究
[3] Lazaridou 等. (2022). 基于少样本提示的联网增强问答语言模型.
[4] Kasai 等. (2022). RealTime QA:实时性问答任务研究.
[5] Dhingra 等. (2022). 作为时序知识库的时间感知语言模型.
稠密检索与重排序技术
[6] Nogueira & Cho. (2019). 基于 BERT 的段落重排序算法.
[7] Reimers & Gurevych. (2019). Sentence-BERT 句向量嵌入模型.
大模型缩放定律
[8] Kaplan 等. (2020). 神经语言模型缩放定律研究.
[9] Hoffmann 等. (2022). 算力最优的大语言模型训练策略.
信息检索基础
[10] Manning 等. (2008). 信息检索导论. 斯坦福大学出版社.
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802022788号






