


 发帖

 雷达卡



“美将拯救世界。”——Fyodor Dostoevsky
一、引言
语义检索技术并非一蹴而就。如今基于Transformer的语义检索系统效果惊艳,能够精准捕捉文本上下文,甚至识别语句间微妙的语义关联。但这套成熟的现代语义检索体系,是长期迭代、逐步成型的。在向量嵌入、Transformer模型与大语言模型问世之前,科研人员主要依靠关键词匹配、TF-IDF向量与传统机器学习方法开展文本分析工作。
这些早期技术理念从未被淘汰。事实上,现代语义检索系统的核心框架,依然建立在数十年前的经典理论之上。该领域层层迭代、逐步演进,每一代技术方案都解决了前代存在的部分痛点,同时也暴露出全新的局限性。
梳理技术演进脉络至关重要。机器学习领域与自然科学规律相通,溯源过往,方能明晰未来的发展方向。语义检索的发展史,也是人工智能领域的一次核心变革:从逻辑透明、人工设计规则的检索系统,逐步迭代为内部推理机制难以解析的高阶智能模型。简言之,技术演进实现了从显式检索规则、人工特征工程,到模型自主从数据中学习抽象语义表征的跨越式升级。
本文将通过具体实战案例,完整梳理语义检索的迭代脉络:以学生艺术评论文本与专业画作评论文本的相似度匹配任务为载体,循序渐进搭建四级精度递进的检索系统,逐一剖析各代方案的核心优势与固有缺陷。
本文将详解语义检索迭代的四大核心阶段:
方法一:人工检索特征 + TF-IDF
可解释排序系统,融合TF-IDF余弦相似度与关键词重合度、文本长度归一化、时效权重等可解读人工特征。
方法二:面向语义排序的传统机器学习
基于TF-IDF特征向量,结合逻辑回归等监督学习模型,通过标注数据自主学习语义排序规则。
方法三:基于向量嵌入的语义检索
摒弃稀疏词法表征,采用句向量Transformer模型生成稠密语义向量,实现深层语义匹配。
方法四:Transformer模型微调
基于BERT等预训练Transformer模型微调,直接建模文本间的深层语义关联。
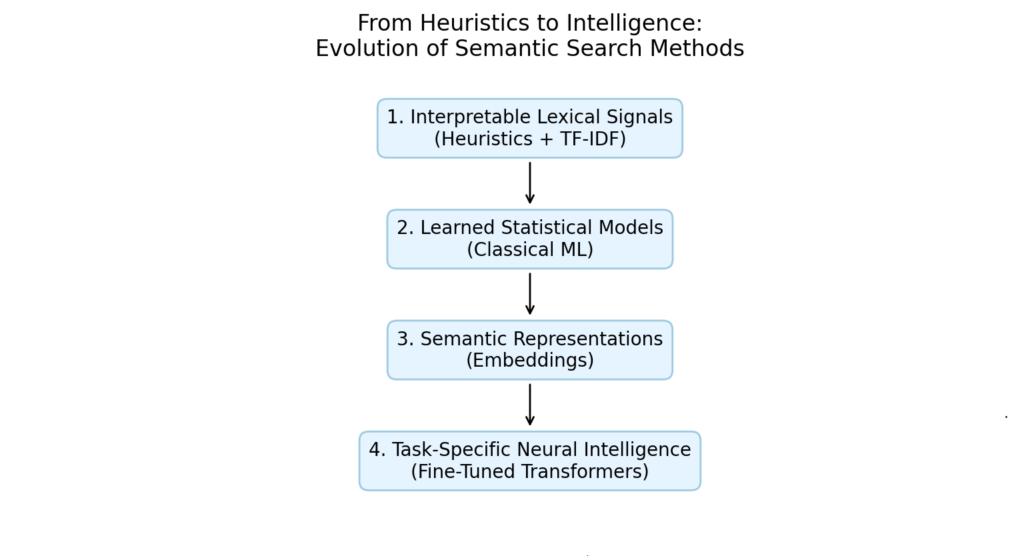
通过全文实验,你将搭建一套性能逐级提升的语义检索流水线,同时深度理解行业迭代逻辑:从依赖人工设计特征的传统系统,升级为自主从数据中学习语义规律的智能模型。
二、实验数据集
为聚焦语义检索核心逻辑、规避数据集构建的冗余干扰,本文采用小型人工合成艺术评论数据集。该数据集高度还原真实场景,精准模拟了不同评论者针对同一画作,在词汇选用、写作风格、解读视角、分析深度上的差异化表达。
每条评论数据均包含元数据与自由文本内容。本文统一核心实验任务:将学生撰写的画作评论与专家同款画作评论进行比对,通过四代递进式检索算法,完成文本语义相似度判定与排序。
数据集采用Python数据类统一规范存储,结构如下:
@dataclass
class Critique:
    critique_id: str        # 评论唯一ID
    painting_id: str        # 对应画作ID
    critic_name: str        # 评论作者
    title: str              # 评论标题
    text: str               # 核心评论文本
    published_at: datetime  # 发布时间
其中,text字段为语义分析的核心数据,painting_id、critic_name、published_at等元数据可用于数据筛选、分组与排序优化实验。
单条标准评论数据示例如下:
Critique(
    critique_id="c102",
    painting_id="starry_night",
    critic_name="伊莱恩·福斯特博士",
    title="律动生情",
    text="""
    梵高将夜空塑造成富有生命力的景象。流转的笔触赋予灵魂张力,
    极致明亮的星光营造出梦幻空灵的氛围。
    """,
    published_at=datetime(2021, 5, 12)
)
该合成数据集虽体量小巧,但足以完整演示语义检索的核心逻辑,覆盖从基础关键词匹配到Transformer深层语义表征的全流程能力差异。
注:本文四代方法的完整代码已开源至GitHub仓库,具体地址见文末。
三、核心实验方法
3.1 方法一:基于规则检索与TF-IDF的排序算法
本文从最经典、可解释性最强的检索方案切入:将TF-IDF排序与多维度人工检索特征相结合。相较于现代深度学习系统,该方法逻辑简洁清晰,但涵盖了文档检索与相似度评分的全部核心基础原理。该阶段的系统无法真正“理解”文本语义,仅能识别词汇使用规律,并结合人工设计的评分策略完成文本排序。
本方法的核心基础为词频-逆文档频率(TF-IDF),这是将文本转化为数值向量的经典算法。其核心逻辑为:提升单文档高频、全局低频词汇的权重,弱化通用无意义词汇的干扰。诸如“画作”“这个”等通用词汇权重极低,而“构图”“明暗对比”“象征手法”等专业特色词汇权重更高。
基于专家评论文本训练TF-IDF向量化器后,系统会生成稀疏的文档-词条矩阵。矩阵每一行对应一条评论,每一列对应一个训练词条,矩阵数值即为对应词条的TF-IDF权重。
文本向量化完成后,通过余弦相似度计算文档相似度。该指标用于衡量高维空间中两个向量的夹角:两篇评论词汇相似度越高、用词比例越接近,向量方向越契合,相似度得分越高。
但仅依靠TF-IDF相似度存在明显缺陷:两篇语义相近的评论可能用词完全不同,而部分无关评论可能因共用专业术语出现虚假高相似度。为优化检索精度,本文融合多项人工启发式特征,构建复合评分体系。
复合评分特征包含三类核心维度:
1. 关键词重合度:统计两篇评论核心关键词的重叠数量;
2. 文本长度归一化:奖励内容详实、篇幅适中的评论,不盲目推崇长文本;
3. 时效权重:基于指数时间衰减规律,适度优先展示最新评论。
最终综合排序得分计算公式:
得分 = 1.2 × TF-IDF相似度 + 0.6 × 关键词重合度 + 0.2 × 长度归一化得分 + 0.15 × 时效得分 (公式1)
所有特征值均被约束在0-1区间内,同时通过截断函数做安全校验:
np.clip(value, 0.0, 1.0)
本次实验数据特征天然处于0-1区间,截断校验可直接生效;但在大型生产系统中,热度、引用量等数值跨度极大的特征,需额外做归一化处理。
文本长度归一化规则(最优目标篇幅为250词):
长度归一化得分 = min(文本词数/250, 1) (公式2)
示例:125词的评论得分为0.5,250词及以上的评论得满分1.0。
时效权重采用10年半衰期规则,实现平滑的内容新鲜度衰减,适配搜索引擎与推荐系统通用逻辑:
时效得分 = 0.5^(时间跨度天数/半衰期天数) (公式3)
- 当日发布评论:得分接近1.0
- 10年前发布评论:得分约0.5
- 20年前发布评论:得分约0.25
该方法最大优势为全链路可解释,可通过各特征权重占比,清晰追溯任意两条评论的排序依据。
本次实验采用学生评论文本作为待检索样本,匹配库为专家评论数据集,学生评论原文如下:
这幅画作营造出静谧却极具力量的情感氛围。柔和的光线与克制的色调,让画面主体显得孤寂却端庄。背景不与主体抢戏,反而烘托出沉静、悠远的意境。整体画面细腻内敛、富有心理张力,构图精巧考究。
模型最终匹配排序结果如下:
| 评论标题 | 专家作者 | 相似度得分 |
|---|---|---|
| 光影与静谧 | 专家A | 0.531 |
| 心理意境刻画 | 专家D | 0.297 |
| 叙事与笔触表达 | 专家E | 0.224 |
| 色彩与画面质感 | 专家B | 0.212 |
| 历史象征意蕴 | 专家C | 0.096 |
排序结果完全贴合语义逻辑:学生评论聚焦柔和光影、内敛情绪、心理氛围,与《光影与静谧》《心理意境刻画》两篇专家评论的用词、核心主题高度契合。而侧重象征手法、笔触技术、历史解读的评论匹配度更低。
同时,TF-IDF的局限性也在此凸显:该方法仅能捕捉表层词汇重合规律,无法识别深层语义关联。例如“光影的戏剧化运用”与“明暗对比效果显著”语义高度相近,但因词汇差异极大,会被判定为低相似度。传统词法检索的短板,推动了下一代机器学习检索方案的诞生。
3.2 方法二:基于TF-IDF特征的传统机器学习排序
语义检索的第二代迭代,核心是以监督机器学习替代人工评分规则。无需人工定义TF-IDF相似度、关键词重合度等特征的权重比例,模型可基于标注数据自主学习最优排序规律。
本实验采用全新的画作评论数据集,数据被标注为“专家级评论”与“新手级评论”两类。实验目标不再是相似度排序,而是训练分类器,自动判别单条评论是否具备专家级分析水准。
实验前置步骤依旧为TF-IDF向量化,将每条文本转化为高维数值向量。区别于一代方法的余弦相似度匹配,本方案将TF-IDF特征输入逻辑回归监督学习模型,完成文本分类任务。
逻辑回归是经典的机器学习分类算法,无需人工设定固定规则,可从标注样本中自主学习专家评论的语言特征、用词规律,实现新文本的自动判别。这是语义检索的重要升级:系统从“人工规则驱动”迭代为“数据规律驱动”。
模型流水线代码结构如下:
model = Pipeline([
    ("tfidf", TfidfVectorizer(
        ngram_range=(1, 2),
        lowercase=True,
        min_df=1,
        stop_words="english"
    )),
    ("classifier", LogisticRegression())
])
模型训练完成后,针对学生评论文本可输出两类结果:分类标签、专家级匹配概率。概率越接近1,文本风格与分析逻辑越贴合专家水准;概率低于0.5则判定为新手级文本。本次学生评论最终判定为专家级标签,匹配概率0.672。
逻辑回归的核心优势依旧是可解释性:模型为每一个TF-IDF特征分配独立权重,可直观定位影响分类结果的核心词汇。
本次实验核心特征权重展示:
| 特征词汇 | 逻辑回归权重 |
|---|---|
| 情感 | 0.150719 |
| 构图布局 | 0.148277 |
| 层次感 | 0.146912 |
| 明暗对比 | 0.146912 |
模型对“情感”“构图布局”“层次感”“明暗对比”等专业分析词汇赋予高权重,这类词汇普遍出现在结构完整、分析深入的专家评论中;而“好看”“我觉得”“作者想要”等主观口语化词汇权重极低,多见于新手泛泛而谈式的评论。
但该方法存在本质局限:模型并非真正理解画作内涵与语义逻辑,仅能捕捉文本表层用词规律。当相似语义采用完全不同的词汇表达时,模型会无法识别文本关联。这一短板,推动了第三代向量嵌入语义检索技术的出现。
3.3 方法三:基于稠密向量嵌入的语义检索
第三代语义检索彻底突破TF-IDF词频统计的局限,不再以词汇频次表征文本特征,而是依托Transformer预训练模型,生成稠密语义向量嵌入,真正实现语义级匹配。
该阶段是语义检索的核心转折点:系统彻底摆脱表层词汇匹配的桎梏,开始精准捕捉文本深层语义。即便两篇评论用词、句式完全不同,只要核心艺术理念、表达内核一致,模型即可判定为高相似度文本。
本实验采用Hugging Face开源的句向量Transformer模型完成向量生成,可将单句、整篇文本转化为固定维度的稠密数值向量,精准封装文本核心语义与文本间的关联关系。
例如三组语义一致、用词迥异的表述:“光影的戏剧化运用”“细腻的光线处理”“强烈的明暗对比效果”,表层词汇差异极大,但核心语义高度契合。不同于TF-IDF与传统机器学习模型,向量嵌入模型可精准识别这类隐性语义关联。
本实验全新选取一批差异化评论样本,部分评论采用专业术语表述,部分采用通俗间接的语言阐释相同艺术理念,构建更贴合真实场景的高难度检索任务——文本核心概念相近,但关键词重合度极低。
完成所有评论的向量生成后,我们在向量空间内通过余弦相似度计算文本相似度。句向量Transformer生成的每条评论向量均为384维稠密向量,每一维度对应模型学习到的文本语义特征。
本次实验采用两种相似度计算方式:1. 学生评论与所有专家评论逐一比对相似度;2. 学生评论与专家评论向量中心值比对相似度(见表2)。其中,专家向量中心值由所有专家评论向量各维度数值取平均值生成,同样为384维向量,可直观代表专家级评论的整体语义特征,用于衡量学生评论与专家写作风格、分析逻辑的契合度。
| 学生评论名称及主题 | 专家契合度得分 |
|---|---|
| S1-光影营造与情感表达 | 0.802 |
| S4-情感主观感受评析 | 0.618 |
| S5-画面形式分析尝试 | 0.765 |
| S6-整体观感泛评 | 0.75 |
| S7-画面象征意义解读 | 0.73 |
为直观解析向量空间的语义分布规律,本文通过主成分分析(PCA)将高维向量降维至二维可视化(见图2),在保留核心语义特征的前提下,清晰呈现文本间的语义关联。
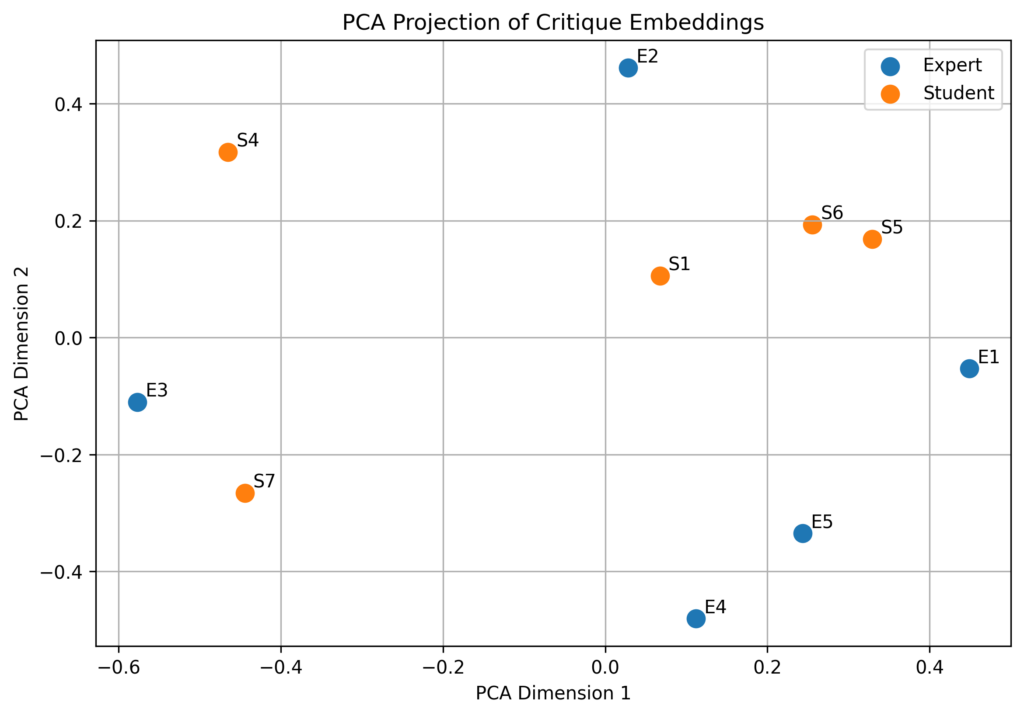
PCA可视化图谱呈现出显著的语义规律:学生评论S1与专家评论E1、E2聚类贴近,三者均聚焦光影、色调、画面氛围与情感张力,核心分析维度高度统一。
学生评论S7与专家评论E3语义距离相近,二者均围绕画作象征意义、深层情感内涵展开解读,即便用词、句式差异较大,依然被模型判定为高度相关。
同时图谱显示,学生评论与专家评论并未形成完全割裂的聚类区间:部分分析深入、逻辑完整的学生评论,语义特征与专家评论高度重合;而内容笼统、分析浅薄的泛化评论,在向量空间中则远离专家评论聚类区域。
专家契合度得分与PCA可视化结果完全匹配:S1得分最高(0.802),与核心专家评论语义最贴合;S5(0.765)、S6(0.75)次之,语义匹配度良好;S7得分中等(0.73),精准贴合象征意义解读类专家评论;S4得分最低(0.618),该评论侧重个人主观感受,缺乏专业艺术分析维度,与专家评论语义差异最大。
该阶段方案实现了从关键词匹配到语义理解的跨越,但存在核心局限:模型生成的文本嵌入向量是固定静态表征,无法根据上下文动态调整语义解读。这一短板,催生了可动态适配上下文的微调式Transformer检索模型。
3.4 方法四:Transformer微调模型检索
第四代检索方案是语义检索的最终进阶形态,核心为微调预训练Transformer模型。第三代方案仅依托预训练句向量模型生成静态语义向量,而本方案基于标注的专家、新手评论数据集,对Transformer模型进行专属任务微调,实现精准的文本等级分类。
本次实验选用Hugging Face开源的DistilBERT预训练模型,该模型是BERT的轻量化优化版本,通过知识蒸馏技术缩减模型参数、提升推理速度,同时保留原版BERT绝大多数的语言理解能力,轻量化、易训练、性价比高,适配小数据集实验场景。
本方案核心逻辑为迁移学习:模型无需从零开始学习语言规律,依托海量通用文本预训练积累语言知识,再针对艺术评论分类任务做专项微调适配。同时,Transformer的注意力机制可精准捕捉句子内词汇关联、句式结构与上下文语义逻辑,实现深度文本理解。
模型训练流水线包含三大核心步骤:
1. 文本分词处理:将评论文本转化为模型可识别的输入格式;
2. 预训练模型微调:基于标注数据集迭代训练,优化模型权重;
3. 分类概率生成:输出单条评论的分类标签与置信度得分。
核心代码实现如下:
# 加载分词器
model_checkpoint = "distilbert-base-uncased"

tokenizer = AutoTokenizer.from_pretrained(
    model_checkpoint
)

# 文本分词处理函数
def tokenize_function(example):
    return tokenizer(
        example["text"],
        truncation=True,
        padding="max_length",
        max_length=128
    )

# 批量处理数据集
tokenized_dataset = dataset.map(tokenize_function)
代码中的预训练分词器不仅完成基础分词,还同步实现多项文本预处理操作:拆分文本为独立词元、映射词元至模型词汇表生成数字ID、添加Transformer专属特殊标记、截断超长文本、补全短文本至固定长度、生成注意力掩码,最终输出模型训练与推理所需的标准化数值输入。
其中truncation=True用于截断超过128词元的超长评论,padding="max_length"为短文本补零填充,确保所有输入序列长度统一、格式规范。dataset.map方法可批量完成全数据集分词,快速生成可直接用于模型训练的标准化数据集。
与第三代静态向量嵌入方案不同,本方法属于有监督分类任务,可同时输出文本分类标签与各类别置信度得分。
以如下评论文本为例:“画面人物布局与阴影的巧妙运用,让整幅画作充满心理张力与象征歧义。”
该文本包含“心理张力”“象征歧义”“构图布局”等专业术语,传统TF-IDF模型会因高频专业词汇,直接判定为专家级优质评论。但Transformer模型可突破孤立关键词的局限,深度解析文本逻辑完整性与论证细节:该评论虽用词专业,但分析维度单一、论述浅显,缺乏专家级评论的深度拆解与细节佐证,整体仍属于新手级分析文本。
经过100轮迭代微调后,模型精准完成分类:
预测标签:0(新手级)
置信度:0.685
新手级概率:0.685
专家级概率:0.315
实验发现,仅迭代30轮的模型会误将该文本判定为专家级评论,核心原因是训练初期模型过度依赖专业关键词特征;随着迭代次数增加,模型逐渐摒弃单一词汇判定逻辑,重点学习文本上下文逻辑、分析深度、论证完整性等高阶语义特征,分类精度显著提升。
同时,Transformer微调方案存在明显短板:模型参数量庞大,需要海量标注数据支撑才能实现良好泛化能力。本文实验所用教学数据集样本量有限,持续多轮迭代训练后,模型易出现过拟合问题——预测置信度极高,但本质是记忆了训练集文本风格特征,而非真正掌握通用语义理解规律,对陌生新文本的适配性较差。
该方案完整闭环了语义检索的迭代演进路径:从人工启发式规则评分、传统机器学习特征学习,到静态语义向量嵌入,最终实现基于上下文的Transformer深度语义理解。四代方案层层递进,完整诠释了语义检索与自然语言处理领域的核心发展趋势:从人工定义特征规则,逐步迭代为模型自主学习语义、上下文与语境关联的高阶表征。
四、结果分析与讨论
本文介绍的四代语义检索方案,清晰展现了技术从基础关键词匹配到深度上下文语义理解的完整演进脉络,各代方案各有优劣、适配场景差异化显著。
第一代TF-IDF+规则评分方案,结构简单、可解释性拉满,可精准追溯每一次排序结果的成因。但该方案高度依赖文本表层词汇匹配,无法捕捉深层语义关联,语义理解能力极其有限。
第二代基于TF-IDF特征的逻辑回归模型,摒弃了人工定制规则,通过标注数据自主学习文本风格与词汇关联规律。依托模型习得的特征权重,可清晰区分专家与新手评论的核心用词差异。但模型始终无法理解文本语境与语义内涵,仅能依托词汇频次关联完成分类,仅在固定用词风格的场景下表现稳定。
第三代句向量嵌入方案是行业核心转折点,彻底摆脱词汇表层匹配桎梏,实现真正的语义相似度匹配。即便文本用词、句式完全不同,只要核心思想一致,模型即可精准识别语义关联,适配复杂多变的真实文本场景。
该方案的核心特点是文本质量无绝对界限:部分学生评论虽整体属于新手级写作范畴,但核心分析思路、语义表达贴近专家视角,在向量空间中与专家评论高度贴合。需注意的是,本方案仅调用预训练模型生成静态向量,未做专项微调,属于无监督语义匹配范式。
第四代微调Transformer模型,通过DistilBERT实现动态上下文语义理解。第二代与第四代方案均为监督学习范式,但核心原理差异极大:逻辑回归依托固定TF-IDF词频特征学习浅层规律,而微调Transformer通过解析词汇关联、句式结构、上下文语境,习得动态语义表征,实现高阶语义推理。
第三代与第四代方案虽均基于Transformer架构,但应用逻辑完全不同:前者将Transformer作为静态特征提取器,核心用于通用语义相似度匹配;后者对Transformer原生权重做任务级微调,让模型适配专属分类任务,从“通用语义匹配工具”升级为“任务专属分类器”,实现了从语义相似度检索到监督式专项任务学习的核心跨越。
同时,实验印证了Transformer微调的核心痛点:大模型依赖海量标注数据,小数据集场景下极易出现过拟合问题,模型高置信度预测结果往往不具备通用泛化性。
整体而言,四代方案代表了自然语言处理的四种核心语义表征逻辑:TF-IDF聚焦关键词频次特征、向量嵌入模型聚焦全局语义相似度、微调Transformer模型聚焦上下文语境与深层逻辑关联。
五、总结
本文以艺术评论相似度匹配为实战场景,完整拆解了从经典TF-IDF检索到现代微调Transformer模型的四代语义检索技术,系统对比了不同NLP方案的文本表征逻辑与相似度判定机制。
实验证明,各代技术均有不可替代的适配场景:传统检索方案简洁高效、可解释性极强,适配轻量化、高追溯性需求;向量嵌入模型无需微调,小数据集场景下即可实现优质语义匹配;微调Transformer模型具备顶级上下文语义理解能力,但对标注数据量级要求极高。
核心实验结论:文本语义理解是一个渐进的维度,而非绝对的二元判定。部分新手文本可实现局部专家级语义表达,现代NLP系统的核心演进目标,正是让机器更精准、细腻地读懂人类语言的语义、语境与思想关联。
本文配套四代方法完整开源代码:
https://github.com/theomitsa/Semantic-Search-Evolution
实验所用人工合成评论数据集已内置在代码仓库中,可直接调用复现实验。
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802022788号






