


 发帖

 雷达卡



本文是《企业文档智能体系》系列的检索模块。该系列将企业级RAG系统拆解为四大核心模块逐步搭建:文档解析、问题解析、检索、生成。
检索是第三个核心模块,本文为检索系列三篇文章的第一篇,主打核心思维模型:检索的本质是筛选,而非搜索;基于行数据表(line_df)和目录表(toc_df)做筛选,选取极小精准锚点,拓展充足大范围上下文。
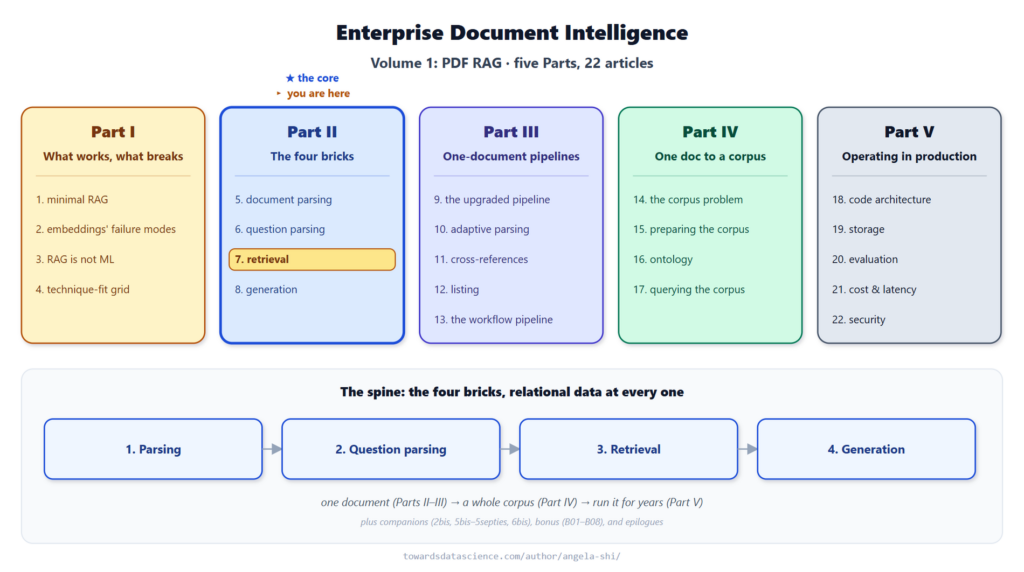
本文在系列中的定位:第二篇章(四大核心模块)第7篇(检索模块),核心思维模型篇——作者配图
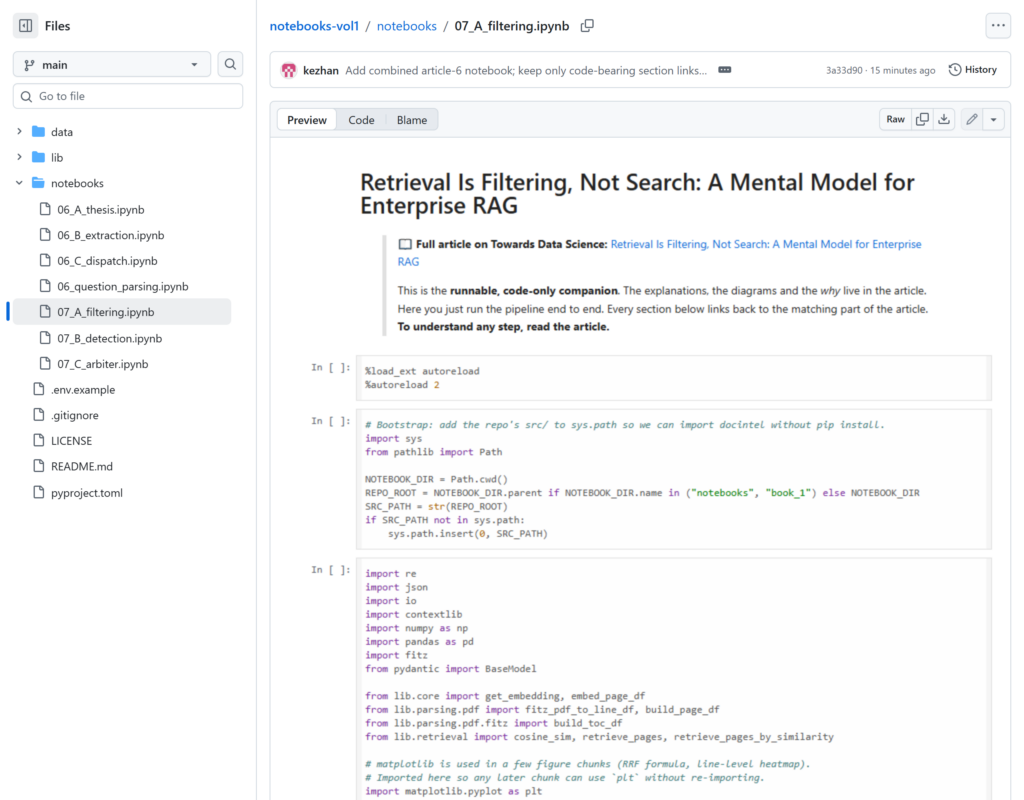
📓 可运行代码笔记已上传 GitHub:doc-intel/notebooks-vol1
本文配套笔记:07_A_filtering.ipynb
我们先来观察人类的文档检索方式。
职场员工想要查询本年度带薪休假天数,打开人力资源政策PDF,使用快捷键查找(Ctrl+F)输入“休假”。页面跳出15条匹配结果,分布在标题、目录等不同位置。用户快速定位对应段落、阅读规则,一分钟内即可获取答案。
这并非新手的笨拙操作,而是专业人员最高效的检索方式:依托文档内置关键词、官方目录结构,定位疑似段落并完整阅读。在这套成熟的人工检索流程中,不存在嵌入相似度计算。
但关键词检索时常失效:文档中使用“带薪休假(PTO)”而非“休假”,或是目标文本位于扫描件页面、无法被关键词检索识别。从业者会尝试替换近义词多次检索,若依旧无结果。
此时专业人员会切换检索逻辑:打开文档目录,快速浏览章节标题,点击最匹配的“休假与调休”章节,通读正文获取信息。这套先关键词检索、检索失败再依托目录导航的兜底逻辑,是三十年来专业文档检索的核心工作范式。
本文为检索系列三篇开篇,将拆解这套人工检索范式背后的核心思维:检索不是搜索问题,而是基于两张结构化数据表(line_df、toc_df)的筛选问题。同时首次提出锚点与上下文的核心区分概念(信号匹配位置 vs 投喂给生成模型的内容),为后续两篇文章奠定理论基础。后续将详解检索流水线运行机制(《RAG锚点检测:并行检测器+单次大模型终判》)以及结果排序仲裁机制(《大模型仲裁器:检索末端智能择优RAG页面》)。
本文核心理念:赋能专业检索逻辑——将人工成熟的检索流程代码化、工程化,实现超越人工的检索效果。具体优化三点:
人工仅能单次输入单个关键词,系统可一次性检测单页面/单章节内的多关键词共现关系,检索精度更高。
扫描件文本无法被人工检索识别,系统在文档入库阶段通过解析模块完成OCR识别,让图片内文本与普通文本一样可检索、可筛选。
人工需手动翻阅目录定位章节,系统可通过代码自动关联目录与正文,精准锁定目标章节,仅在对应章节内执行关键词筛选。
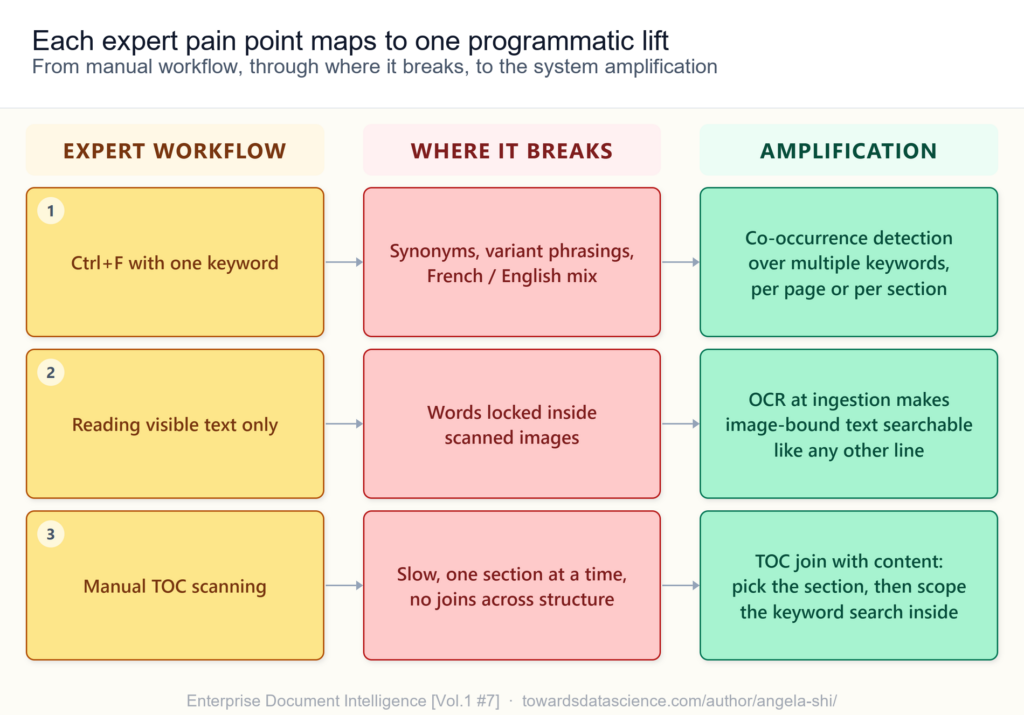
在解析模块输出干净规整的结构化数据表后,检索就彻底转变为结构化筛选任务:筛选存储正文的行数据表(line_df)、存储文档结构的目录表(toc_df)。本文重点搭建这套核心思维模型,后续两篇文章将基于该模型落地具体工程机制。
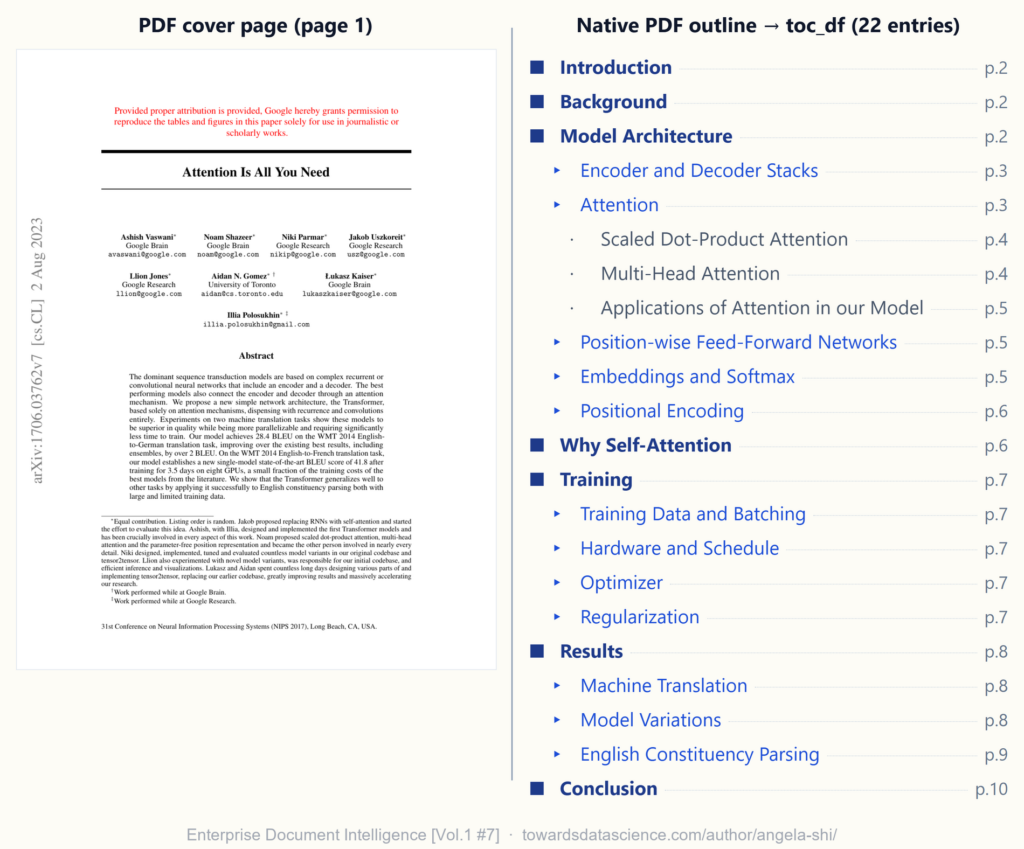
本文全程以经典论文《注意力机制详解》(2017,瓦斯瓦尼等人,共15页,arXiv公开开源协议)作为测试样本。该PDF自带完整三级目录结构,共计22个目录条目,内容涵盖编码器、解码器、注意力机制、查询、键、值等RAG开发核心知识点,可让读者专注学习检索方法,无需耗费精力适配垂直领域语料。本文默认文档自带原生目录,无原生目录的文档结构还原方案将在后续文章讲解。
一、检索的本质:结构化数据表筛选
行业主流认知将检索定义为:匹配与用户问题最相似的文本片段。该认知存在误导性,会建立错误的技术思维模型。
在解析模块完成结构化处理后,检索不再是传统意义上的自由文本搜索,而是结构化数据表的精准筛选任务。本文讲解的所有检索方法,本质都是对 line_df(文档正文行数据)、toc_df(文档目录结构数据)的行筛选逻辑。其思维模型更接近SQL查询,而非谷歌模糊搜索。
思维模型的革新,解锁了传统自由文本搜索无法实现的检索能力:
字段精准筛选:仅筛选指定章节文本、正则匹配文本、嵌入相似度匹配片段、关键词交集匹配标题等,精准限定检索范围。
多表关联查询:先在正文行数据中匹配关键词,再关联目录表查询该行所属章节,结合章节标题相关性加权打分,提升检索准确性。
轻量化大模型筛选:可对仅有几十条数据的目录表执行大模型精细筛选,规避上万行正文数据表因token过大、无法单次调用大模型的限制。
解析模块输出完整结构化数据体系:line_df 存储正文文本、行号、页面坐标、章节ID;toc_df 存储层级化目录结构;page_df、image_df 补充完善全量文档数据模型。在检索阶段,文档已彻底脱离无结构自由文本形态。
用户问题同样经过前置预处理:问题解析模块将原始自然语言问题,转化为标准化检索查询对象,包含关键词、筛选范围、结构特征、上下文适配宽度等核心参数。检索流程最终对接两类结构化数据:左侧是数据表结构化文档,右侧是标准化检索请求。
这套逻辑并非前沿黑科技,而是真实业务中高效文档检索的通用范式。但主流教程从未提及,因其始终固化「文档=无结构文本、检索=向量相似度搜索」的落后认知。
1.1 文档结构化:两大核心数据表
解析模块输出的两张数据表,承载了绝大部分检索任务,二者的数据体量直接决定适配的筛选方法。
行数据表 line_df(高密度细粒度表):每行对应文档的一行文本,长篇合同可包含数万行数据。字段包含正文内容、页码、页内行号、边框坐标、关联章节ID。数据量大、粒度极细,每一行都是潜在答案来源,因此行数据筛选必须轻量化、低成本。模型最终引用、生成答案所依托的原始文本,均来自该表。
目录表 toc_df(低密度粗粒度表):每行对应一个文档章节,企业常规文档仅20-100条数据,极简文档不足10条。字段包含章节标题、层级、页码范围、父章节、唯一章节ID。数据量小、粒度宽泛,单条数据覆盖文档大片内容,因此目录表可承载高复杂度筛选逻辑。该表是文档的「导航地图」,仅用于定位答案所在章节,不存储具体正文内容。
两张表的体量差异彻底重构检索逻辑:适用于目录表的复杂操作(全量表大模型推理、条目嵌入、多跳推理),完全无法用于海量行数据表;适配行数据表的高效操作(正则匹配、快速关键词打分),用于稀疏目录表则毫无意义、浪费算力。
优质检索流水线必然双表联动:依托目录表缩小检索范围、锁定目标章节,再通过行数据表定位章节内精准文本,两张表通过章节ID完成关联匹配。
1.2 单一检索方法的局限性
以保险合同的四类真实提问为例,可清晰证明:单一筛选逻辑、单一检索粒度无法适配全部场景。所有提问都需要两层独立粒度判定:锚点(文档中信号匹配位置)与上下文(投喂给生成模型的周边内容)。
精准字段提取(保单号查询):大海捞针式检索。锚点为单个专属文本字符(多位于页眉),上下文仅需首页少量文本(约5行)。
定点数值查询(年度保费查询):精准条款检索。锚点为包含「保费」关键词及对应金额的条款行,上下文为该条款所属完整章节(50-200行)。
批量列举提问(卖方全部义务查询):多位置全域检索。锚点为文档中多处分散的义务条款片段,上下文为全文所有包含义务内容的章节(500-2000行)。
范围总结提问(质保章节总结):定向章节合成。锚点为目录表中的「质保章节」标题,上下文为该章节全部正文内容(200-1500行)。
若所有场景统一采用「余弦相似度+Top5最高分片段」的通用检索方案,至少三类提问会出现检索失效。精准检索的核心,是匹配对应的筛选结构、筛选字段、锚点位置与上下文范围。本文后续内容将完整拆解这套适配逻辑。
上述第一类「保单号查询」,正是经典的大海捞针基准测试(卡姆拉德,2023)的核心场景:在超长上下文植入精准短句,考验模型精准定位能力。前沿大模型在该基准中近乎满分,但该结果存在极强误导性。
行业极易陷入误区:将单一场景有效性泛化,认为「无需检索,直接全量投喂上下文即可」。该方案仅适配精准单点匹配场景,完全无法应对数值查询、批量列举、章节总结等绝大多数企业业务场景。合同义务列举、多保单保费对比、全章节无遗漏总结,都绝非单一「文本针」可解决。
该基准仅验证了极小一类检索任务,无法代表企业全场景需求,不能作为生产环境省略检索环节的依据。
为直观对比优劣,我们以经典RAG入门基线方案做测试:针对「注意力机制如何计算」的提问,标准答案位于论文3.2章节公式区块。采用通用页面嵌入+余弦相似度Top-K检索,最终仅返回五页相似度排序结果,无章节结构、无兜底未命中逻辑——作者配图。
本文后续讲解的所有方法,均依托解析模块提取的文档结构化特征,全面优于该传统基线方案。
二、两大检索粒度:锚点与上下文
行数据筛选只是检索的一半核心,另一半关键逻辑同样不可或缺:信号匹配的锚点与用于生成的上下文是完全独立的两个粒度,不可混为一谈。本文定义的「锚点」,对应信息检索领域的命中点、信息抽取的触发点、问答任务的证据片段,本文统一采用锚点,便于与上下文概念配对理解。
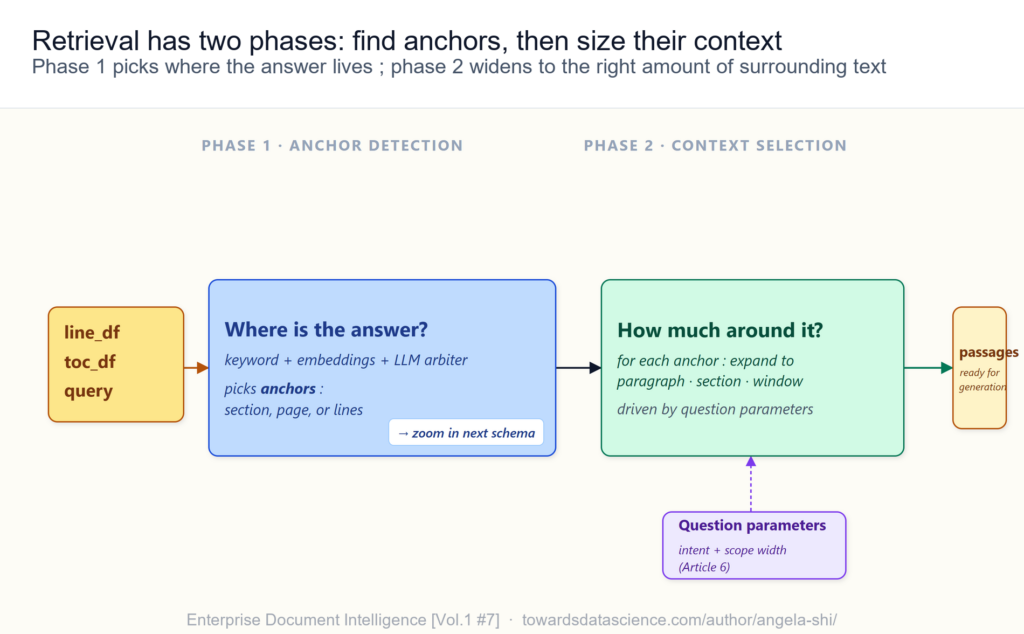
完整检索分为两个阶段:
阶段一:定位锚点——通过关键词匹配、嵌入相似度计算筛选双表,最终由大模型统一排序,输出少量精准锚点(章节、页面、单行文本),确定答案所在位置。
阶段二:拓展上下文——根据用户提问意图与预设上下文宽度,围绕锚点拓展段落、完整章节或固定行数窗口,生成最终投喂给生成模型的内容。
阶段一锚点检测机制将在7B文章详解,阶段二大模型仲裁排序机制将在7C文章详解,2.4小节将具体讲解上下文拓展策略。
合规人员检索「责任条款」时,Ctrl+F仅能命中单行匹配文本,但人工绝不会只读单行,而是通读整段、甚至完整章节。此时,锚点是单行文本,上下文是数百行关联内容。
具象化举例:可将锚点定为 line_df 中包含「保费」的单行文本,再拓展所属完整章节作为上下文,让模型结合完整语境解读金额条款;也可将锚点定为 toc_df 中「第五章:专属免责条款」的章节标题,再提取 line_df 中该章节全部正文作为答案依据。两大粒度为独立设计逻辑:
锚点粒度(小而精准):支持单行、单标题、单句级别,是打分排序的核心依据,锚点越小,信号越纯净、干扰越少。
上下文粒度(大而充足):支持段落、完整章节、固定行窗口,是生成模型的输入内容,上下文越完整,越能避免证据碎片化、答案残缺。
RAG流水线最常见的致命错误:将锚点与上下文粒度合并,以固定分块作为唯一检索单元,既丢失了细粒度锚点的精准度,又因分块范围过窄导致上下文证据不足、答案失真。本文全程严格区分两大粒度。
2.1 锚点粒度:信号匹配的精准范围
检索「免责条款」时,可选择不同粒度作为打分匹配单元,结果天差地别:
单行匹配:仅当文本行包含关键词时判定命中。
段落匹配:段落内任意位置包含关键词即判定命中。
章节标题匹配:章节标题包含关键词即判定命中。
章节正文匹配:章节全文任意位置包含关键词即判定命中。
长文档中,章节标题级别的锚点筛选,远比正文级匹配更具针对性、精准度更高。
2.2 上下文粒度:匹配后的内容拓展范围
精准定位锚点后,需拓展合适内容投喂生成模型,可选范围如下:
仅匹配单行:极少使用,上下文过窄、信息残缺。
周边段落:适配多数常规问答场景。
所属完整章节:适配列举、总结类大范围提问。
前后固定行数窗口:适配无清晰章节、段落结构的文档。
line_df 中的单行匹配结果,几乎无法直接支撑答案生成,上下文拓展是检索信号转化为可用答案依据的核心步骤。
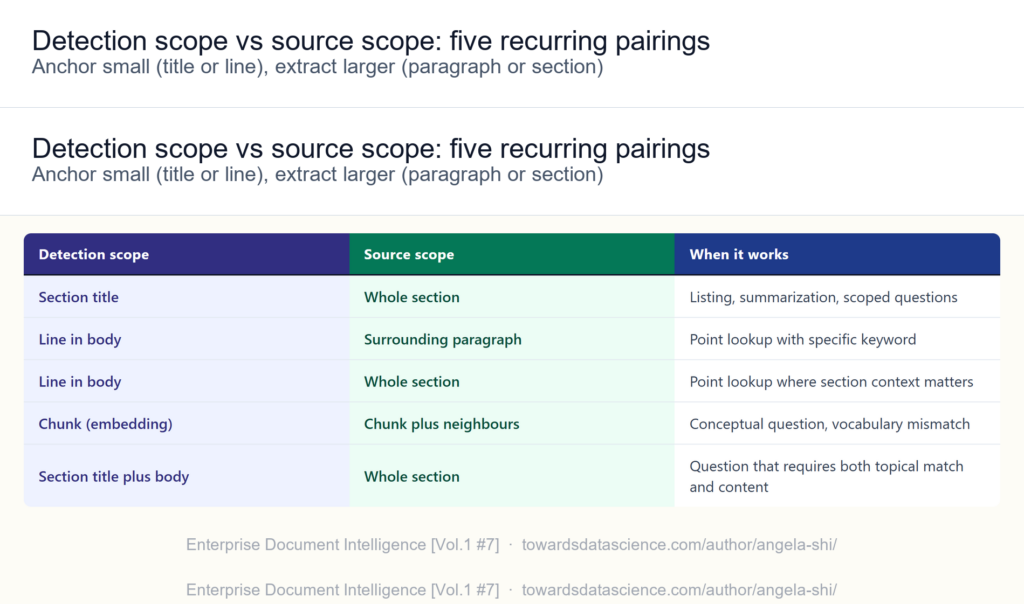
两大粒度完全独立,可自由组合:行级锚点+章节级上下文、标题级锚点+正文级上下文,不同组合适配不同业务场景。
实操案例:用户提问「洪水灾害的免责条款有哪些」。系统先在 toc_df 中以标题为锚点,命中「第五章:专属免责条款」;该标题仅为定位导航依据,并非答案本身。随后关联 line_df,提取第五章全部正文内容作为上下文,最终从正文中筛选出所有洪水相关免责规则。
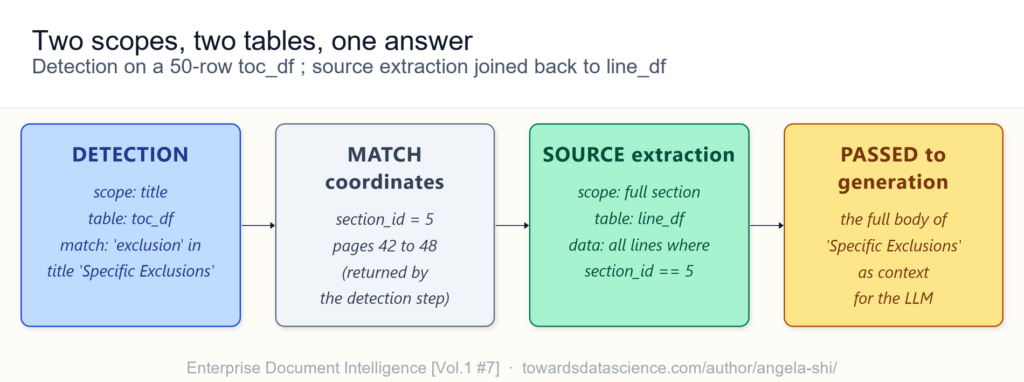
该案例中,锚点来自仅50条数据的目录表,完整答案依托行数据表拓展生成。双表联动、双粒度分离的设计,让检索从模糊匹配变为精准可控的结构化筛选。这套「先定位、后拓展」的标准化实现方案,将在7B文章详细讲解。
2.3 提问类型与粒度适配规则
五大高频业务提问类型,对应固定的锚点与上下文适配方案:
字段提取型(生效日期查询):锚点为包含「生效日期」关键词与日期格式的单行文本,上下文为对应整页内容,用于核验字段准确性。
章节检索型(免责条款汇总):锚点为「免责条款」章节标题,上下文为该标题至下一标题之间的全部章节正文。
条件查询型(合同是否涵盖洪水风险):锚点为包含「洪水」关键词的文本行,上下文为所属完整章节,用于核验条款覆盖/免责状态。
定向开放总结型(卖方义务汇总):锚点为包含「卖方义务、职责」的章节标题,上下文为对应完整章节,必要时拓展全文关联内容。
全域筛选开放型(哪些合同责任上限低于100万欧元):锚点为包含「责任上限」及对应金额的文本行,上下文为所属段落(核验金额有效性),叠加全域文档类型元数据筛选。
核心范式始终统一:小锚点精准定位信号,大上下文充足支撑生成。解析模块输出的行数据提供细粒度锚点,页面与章节结构提供大范围上下文,目录表精准界定章节边界。
2.4 匹配转上下文:三种拓展策略
检索输出的核心结果为各类锚点(行ID、章节ID、分块ID),几乎不能直接投喂生成模型,必须先完成上下文拓展。
原因很简单:孤立锚点无完整语义。例如锚点文本「每年12.5万欧元」,脱离上下文无法判定对应保费、赔偿额或限额;拓展段落上下文后,才能明确其为「年度基础保费,可依据3.4章节调整」。
三类通用上下文拓展策略,覆盖绝大多数文档场景:
段落拓展:提取匹配行所属完整段落,适配绝大多数常规问答任务。
章节拓展:针对列举、全文总结类提问,依托toc_df界定章节边界,提取完整章节内容。
窗口拓展:针对无清晰段落、章节结构的文档(访谈稿、长文随笔),提取锚点前后固定N行文本。
策略选择依据:用户提问意图、答案形态、文档结构完整性。通过调度器自动匹配最优策略,保障模型作答精准、引用有据。
以下为两种核心拓展策略的可运行代码:
# 基于锚点行号与页码,拓展完整章节上下文
def expand_to_section(line_num, page_num, line_df, toc_df):
    # 匹配锚点所属章节ID
    anchor_section_id = line_df.loc[
        (line_df["line_num"] == line_num) & (line_df["page_num"] == page_num),
        "section_id",
    ].iloc[0]
    # 获取章节起止页码
    sec = toc_df[toc_df["section_id"] == anchor_section_id].iloc[0]
    # 筛选章节内全部文本行
    in_section = (line_df["page_num"] >= sec["start_page"]) & (line_df["page_num"] <= sec["end_page"])
    return "\n".join(line_df[in_section]["text"])

# 基于锚点行号,拓展前后N行窗口上下文(默认前后5行)
def expand_window(line_num, page_num, line_df, n=5):
    # 筛选当前页面所有文本行
    page_lines = line_df[line_df["page_num"] == page_num].reset_index(drop=True)
    # 定位锚点行索引
    i = page_lines.index[page_lines["line_num"] == line_num][0]
    # 截取窗口文本并拼接
    return "\n".join(page_lines.iloc[max(0, i - n) : i + n + 1]["text"])
以论文第4页注意力公式所在首行文本为锚点,分别执行窗口拓展与章节拓展,可清晰看出两种策略的上下文覆盖差异——作者配图
2.5 无原生目录文档:章节边界判定方案
拥有原生toc_df的文档,章节拓展简单高效:以锚点为起点,下一目录条目为终点,边界清晰无需推理。但无原生目录、无合成目录的文档,无法依托结构化数据界定章节,需从文本内容本身识别边界,这也是文档AI的核心难点之一。
行业主流研究方案盘点:
解析时标题检测:从锚点向后遍历,通过字体大小、加粗样式、章节正则(第X章、X节)识别标题,判定章节终点。优势是简单高效,劣势是无法适配无视觉格式规范的文档。
文本分块算法(TextTiling):1997年提出的经典算法,通过滑动窗口检测词汇相似度突变点,以此判定章节边界。适配访谈稿等纯文本,核心调参点为窗口大小。
嵌入分割算法:延续滑动窗口思路,通过句子向量余弦相似度的阈值突变识别边界,阈值为核心可调参数。
大模型截断判定:向大模型投喂大范围后续文本,让模型主动判定话题终止行号。精度最高,但单提问调用成本最高。
以上方案均有成熟研究支撑,各有调参逻辑、失效场景与基准适配规则,单独落地即可形成完整研究课题。
本系列工程落地方案:复用生成阶段的原有大模型,无需新增独立模型与算法。生成模块读取检索推送的上下文后,除输出答案外,同步反馈三大信息:上下文是否话题偏移、答案是否超出当前窗口、是否需要补充上下文。
依托该反馈形成闭环流水线:生成模块判定话题未结束,检索模块自动拓展上下文窗口,重新生成答案。由使用上下文的模型,自主判定上下文边界,无需训练专属分割器、无需校准阈值、无需维护额外算法组件。
核心工程理念:科研研发与企业工程落地是两套逻辑。章节边界检测有大量前沿研究,但企业落地无需重复造轮子,优先选择适配现有工具、低成本、可落地的方案。
当前大模型推理成本已大幅下降、延迟可控,企业流水线完全可承受单次额外推理调用。工程最优解明确:适度投入推理算力,规避复杂自定义分割算法的长期维护成本。
该理念并非万能复用大模型:简单确定性规则可解决的场景,优先使用规则,兼顾成本与速度。但技术选型默认逻辑已迭代:科研负责探索前沿算法,企业工程负责选取最简落地方案。检索领域极易陷入「堆砌前沿论文算法」的误区,生产落地最优解,往往无需复杂科研级技术。
三、总结
1.检索的核心本质:绝非自由文本搜索,而是基于解析模块输出的 line_df、toc_df 两大结构化数据表的筛选任务,所有检索方法均是对双表数据的精准筛选逻辑。
2. 双粒度核心设计:锚点与上下文相互独立。锚点追求小而精准(单行、单标题),作为打分排序依据;上下文追求大而充足(段落、全章节),作为生成输入依据。合并双粒度是RAG流水线最频发的核心错误。
3. 检索双阶段范式:阶段一精准定位答案锚点,阶段二依托提问意图拓展适配上下文。
基于该核心思维模型,后续文章将详解完整流水线机制:7B《锚点检测》讲解双表并行检索、特征聚合、大模型终判的三段式流水线;7C《大模型仲裁器》讲解智能方法决策、未命中兜底逻辑、检索与生成的标准化JSON数据契约。
本文隶属于《企业文档智能体系》系列,该系列的极简RAG流水线方案,可实现从PDF原始文件到高亮精准答案的全链路落地。
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802022788号






