


 发帖

 雷达卡



发布说明:针对发布的整理性或加工的表格数据类型资源(发布要求)
1、上传整理或者重新计算加工过的数据类型资源,请说明原始数据来源以及计算依据,便于用户核对以及使用。
2、如果没有任何计算依据或者原始数据来源说明,针对用户的购买需进行售后解答说明。
3、如果没有任何解答以及说明,购买用户进行投诉,发布者不能证明数据的真实性,平台将退款处理。
不一定要懂高深数学,但必须理解数据背后的“行为逻辑”。均值、方差、相关、分布、抽样、显著性——这六个概念,撑起了数据分析师日常工作的“统计地基”。
很多想转行做数据分析的人,第一个问题往往是:“我数学不太好,能学吗?”答案是:能。普通数据分析岗位的核心工作——取数、清洗、制作报表、AB测试分析、业务归因——并不要求推导公式或证明定理,但它要求一种统计思维:当看到一个数字波动时,你能判断它是“正常震荡”还是“异常信号”;当对比两组方案时,你能说清楚“差异是否值得相信”。
一、六块“压舱石”:打好统计基础的地基
在实际工作中,以下六个统计概念几乎每周都会用到,它们共同构成分析师判断数据可信度的基本框架。
均值与方差是描述数据的“第一把尺子”。均值告诉我们“平均水平”,方差(或标准差)告诉我们“波动有多大”。国家统计局2025年数据显示,全国规模以上工业企业利润增速在不同行业间的方差达到近五年高点——如果只看均值,会误以为整体平稳,但拆开方差才知道哪些行业在下滑、哪些在扩张。同样的道理,当分析师给业务方汇报“客单价环比上升5%”时,若不同地区之间的客单价标准差极大,那么这个“均值”对不同区域而言参考价值截然不同——方差决定了均值能否代表整体。

分布形态决定了该用哪种“尺子”量数据。大多数业务数据(如用户消费金额、页面加载时长)并不服从完美的正态分布,往往呈长尾或偏态分布。如果不了解分布,直接套用正态假设去设定预警阈值,会出现频繁误报或漏报。中国信通院《数据资产管理实践白皮书》曾指出,超过40%的企业在异常检测中因未正确识别数据分布而导致模型误判率偏高——这不是算法问题,而是对数据来源和分布特征的认知缺失。
抽样方法直接关系到分析结论能否“以小见大”。做用户调研、质量抽检或AB测试时,分析师几乎不可能拿到全量数据,必须依赖抽样。市场监管总局2025年发布的《产品质量监督抽查管理办法》明确要求抽检样本需满足随机性和代表性——这背后正是统计抽样的基本原理。如果抽样有偏(比如只在工作日白天收集用户反馈,忽略了夜间和周末用户),再复杂的分析模型也救不回结论。
显著性检验则是判断“差异是不是真差异”的核心工具。业务方经常问:“新版页面转化率比旧版高了1%,要不要全量上线?”统计学告诉我们,这个1%可能是抽样误差导致的假波动。只有通过显著性检验(通常以p值<0.05为参考标准),才能量化这种差异“不是碰巧”的概率。中国信息通信研究院《2025年数字化运营报告》统计,已建立标准化AB测试流程的企业中,约27%的“明显提升”在经显著性检验后被认定为统计不显著——这意味着每四个看似成功的优化里就有一个其实是噪音。
相关性是最容易被误读的统计概念。“冰淇淋销量和溺水人数同步上涨”——二者高度相关,但大家都知道不是冰淇淋导致溺水(背后是气温这个混杂因素)。在实际业务中,类似陷阱比比皆是:广告投放费用上升与销售额上升相关,但可能只是因为旺季来了。分析师必须养成习惯——看到相关先问因果链,而不是直接建议“加投放”。
二、AI工具越强,统计基础越重要
当AI工具越来越普及——自动生成统计图表、自动标注“显著”、自动给出分析摘要——分析师的统计门槛看似变低了,实则变高了。因为判断AI输出的结论是否合理,恰恰需要统计基础。
AI可以快速算出两组数据的p值,但它不会告诉你样本是否存在自选择偏差;AI可以画出一条漂亮的回归线,但它不会提醒你数据存在多重共线性或异方差性;AI可以生成描述性统计摘要,但如果输入数据本身分布偏斜严重,摘要中的“均值”可能严重误导业务。这些判断,需要的是统计学底层的“概念直觉”,而非公式推导能力。
在这个背景下,像CAIE注册人工智能工程师认证(简称CAIE认证) 这样的体系化学习路径,提供了一个可参考的框架。CAIE认证由CAIE人工智能研究院颁发,聚焦AI领域的技能等级认证,旨在培养和评估具备理论基础与实战能力的复合型AI人才。认证分为Level I和Level II两个等级,2026年起采用远程上机考试,每月两场,Level I费用200元,Level II费用800元。
其中Level I的 PART 3 面向产出物的思维能力和AI交互(20%) 和 PART 5 AI工作流与商业成果落地(25%) ,要求学习者掌握如何通过结构化交互让AI完成数据处理、统计分析和业务解读——这恰是以统计概念作为“提问基础”的实操环节:如果不理解“显著性”“置信区间”“分布形态”,在Prompt中就无法准确要求AI进行对应分析,也无法判断AI返回的统计结论是否合理。
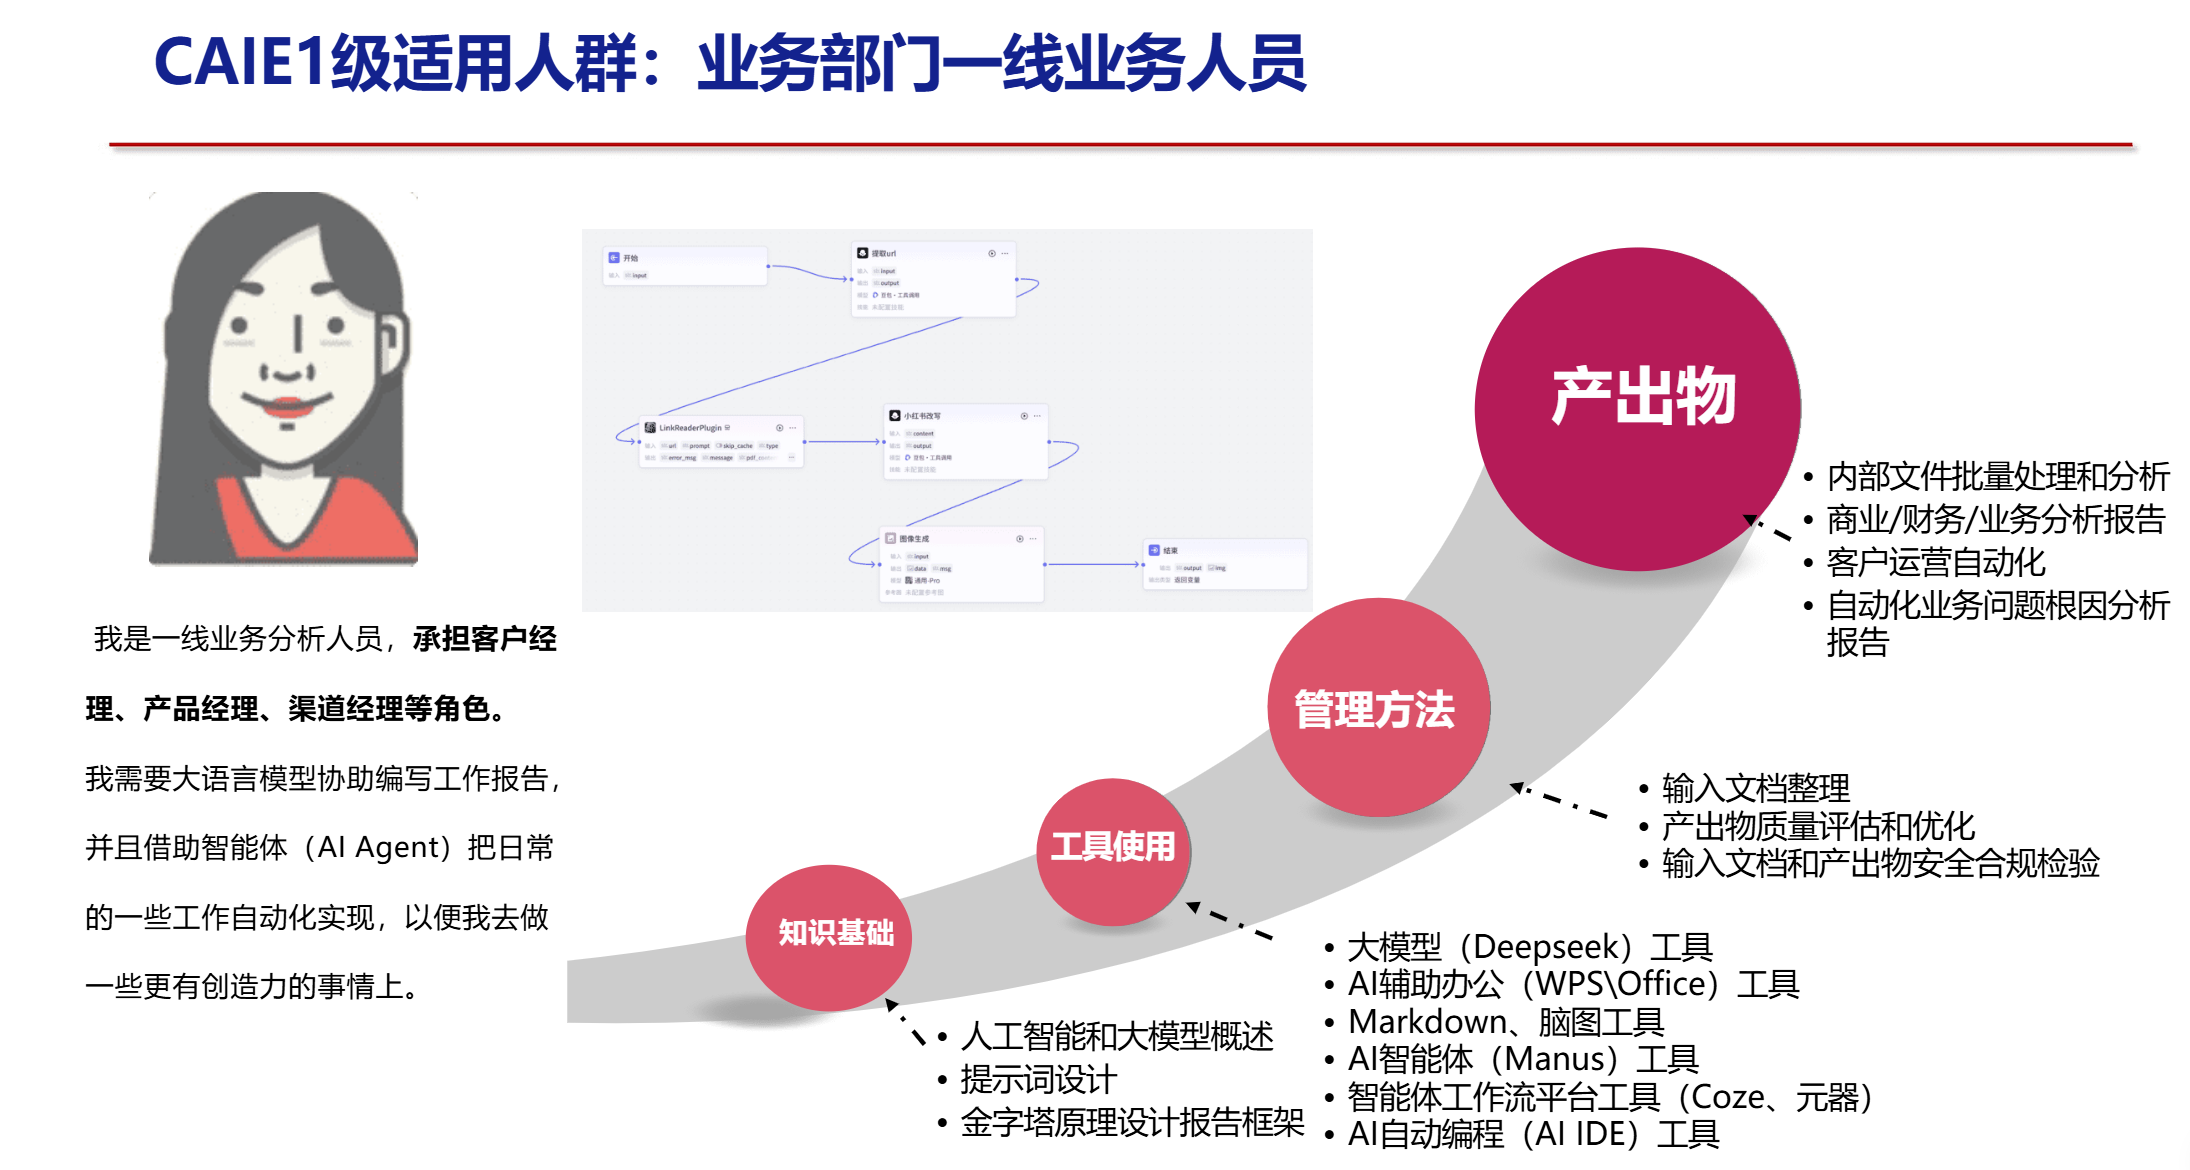
PART 6 RAG、Agent与高级商业策略(20%) 则涉及将统计规则和业务逻辑嵌入知识库与智能体,让AI在辅助分析时主动校验数据质量,避免输出脱离统计常识的结论。以上海制药2025年的定制化AI项目为例,其公开复盘显示项目目标之一正是解决数据连接和分析响应中的逻辑准确性问题——这种“人类判断+AI计算”的协作模式,越来越依赖分析师的统计直觉作为“质检关口”。
三、学到什么程度才算“够用”?
总结下来,数据分析师需要的统计基础可以概括为三个层次:
第一层(必须掌握):能说清均值与中位数的区别、会用标准差衡量波动、能识别常见分布形态、理解抽样误差来源、能解释p值的业务含义、能区分相关与因果。这六项足以覆盖日常报表解读和AB测试沟通。
第二层(建议掌握):了解置信区间构建逻辑、掌握分层抽样与随机抽样方法、能识别常见的统计检验方法(t检验、卡方检验)的适用场景——不要求手算,但要求能判断“该用哪种”。
第三层(按需进阶):涉及回归诊断、时序模型、贝叶斯方法等,通常在高级分析或算法岗才需要。
对于绝大多数数据分析岗位而言,第一层是“及格线”,第二层是“加分项”。企业招聘时看重的,恰恰是你在面对“转化率涨了1%”这样的问题时,是直接给出“上线吧”的建议,还是能追问一句:“这个差异在统计上显著吗?样本量够不够?有没有季节性干扰?”
这,就是统计基础的真正价值。 它不是考试分数,而是一种让数据说话时“不出错、不夸大、不盲从”的职业底线。在AI可以秒算任何统计量的今天,分析师最不可替代的能力,恰恰是那些最基础的概念判断力——而这,正是入行时最值得花时间夯实的地基。

 京公网安备 11010802022788号






