


 发帖

 雷达卡



试想你正在搭建机器学习模型:用简单模型得到了不错的基线效果后,你尝试用更复杂的模型提升性能。开发过程中,产品团队新增了一批可用数据,于是你又退回使用简易模型。完成大规模超参数调优后,团队建议你更换优化指标。当你终于训练完成模型,业务方却调整了项目方向,要求你整体重构模型。
这是数据科学家的日常常态,尤其是在跨团队协作、需求方多变、项目优先级频繁调整的工作场景中。模型开发很容易陷入混乱:反复梳理需求、核对数据源、调整评估指标,耗时费力却毫无章法。在这种混乱的开发模式下,团队必须能够完整追踪模型全生命周期、快速复现实验结果,这就需要模型治理体系的支撑。
模型治理
模型治理是一套团队用于规范模型使用的完整框架,核心包含实验追踪、版本管理、结果可复现等能力。绝大多数团队都是在模型上线生产后,才意识到这项能力的重要性。搭建完善的模型治理流程,能够有效记录模型开发过程、线上运行模型、所用训练数据,帮助企业保障模型质量、满足合规要求、监控机器学习业务的落地效果。
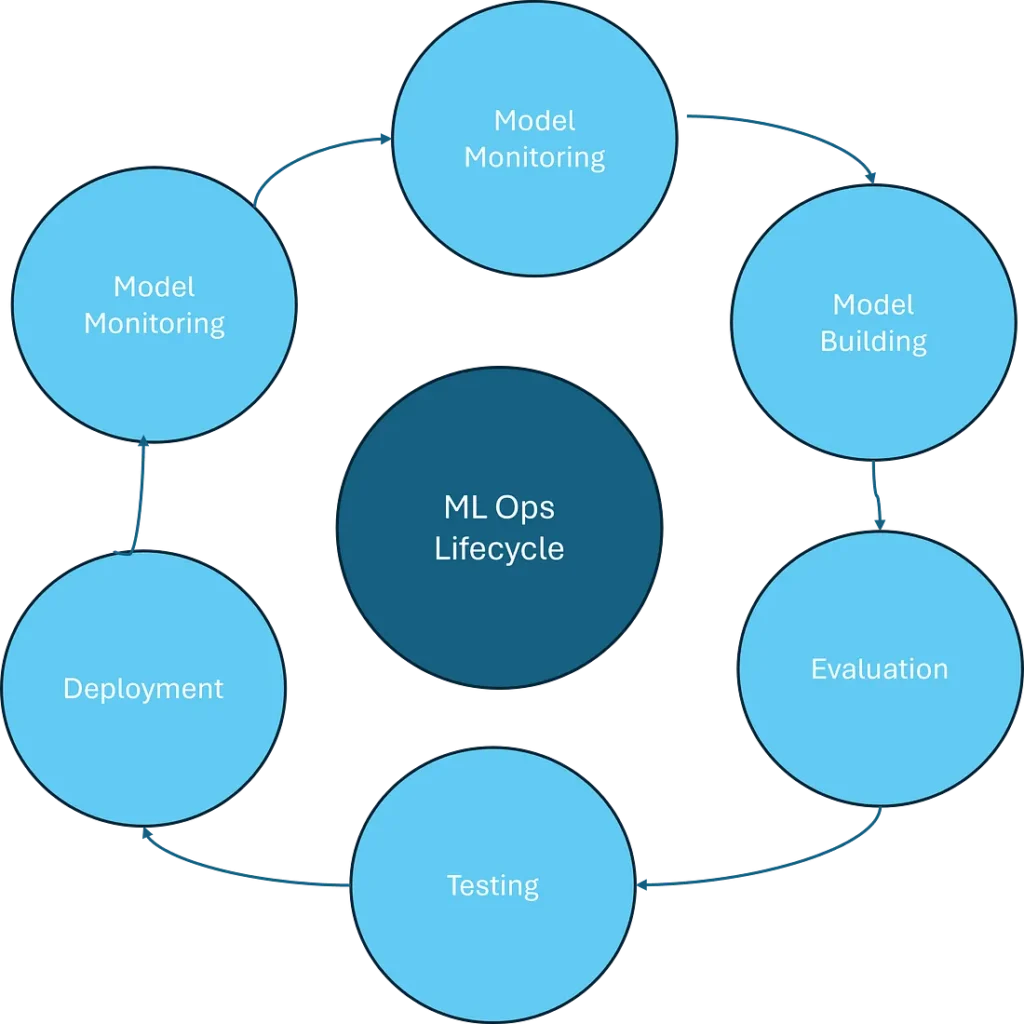
想要确保上线生产的都是最优模型,就需要一套工具来统一管理模型及版本、追踪性能指标、复现实验结果。MLflow 就此应运而生。MLflow 是一款开源的机器学习运维(ML Ops)平台,通过标准化的模型、指标、日志记录机制,实现灵活的模型开发、部署与全生命周期管理。
本文将手把手讲解 MLflow 的安装部署、实验创建、模型日志记录等核心实操流程。
MLflow 实操教程
模型开发
本次教程将搭建一个基础线性回归模型,基于职位名称、公司规模等特征,预测数据岗位的年薪水平。
数据集地址:https://www.kaggle.com/datasets/ruchi798/data-science-job-salaries(公共领域 CC0 协议)。笔者对数据集做了小幅修改,精简了部分特征的取值类型。本文模型仅用于演示 MLflow 功能,模型本身拟合效果较差,不具备实际落地价值。
# 定义自变量与因变量
X = salary_data.drop(columns = 'salary_in_usd')
y = salary_data['salary_in_usd']

# 划分训练集与测试集
X_train, X_test, y_train, y_test = train_test_split(
  X, y, random_state = 104, test_size = 0.2, shuffle = True)

# 单独定义模型超参数,用于后续日志记录
params = {"fit_intercept": True,
         "positive": False}

# 训练线性回归模型
regr = linear_model.LinearRegression(**params)
regr.fit(X_train, y_train)

# 模型预测
y_pred = regr.predict(X_test)
需要注意:我们单独拆分定义模型超参数,是适配 MLflow 日志记录的关键操作。
基于 MLflow 记录模型日志
首先在终端安装 MLflow 依赖,再启动本地服务,搭建可视化操作界面。
pip install mlflow
mlflow server --host 127.0.0.1 --port 8080
完成安装并启动本地服务后,即可开始记录模型日志。在记录日志前,需要先创建实验(Experiment),可将其理解为项目文件夹,用于统一收纳存储所有相关模型、指标、数据及日志。
一个实验包含多次运行(Run),每次运行会独立记录所用模型、超参数、评估指标、产出文件等信息。多次运行日志可横向对比模型迭代效果与性能差异。
下方代码可实现完整流程:创建实验、启动单次运行、记录调整后 R² 指标、保存模型超参数、添加自定义标签、归档训练模型。
import mlflow
from mlflow.models import infer_signature

# 绑定本地 MLflow 服务地址
mlflow.set_tracking_uri(uri = "http://127.0.0.1:8080")

# 创建全新 MLflow 实验
mlflow.set_experiment("Logging Example")

# 启动单次模型运行任务
with mlflow.start_run(run_name = "salary_baseline_regression") as run:

    # 记录模型评估指标:调整后 R²
    mlflow.log_metric("Adjusted R2", r2_score(y_test, y_pred))

    # 记录模型超参数
    mlflow.log_params(params)

    # 添加自定义标签,标注运行任务用途
    mlflow.set_tag("Model Type", "Baseline")

    # 归档训练模型
    model_info = mlflow.sklearn.log_model(
        sk_model = regr,
        artifact_path = 'model',
        signature = infer_signature(X_train, regr.predict(X_train)),
        input_example = X_train,
        registered_model_name = "salary_baseline_regression")
代码运行完成后,可通过链接访问 MLflow 可视化界面:http://localhost:8080/
MLflow 可视化界面操作指南
打开页面后默认进入「实验」标签页,可查看已创建的实验、基线模型的运行记录,以及所有已记录的模型指标与参数。
若页面未展示指标和参数,可通过顶部「列(Columns)」下拉菜单手动添加对应展示项。
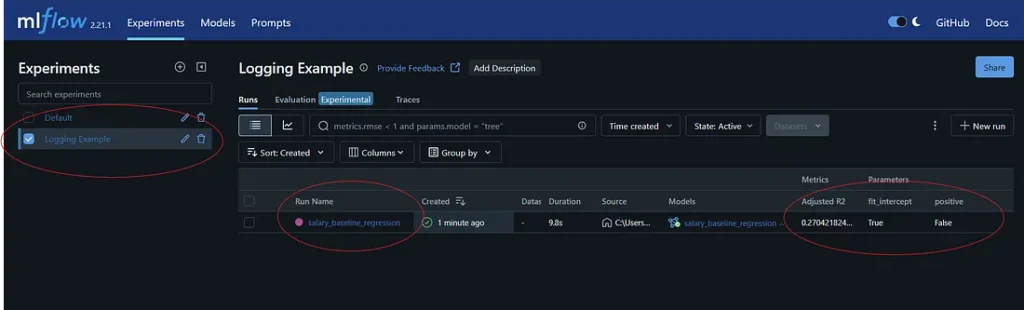
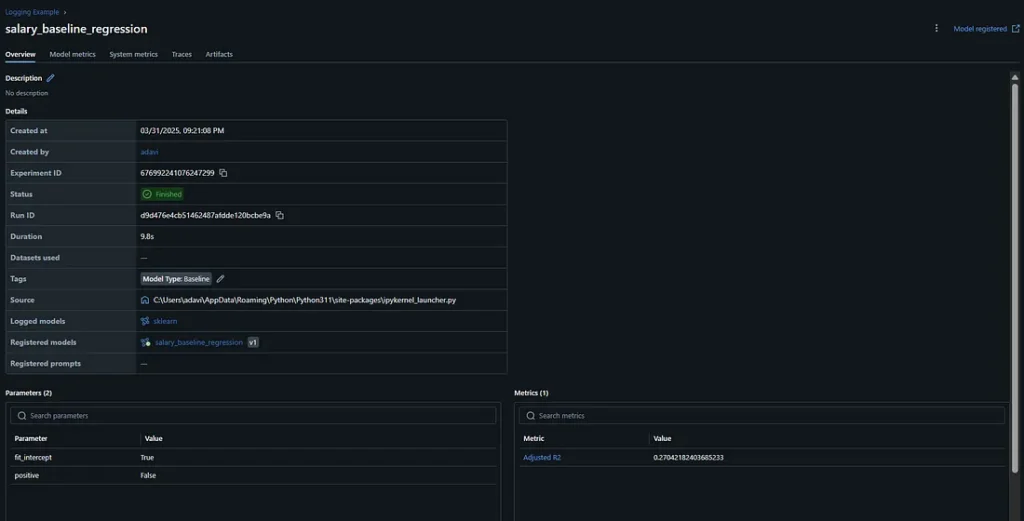
点击运行任务名称,可进入任务详情页,在概览标签页中清晰查看所有归档内容:模型文件、R² 指标、超参数等。
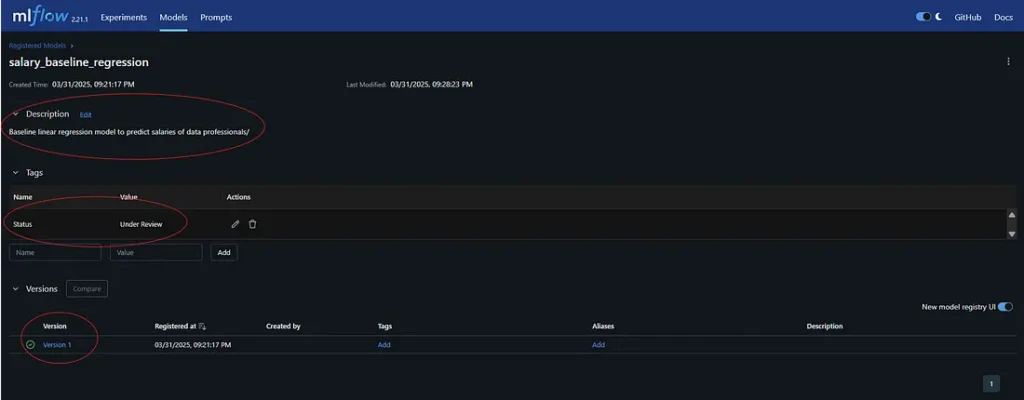
点击模型名称进入模型管理页面,可查看模型详情、补充描述、新增标签、追踪版本迭代。每一次新的模型运行,都会自动生成新版本号。
自定义标签与描述可用于规范化管理模型,区分开发中、审核中、已上线等不同状态的模型,完善项目文档。
以上为 MLflow 基础用法:创建实验与运行任务、记录模型、指标与参数。下文将介绍高级日志功能,实现流程自动化与精细化管理。
高级日志功能
模型迭代过程中,所需追踪的指标会随模型结构、训练策略变化,手动增减指标日志十分繁琐。通过传入测试数据与预测结果,可实现 MLflow 指标自动记录,大幅简化流程。
首先整合测试集数据与模型预测结果,生成评估数据集:
# 整合特征数据与预测结果,用于模型评估
eval_data = X_test.copy()
eval_data["salary"] = y_test
将评估数据集传入 MLflow 并指定目标变量(薪资),即可实现三大核心能力:记录训练数据源、通过 mlflow.evaluate() 自动生成并记录全套评估指标、归档模型可视化结果等产出文件。
# 绑定本地 MLflow 服务地址
mlflow.set_tracking_uri(uri = "http://127.0.0.1:8080")

# 基于 Pandas 数据集创建 MLflow 可识别数据对象
dataset = mlflow.data.from_pandas(
    eval_data, source = 'kaggle', name = "ds_salaries", targets = "salary")

# 创建专属实验
mlflow.set_experiment("Salary Prediction")

# 启动模型运行任务
with mlflow.start_run(run_name = "salary_baseline_regression") as run:

    # 记录训练所用数据集
    mlflow.log_input(dataset, context = "training")

    # 记录模型超参数
    mlflow.log_params(params)

    # 归档模型可视化结果图片
    mlflow.log_artifact('Result.png')

    # 自定义任务标签
    mlflow.set_tag("Model Type", "Baseline")

    # 归档训练模型
    model_info = mlflow.sklearn.log_model(
        sk_model = regr,
        artifact_path = 'model',
        signature = infer_signature(X_train, regr.predict(X_train)),
        input_example = X_train,
        registered_model_name = "salary_baseline_regression")
    model_uri = mlflow.get_artifact_uri("model")

    # 自动评估模型并记录全套指标
    result = mlflow.evaluate(model = model_uri, data = dataset, model_type = "regressor", evaluators=["default"])
重新进入 MLflow 界面并打开本次运行任务,可查看系统自动生成的多项评估指标。同时支持多模型横向对比,通过自动化可视化图表直观展示性能差异。所有归档的可视化文件,均可在「产出文件(Artifacts)」标签页查看。此外,界面会完整展示输入数据的结构与类型,方便开发者在增减特征、更换数据源时,完整追溯数据迭代记录。
MLflow 模型加载与复现
通过模型名称与版本号,可随时从 MLflow 模型仓库中加载归档模型,快速复现实验结果,也可用于线上模型的重新训练与迭代优化。
model_name = "salary_baseline_regression"
model_version = "latest"

# 从模型仓库加载指定模型版本
model_uri = f"models:/{model_name}/{model_version}"
model = mlflow.sklearn.load_model(model_uri)
Databricks 平台集成
MLflow 已与 Databricks 平台深度原生集成,无需本地部署启动服务。Databricks 直接将 MLflow 可视化界面嵌入平台「实验」模块,同时拓展了更多高阶能力,支持生成式 AI 应用、智能体实验追踪,以及 AutoML 模型自动优化功能。完整官方文档可查阅:https://docs.databricks.com/aws/en/mlflow/
总结
模型治理是企业机器学习项目落地的必备能力,是保障模型质量、满足业务合规要求的核心基础。以 MLflow 为代表的实验追踪与监控工具,能够规范化模型治理流程,实现机器学习模型从开发、迭代到部署的全生命周期标准化管理。
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802022788号






