


 发帖

 雷达卡



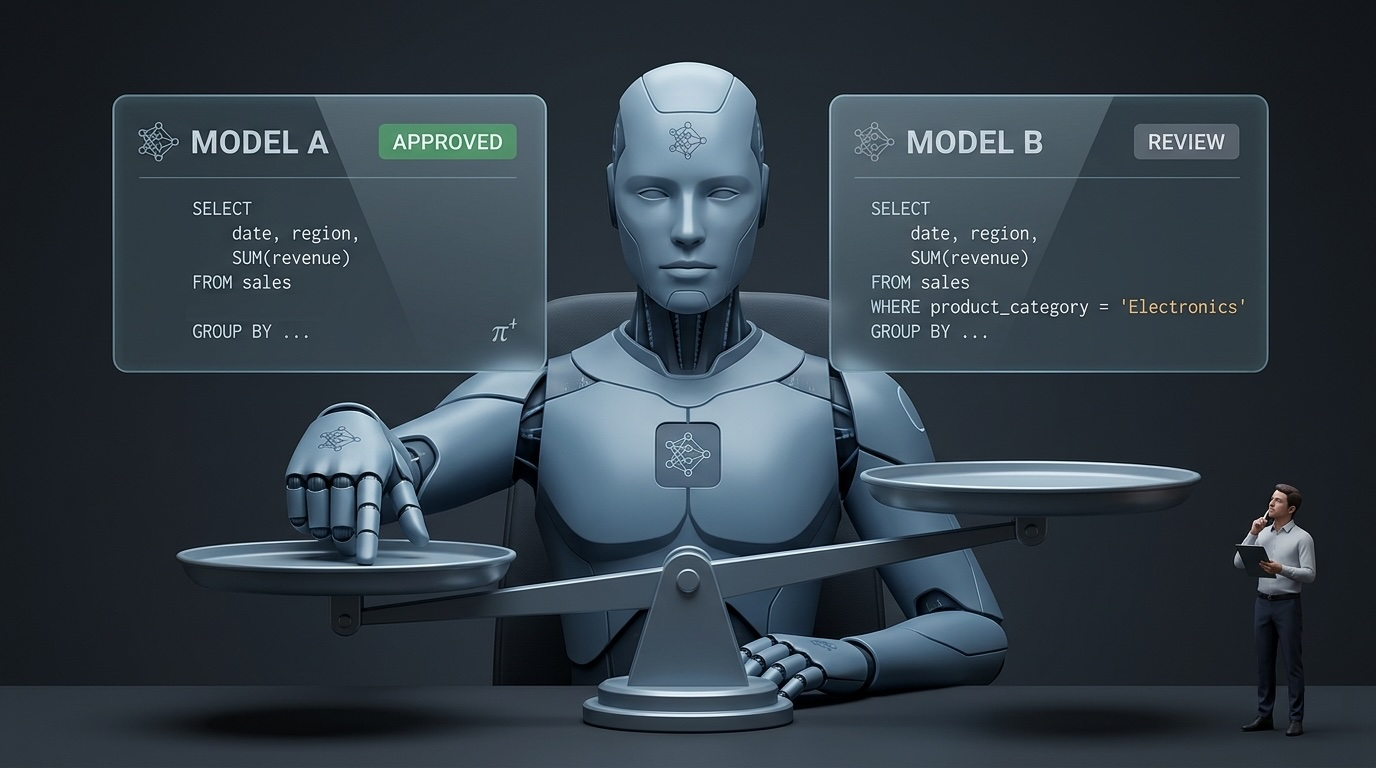
我们搭建了一套多智能体工作流:其中一个智能体根据用户的自然语言问题生成 SQL 语句;第二个智能体充当评审器,判断这条 SQL 是否足够安全、正确,可以直接自动执行,还是需要暂停流程,等待人工确认后再运行。
这套系统平稳运行数周,我们便渐渐放松了监控。直到有一条本应被拦截的 SQL,却通过评审并执行了。事故没有造成严重后果,没有数据丢失,也没有出现误写入数据表的情况,但返回的业务结果完全错误。问题根源在于这条 SQL 悄悄遗漏了用户问题中明确要求的过滤条件。分析师拿着错误数据困惑许久,我们花了半小时排查,才确认拿到的数值本身就是错的。而评审器毫无迟疑,十分笃定地批准了这条存在缺陷的语句。
正是这次事故,让我们不再把 “大模型评审器已通过” 等同于 “结果正确”,转而将评审器本身视作一个需要独立测试的系统组件。
本文框架
事故复盘与最初的错误假设
评审器的真实行为逻辑
评审器会产生哪些隐性偏差
落地有效的修复方案
基于人工标注对评审器做校准
总结
事故复盘与最初的错误假设
我一开始以为,这只是评审器的一次偶然失误。大模型本就无法做到百分之百可靠,偶尔判断出错在所难免,过去也就直接忽略。于是我把相同的用户问题与评审提示词单独拿出来复现测试,预想要么复现错误,要么模型会修正结果。
但评审器再次批准了这条缺失过滤条件的 SQL,依旧给出高度认可的结论。这并不是随机偶发故障,而是可稳定复现的固有模式,说明系统底层机制存在问题。
为定位根因,我调取了一批历史评审记录,将模型给出的判断,和人工评审对同批 SQL 的结论做对比,至此,这套问题模式才清晰显露出来。
评审器的真实行为逻辑
生成 SQL 的智能体和评审智能体,底层使用的是同一个大模型。这并非刻意的架构设计,只是出于成本考量,整套流水线统一选用了该模型。
之后我把待评审样本,替换为另一款模型产出的 SQL;人工核验下,这批 SQL 质量相当、数据表结构也完全一致。此时评审器的判定标准明显变得严格,能够揪出其他模型生成 SQL 里的各类问题,可同类缺陷出现在同源模型的输出时,却会被直接放行。
这就是自偏好偏差(Self‑preference bias),大模型作为评审器的相关研究中早已有该现象记录,并非我们环境独有的问题。直到事故发生,我才切实体会到该偏差的稳定性。评审器不是随机宽松,而是会对识别出的、和自身输出风格结构一致的内容格外宽容。
下面是简化版的生产评审提示词(仅用于演示,非线上真实代码):
JUDGE_PROMPT = """你正在评审根据用户问题生成的SQL语句。
判断是否允许自动执行,或是标记为需要人工复核。

用户问题:{question}
待评审SQL:{sql}
数据表Schema:{schema}

仅返回JSON格式结果:
{{"decision": "approve" | "flag_for_review", "reasoning": 字符串}}
"""

def judge_query(question, sql, schema, client, model="gpt-4o"):
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": JUDGE_PROMPT.format(
            question=question, sql=sql, schema=schema
        )}],
        temperature=0,
        response_format={"type": "json_ob ject"},
    )
    return json.loads(response.choices[0].message.content)
提示词本身没有任何引导评审器放宽标准的描述。偏差并非来自指令,而是源于模型内部认知:评审器会把 “熟悉的行文风格” 默认为 “正确 SQL 该有的样子”。一旦生成端输出刚好匹配这套固有风格,评审器就会倾向于直接放行,和 SQL 本身对错无关。
评审器会欺骗你的几种方式
定位出自偏好偏差之后,我继续挖掘评审器其他系统性错误来源,总结出三类典型偏差:
自偏好偏差(Self‑preference bias) 充当评审的大模型,会给自己或者同系列模型的输出打更高分数,我们的事故正是该问题导致。根源来自困惑度熟悉效应:大模型更愿意给可预测、困惑度更低的文本高分,而这类文本往往出自同源模型。能力越强的模型,识别自身输出行文特征的能力越强,该现象反而会更加明显。
冗长偏好偏差(Verbosity bias) 对比两份答案:一份简洁正确,另一份内容一致,但堆砌大量额外文本。评审器往往更容易倾向篇幅更长的版本。在我们的 SQL 场景中,带大量注释的 SQL 得分,经常高于逻辑完全一致、干净精简的语句。如果你的评分标准包含 “完备性” 这类维度,该偏差会进一步放大。
位置偏差(Position bias) 做两两对比任务时,两份待评估样本的摆放顺序,会直接改变评审结果。保持全部条件不变,仅仅调换两者顺序,模型评判结论就可能反转。该问题排查成本很低:把两组样本交换顺序跑两次,观察结果是否稳定即可。
上述偏差,并不代表大模型评审方案完全不可用。但绝对不能把模型打分等同于单元测试那种客观对错结果。它相当于一位能力尚可,但自带固有偏见的评审人员给出的主观意见。就像团队协作,你需要充分了解同事的认知盲区,才可以合理参考他的评审意见。
落地有效的修复方案
首要改造:评审模型和生成模型选用不同技术系列,引入中立第三方,避免评审者与被评审输出出自同源。该方案直接消除自偏好偏差;如果你遇到同类问题,优先做这一步,它从根源消除问题,而不是靠统计手段去抵消偏差。
# 演示简化代码
def judge_query_neutral(question, sql, schema, generator_model, client):
    # 评审模型与生成模型禁止使用同一系列
    judge_model = "gemini-2-5-pro" if "gpt" in generator_model else "gpt-4o"
    return judge_query(question, sql, schema, client, model=judge_model)
但这套改动无法解决冗长偏好偏差。该偏差和模型厂商无关,根源是评分规则本身会变相鼓励繁杂输出。我原本以为换中立评审模型就能一并消除全部偏差,实际并非如此。这次踩坑很有价值:各类偏差需要分开针对性处理,不存在一招通吃的修复手段。
针对冗长偏差,我们重写评分规范:明确要求评审惩罚多余冗余内容,嘉奖简洁且结果正确的输出。并且在提示词内加入示例:展示一条简短正确的 SQL,优于一份啰嗦、过度铺垫的长版本。比起空泛的 “请保持客观”,给模型具象的好坏示例效果要好得多。这本是提示工程的基础常识,我却在评审器开发阶段忽略了。
基于人工标注对评审器做校准
以上所有优化,都必须使用预留样本集,对照真实人工评审结果持续校验,不能只做一次就完事。
# 演示简化代码
def measure_agreement(judge_decisions, human_decisions):
    agreed = sum(
        1 for j, h in zip(judge_decisions, human_decisions) if j == h
    )
    return agreed / len(judge_decisions)
我们抽取一批已经经过模型评审的历史样本,请熟悉数据表结构的人员做人工打分,评审人员看不到模型之前的判断,之后计算模型与人工结论的一致率。当时我们系统一致率大约在 80%‑85% 区间。该数值仅为我们业务场景下的实测结果,不可以当作其他任务的参考基准。
数字高低不是核心价值。核心是据此划定规则:部分 SQL 逻辑看着合理,但暗藏细微缺陷 —— 也就是诱发本次事故的那类样本,恰恰是模型和人工判断分歧最高的场景。无论评审器给出多高置信度,这类样本现在默认强制流转人工复核,因为该场景下模型的可信度已经被证实不可靠。
当然大模型评审器依然具备不可替代的价值,这点在讨论偏差时常常被忽略:它非常适合做初筛;缺少标注数据集时,可以快速完成样本初标注,人工只复核模型和人工不一致的案例,以此迭代构建正式评估集,不用从零手动打全部标签。偏差客观存在,但解决思路不是直接废弃这套方案,而是认清:模型输出只是一份初评意见,关键场景仍然需要二次校验。
总结
本次事故的 SQL 能够逃过拦截,并不是评审提示词写得太差。根源是我们搭建了评审环节,却默认它是完全中立客观的,但架构层面,评审器天然倾向认可同源模型产出的内容。
如果你在生产环境使用大模型评审器,优先解决同源模型问题,再去修改评分规则文本。仅仅切换评审调用的模型,就可以堵死本次事故对应的故障模式,额外成本仅仅是更换一次 API 调用的模型参数。
重写评分规范、搭建人工校准闭环,才把评审器从 “大多时候能用” 改造为可以管控自动执行流程的可靠组件。事故之后我们落实三条准则:
评审模型与生成模型绝不使用同一系列;
评分规范明确惩罚冗余,杜绝隐性鼓励啰嗦输出;
历史上模型与人工分歧高的样本类别,无视模型意见,强制人工审核。
以上改造无法让评审器做到绝对无误,但可以把故障模式变成已知、可控,落在我们业务可接受的风险范围内。
最后总结一点:大模型评审器获得线上生产的放行权限,逻辑和团队新人获取代码合并审批权限一样。不是刚入职就直接授权,也不能仅凭它推理时语气笃定就完全信任。需要在各类细分场景下充分对比人工结果,搞清楚哪些场景可信,哪些场景必须警惕。
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802022788号






