


 发帖

 雷达卡



本文将探讨如何根据场景选择最合适的代码智能体。
当下,两大顶尖代码智能体无疑是 Claude Code 与 Codex。但我发现二者在不同任务上优劣差异明显,各自都存在短板。 为此,我建立了一套自用的任务分类规则。每次开启新任务时,我都会依据这套规则判断,该交给 Claude Code 还是 Codex 来完成。
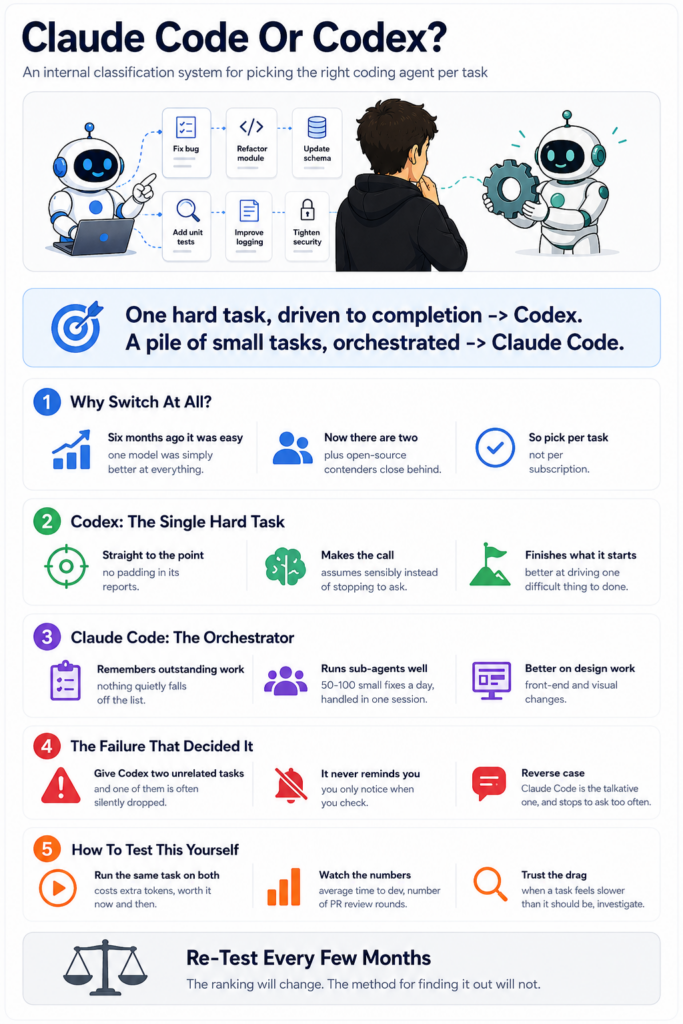
本文就来介绍这套分类思路,分析两款模型各自的优势场景,帮你在合适的任务上选用对应的代码智能体,充分发挥它们的能力。 文中信息图概括了全文核心内容,对比 Claude Code 和 Codex 的优缺点以及适用场景。配图由ChatGPT生成。
为什么要根据任务切换代码智能体?
大约半年前,代码智能体的选择非常简单。Anthropic 的 Opus 系列模型在所有编码任务里都遥遥领先。当然那时也可以选用谷歌代码模型、Codex 等,但在我看来,它们和 Opus 的性能差距十分明显。
但在这半年里,代码智能体的竞争格局发生了巨大变化。目前我认为有两款第一梯队模型:Codex 和 Claude Code,同时还有不少实力接近的竞品,例如 GLM 5.3、Kimi K3。它们都是优秀的代码智能体,只是性能略逊于 Claude Code 和 Codex。
本文重点介绍这两大前沿编码模型。当然,几个月后局面或许又会改变,可能会出现新的顶尖代码智能体。但文中的思路具备通用性:教你识别代码智能体的擅长场景与薄弱环节。我会分析 Claude Code 和 Codex 各自的优缺点,同时介绍如何自行定位模型短板。这套方法无论现在,还是未来代码模型格局大幅变动后,都能帮你为手头任务选出最合适的智能体。
Claude Code 与 Codex 的优缺点
先聊聊两款工具的优劣。一句话简单概括各自适用场景: Codex 更适合攻坚单一高难度任务,力求一次性落地完成;Claude Code 擅长调度多个子智能体,批量处理大量细碎小任务。
下面展开细说,先讲 Codex。整体来看,目前我个人更偏爱 Codex,原因有几点:Claude Opus 5 话太多,即便我在提示词文档里反复强调精简输出,每天还是要多次提醒模型少说废话。
Codex 完全没有这个问题,直入主题。而且 Codex 更倾向于直接动手完成任务,不会反复抛出问题向我确认。而 Claude 更习惯不断提问,任务经常卡在中途无法收尾——除非我主动使用 /goal 指令。
简单来说,面对单个高难度任务,我优先选择 Codex,它把事情做对的能力更强。
你可能会觉得,既然Codex有这个特点,那所有编码任务都该选它。但实际并非如此。日常大量需求来自产品反馈,都是一些小型快速修复任务,并不需要超强模型。这类任务每天可能多达50~100个。 我不想为每一个小任务手动新建独立智能体会话,那样工作量太大。 这时候就需要一个调度编排智能体,去驱动多个子智能体分别完成这些零散任务。而这恰恰是 Codex 的弱项。
Codex 在调度大量智能体、批量处理众多小任务方面表现很差。一般来说,如果你让 Codex 同时处理两件关联度不高的任务,它经常会忘掉其中一项,导致任务无法全部完成。 因此,在批量处理大量细碎任务的场景下,Codex并不合适。
我的任务选择逻辑总结如下: 日常大量小需求,我只开启一个 Claude Code 会话,由它统一管理任务,调用子智能体批量处理。 遇到大型项目、复杂任务时,我会单独新建 Codex 会话,一个任务对应一组 Codex 实例。 另外,设计类任务,或是仅前端改动的需求,我也倾向选用 Claude Code(这类需求大多本身就是快速小修复,我一般直接交给 Claude)。
当然,现状很快可能发生变化。OpenAI 也许会升级框架,或是推出更擅长任务编排的新模型。如果成真,我大概率会全面切换到 Codex。
如何自行判断模型的强项与短板
讲完我对 Claude Code 和 Codex 的选型经验,下面介绍更通用的方法:如何发现一款模型擅长什么、容易在哪里翻车。 先说我是怎么发现上面提到的两款模型问题的。
核心思路是:留意代码智能体的运行表现,在任务完成后复盘,分析它的操作、实现方式与耗时。你甚至可以让代码智能体帮你统计指标,例如:
单任务开发平均耗时 PR 评审轮次
当然,你也可以凭直观感受:如果明显感觉某个任务耗时远超预期,就要留意。举个例子:我用 Claude Code 处理单项任务时,模型总是中途停下来反复询问确认,输出文字冗长,我很难快速看懂它到底需要我做什么。
于是我把完全相同的任务交给 Codex 测试,差别非常明显。Codex 更愿意直接完成任务,自行做出合理假设,整体执行效率更高。 简单来说,我的对比方式就是同一任务,两个模型分别跑一遍。虽然会消耗更多 token,但对于重要任务,定期这样测试,找到最优模型是值得的。
再说说我怎么发现 Codex 不擅长批量小任务编排的:有时候我让 Codex 完成一项主任务,再追加一个小修改、或是一个附属修复,经常发现 Codex 直接忘掉其中一项,需要我反复提醒,甚至提醒后依旧遗漏。 这在实际工作中很难排查。我交给智能体执行任务,本来预期它记住全部事项、做完之后再等待审批,而不是中途遗忘。
于是我改用 Claude Code 编排这类任务,跑同样的需求,发现它能更好地记住待办事项,调度子智能体处理大量零散任务。
结语
本文介绍了编码工作中 Claude Code 与 Codex 的选型策略。在我看来,二者是当前两大顶尖代码模型,但未来几个月格局可能出现很大变化。同时开源模型发展迅猛,性能亮眼,成本远低于闭源前沿模型。 文中对比了两款模型的优缺点,分享了我自用的任务选型规则,同时介绍通用方法,教你自行挖掘模型的能力边界。
核心在于敏锐感知模型的执行快慢与效果好坏。除此之外,我还会做量化评估:定期让代码智能体统计指标,例如开发平均耗时、代码合并前的评审轮次。建议你持续开展这类评估,保证技术栈选型始终处于最优状态。
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802022788号






