


 发帖

 雷达卡



LLM(大型语言模型)已席卷全球。大多数人使用的都是LLM的成熟API——输入提示词,就能得到答案。但他们忽略了LLM背后的架构重要性,以及其优势与待改进之处。模型底层隐藏着许多非直观的设计选择,这些选择直接决定了模型的速度、成本和性能;如果你想构建、微调或优化LLM,这些选择至关重要。
为了端到端理解LLM架构,我仅使用PyTorch从零实现了GPT-2模型,并在此基础上添加了LoRA(低秩适配器)、RoPE(旋转位置嵌入)、KV缓存等功能。在实现过程中,我遇到了很多令人挠头的问题,并一直记录下来。今天,我将分享其中最重要的6个感悟。如需深入了解架构细节,可以查看我之前的深度解析文章,其中包含GPT-2的完整实现流程及分步可视化说明。
1. LoRA与RsLoRA(秩稳定LoRA)的对比
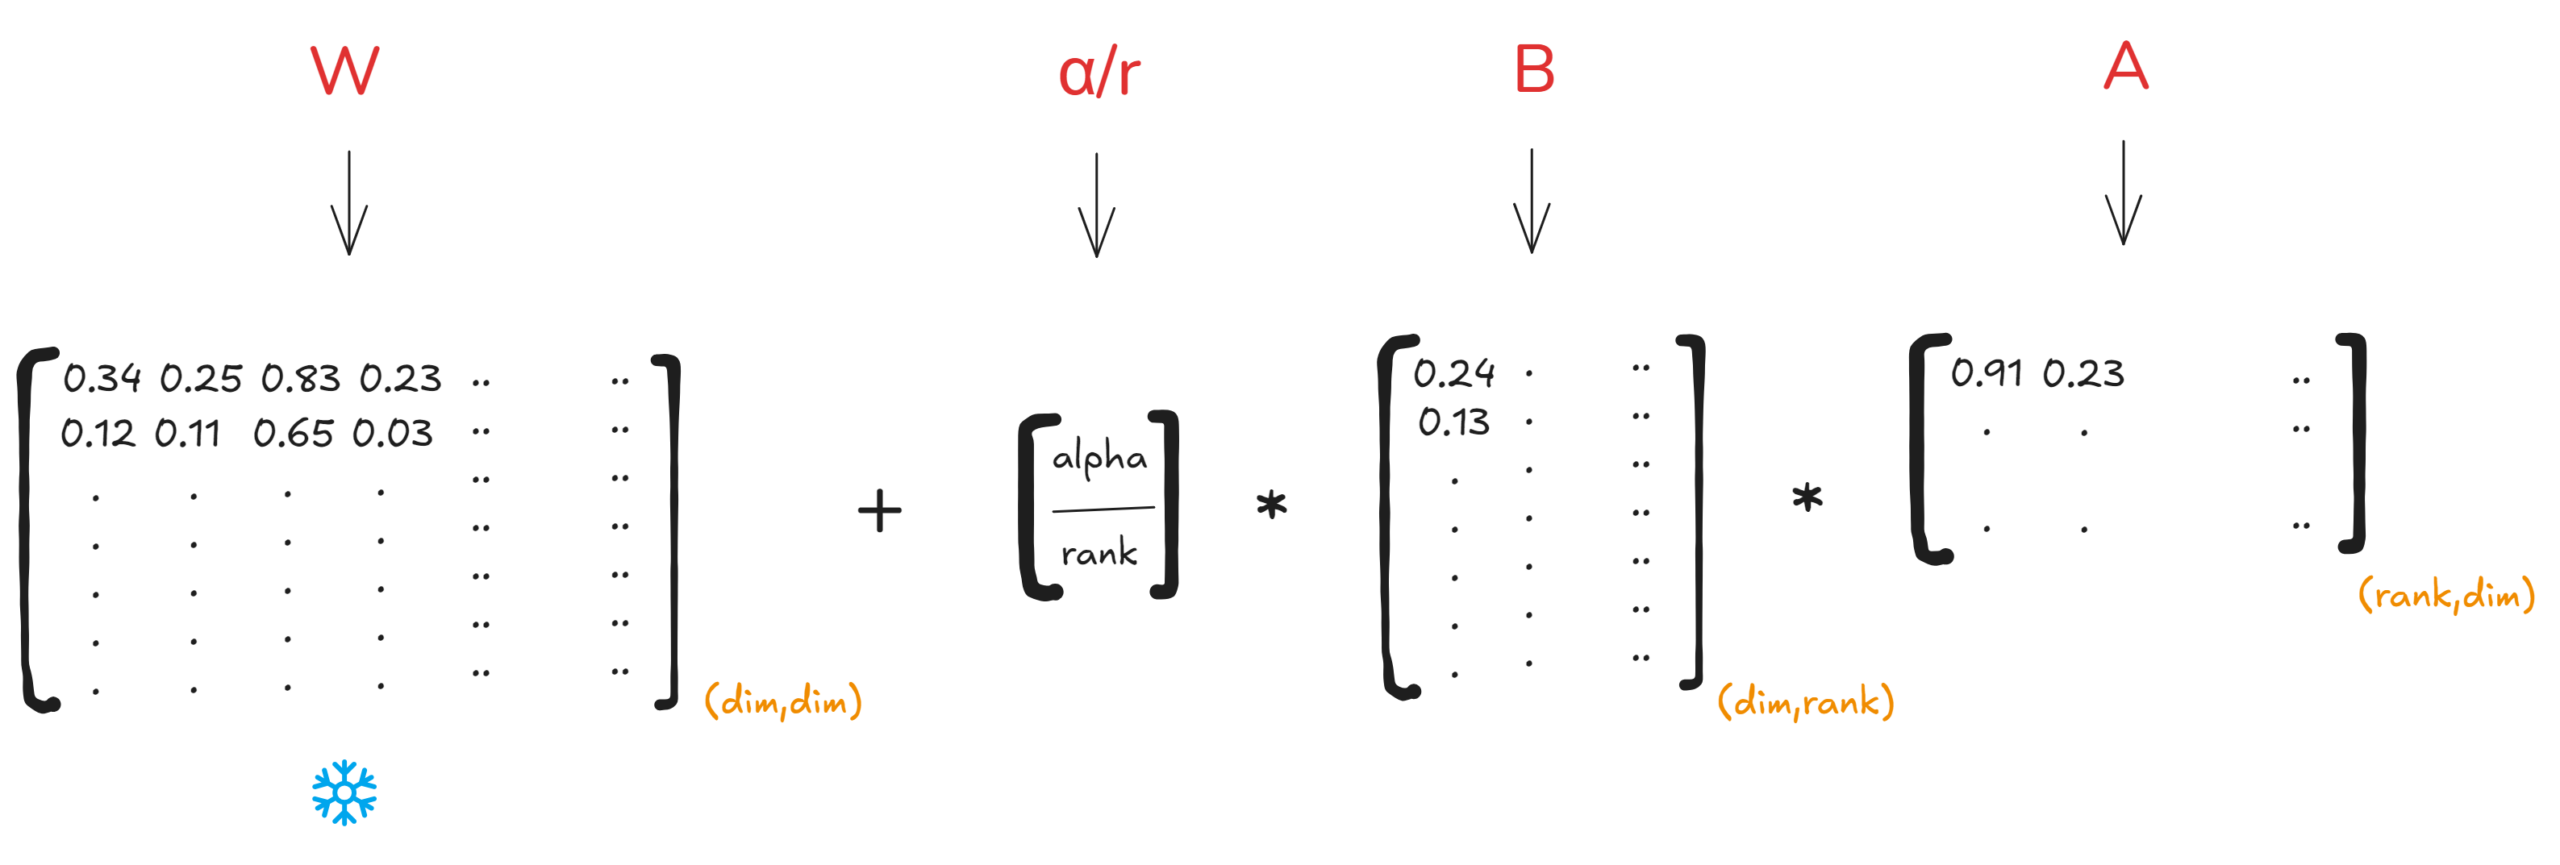
LoRA通过仅训练两个低秩矩阵B和A(形状分别为(维度,秩)和(秩,维度))来微调模型,同时冻结原始权重(W)[1]。这一方式大幅减少了可训练参数的数量(在我的实验中,仅占所有权重的0.18%)。
LoRA包含两个相关参数:alpha(α,缩放系数)和rank(r,秩),其中alpha/秩会作为整体缩放因子。其公式如下:
这个缩放因子决定了微调参数的重要程度。例如,若alpha为32、秩为16,则缩放因子为2,意味着微调权重的重要性会翻倍。以下是直观示意图:
但Kalajdzievski指出,LoRA存在一个问题:当秩不断增加时,用秩来分割微调参数最终会降低权重的重要性[2]。简单来说:秩越大,单个权重更新量就越小,LoRA会在你毫无察觉的情况下逐渐失效。
注:对底层数学原理感兴趣的读者,可参考下方的统计证明;若不关注数学细节,可直接跳至下一部分。
证明过程:微调开始时,矩阵B和A的元素会随机初始化(标准做法是采用正态分布),即Bⱼₖ、Aₖᵢ ~ N(0,σ²)。
因此,当我们增大“r(秩)”时,B*A的方差会成比例增加:
但我们不能就此停止,还需考虑包含缩放因子的完整微调权重(ΔW)的方差:
这表明,随着秩的增加,微调权重的方差会减小,即权重更新量会越来越小。为解决这个“收缩问题”,Kalajdzievski提出了一个简单有效的方案:将公式中的“r”替换为“√r”。此处不再重复计算过程,但替换后会得到Var(ΔW) = r/r = 1,最终实现方差恒定,权重幅度在每次更新时都保持稳定(见下图)。因此,相比LoRA,RsLoRA(秩稳定LoRA)更值得选用。
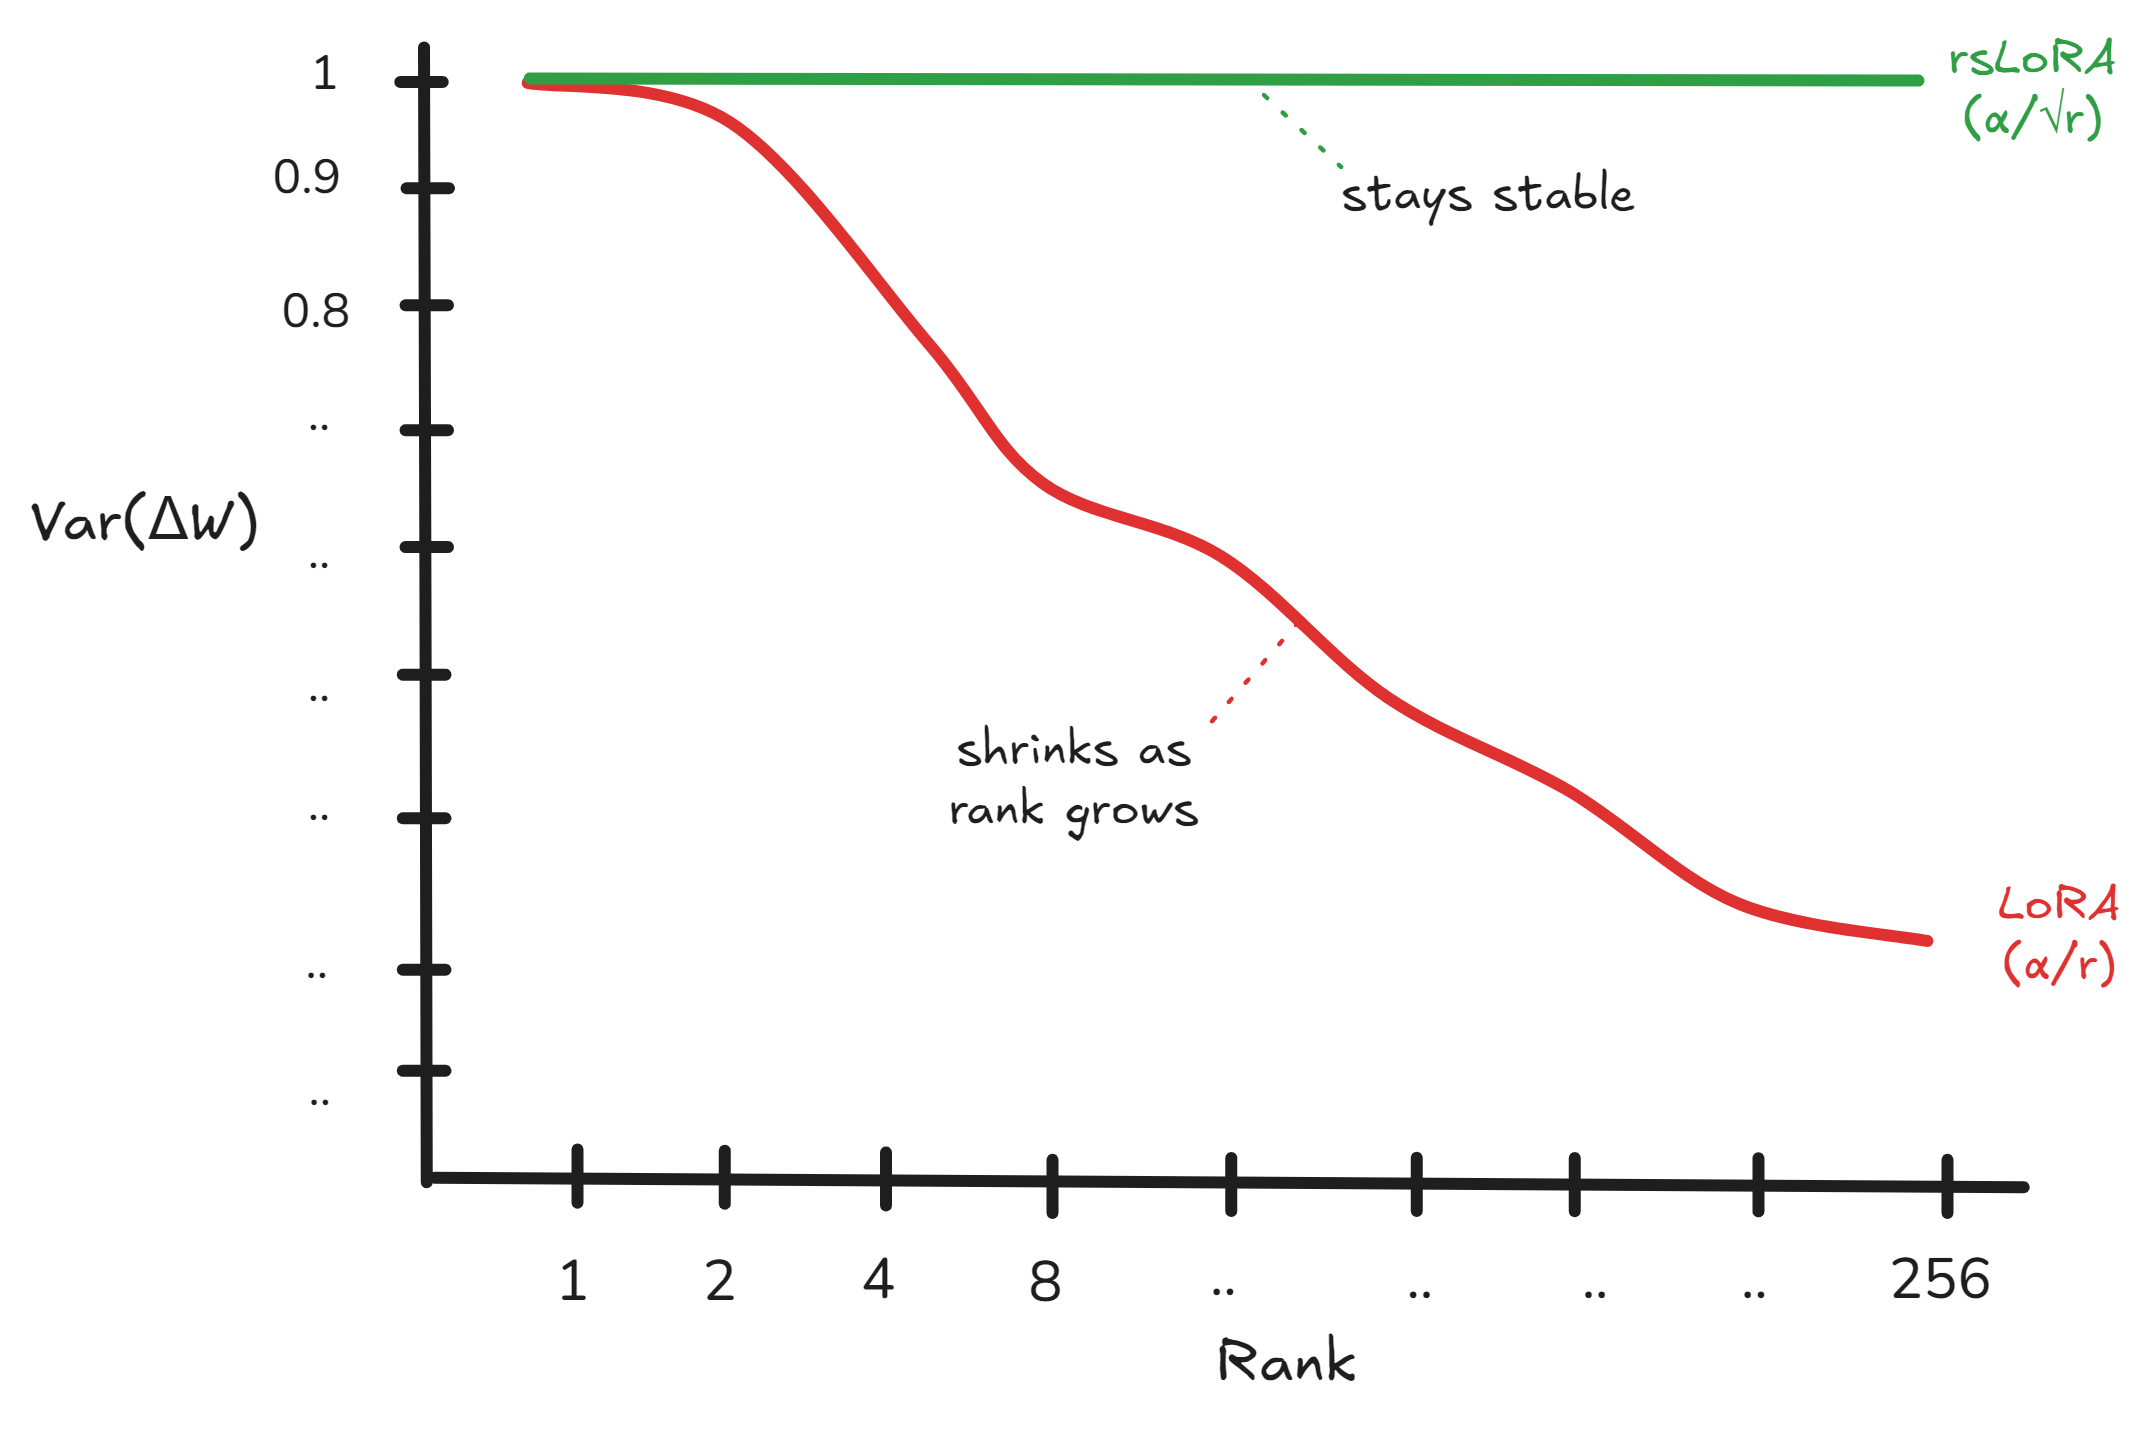
随着秩的增加,LoRA的权重更新量会逐渐收缩(α/r)。RsLoRA通过使用α/√r,实现了方差稳定。图片由作者提供。
2. 优先选择RoPE,而非学习型参数或正弦位置嵌入(PE)
位置嵌入通常被视为次要细节,但我们可能低估了它的重要性——错误的位置嵌入方法可能会彻底毁掉一个大型LLM模型。《Attention Is All You Need》[3]这篇研究论文重点介绍了正弦位置嵌入(Sinusoidal Positional Embeddings, PEs)。这种方法无需参数,通过固定公式生成嵌入值,但存在诸多局限性:固定公式灵活性不足,无法捕捉相对位置,只能提供绝对位置信息;另一个主要问题是,这些位置嵌入会直接与token嵌入相加,从而改变token嵌入所携带的实际信息的幅度。
为克服这些问题,GPT-2、GPT-3等模型开始采用“学习型参数”方法。这种方法不再依赖单一固定公式,而是让神经网络通过反向传播自主学习位置信息。虽然这一方向是正确的,但仍存在一些不足:会增加模型的参数负担(参数规模为上下文长度×维度),且“直接与token嵌入相加”的核心问题依然存在。
RoPE(旋转位置嵌入)的出现解决了这些问题[4]。它克服了另外两种方法的大部分缺陷,如今大多数现代LLM默认都采用RoPE,这是有充分理由的。与学习型或正弦型方法不同,RoPE通过根据token的位置和频率旋转查询(Query)和键(Key)矩阵来编码位置信息,完全不改变token嵌入本身。因此,它通过单一操作实现了两个目标:不对模型增加任何参数负担,且不直接相加,确保token嵌入携带的实际信息不受影响。
我已通过可视化和优缺点拆解,深入分析了这三种位置嵌入方法:详见完整文章。
3. 权重共享(Weight Tying)
权重共享是指在token嵌入层和输出投影头之间共享权重。历史上,GPT、GPT-2和BERT都采用了这种方法。在一个1.24亿参数的模型中,权重共享可节省3800万参数,约占模型总参数的30%,效果十分显著。从直觉上看,这种设计也合理——嵌入层将token映射为向量,而输出头将向量映射回token,两者本质上是彼此的转置。
但随着模型规模扩大到数十亿参数,这3800万的参数节省量占总参数的比例不足0.5%,实际意义不大。因此,大多数现代LLM(如LLaMA、Mistral和Falcon)都将两者的权重分开设置——分开的权重能让输出头获得独立的专业化空间,更好地完成特定任务。
总结:如果你从零构建小型模型,权重共享值得尝试;如果你微调的是数十亿参数的大型模型,就无需费心寻找权重共享的相关设置了——它很可能已经被移除。
4. 预层归一化(Pre-LayerNorm)与后层归一化(Post-LayerNorm)
Pre-LN和Post-LN处于“稳定性与性能”权衡的两个极端。《Attention Is All You Need》原文采用的是Post-LN(归一化操作在残差相加之后执行)。虽然Post-LN能带来更好的最终性能,但训练难度极大——在深度网络中,它容易导致梯度爆炸或梯度消失。
从GPT-2开始,行业开始转向Pre-LN(归一化操作在残差块内部执行)。这种选择优先保证训练稳定性,尽管通常会以牺牲模型最终的表示能力为微小代价。此后,研究人员一直试图打破这种权衡关系,由此诞生了DeepNorm、RMSNorm、Double Norm等现代变体。
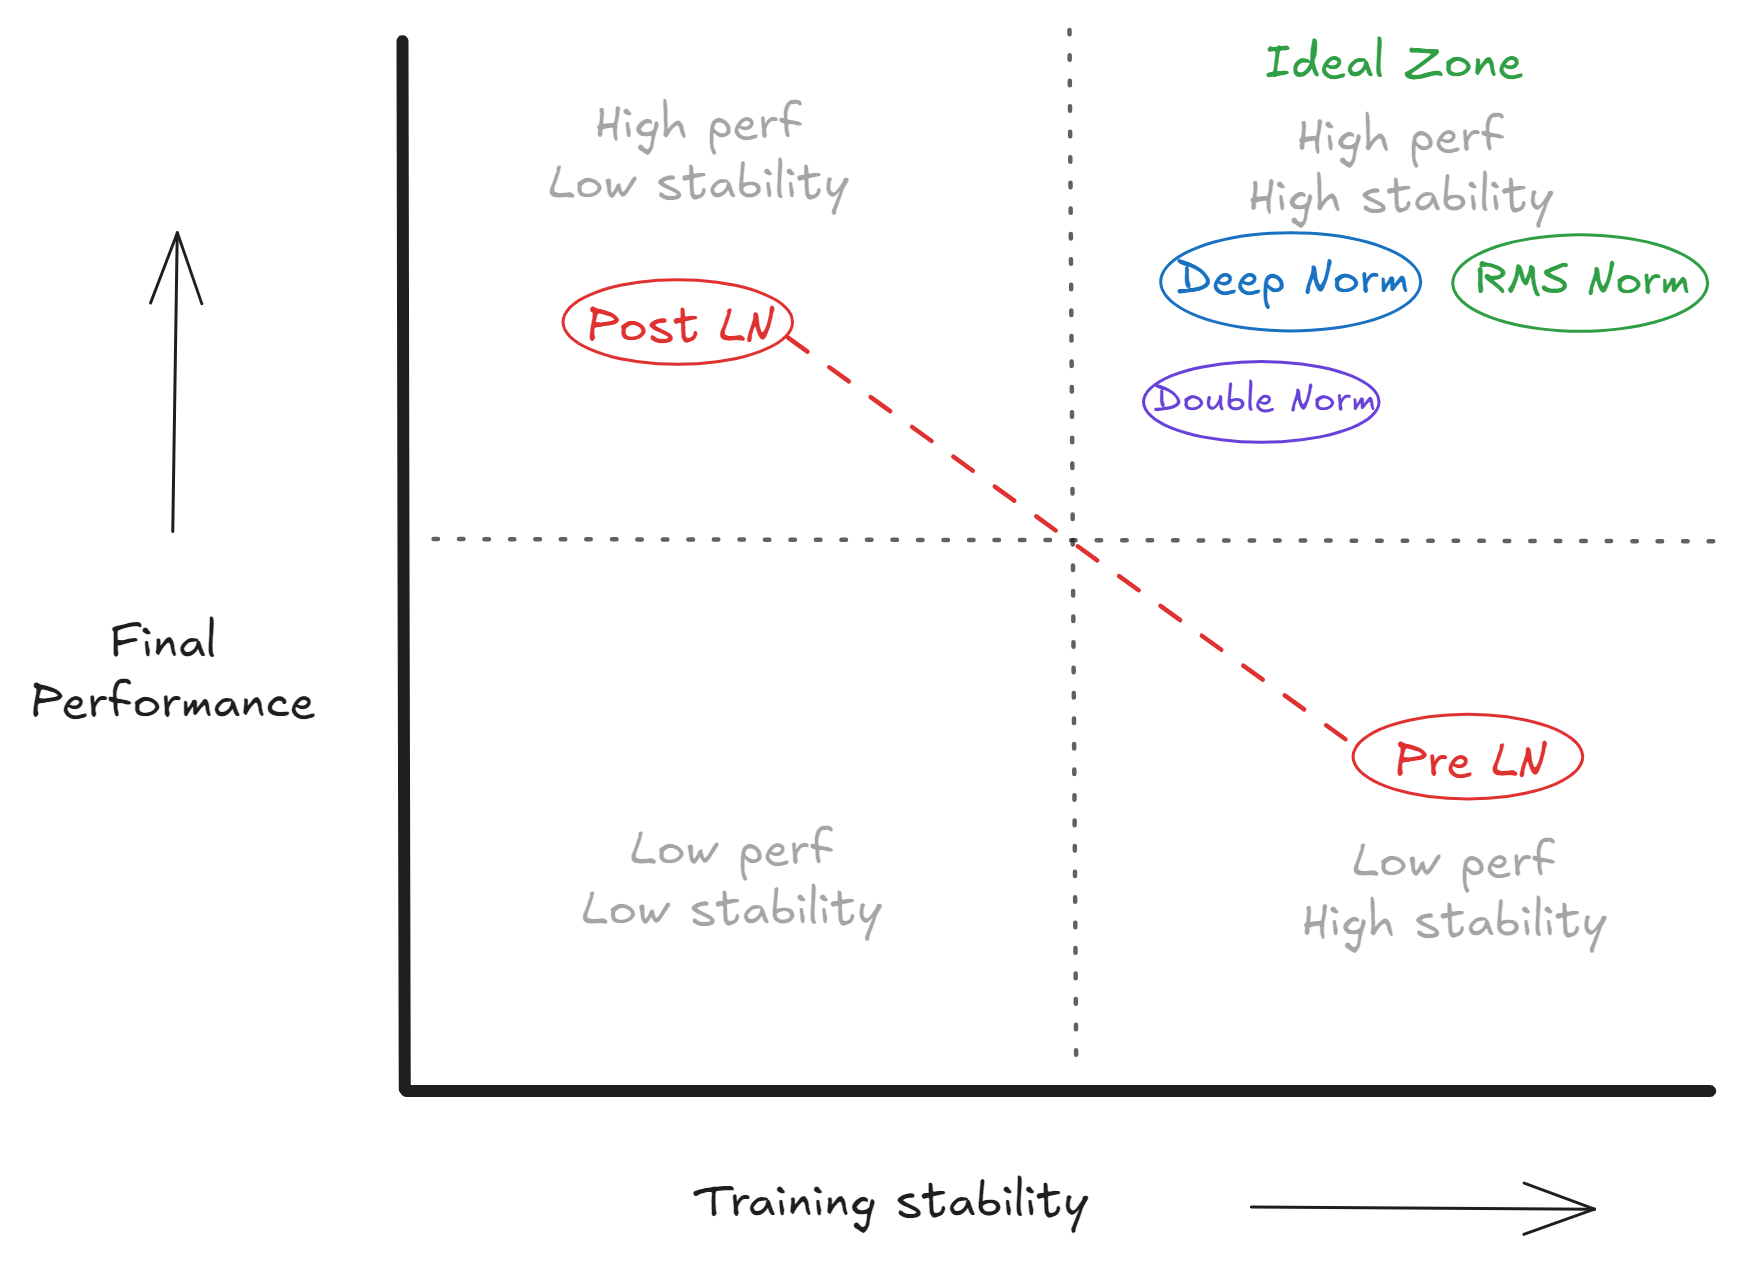
后层归一化(Post-LN)与预层归一化(Pre-LN)的稳定性-性能权衡。图片由作者提供:原文发表于《Pre-LN vs Post-LN:每个LLM工程师都应了解的架构拉锯战》。
5. KV缓存(KV-Cache)
注意力机制是Transformer模型的核心引擎,它让模型能够动态加权序列中不同token的重要性。作为现代AI中最关键的创新,注意力机制使模型能够维持长距离上下文,并“聚焦”于相关信息。
注意力机制包含三个核心组件:
查询(Query, Q):代表模型当前关注的token
键(Key, K):与查询配合使用,用于发现当前token与其他token的关联
值(Value, V):token被选中时所共享的实际内容
在推理过程中,token是通过自回归方式逐一生成的。每个新token都需要关注所有之前的token,这意味着每次都要从零重新计算所有已出现token的K和V矩阵——这是一种极大的浪费。
解决方案很简单:边生成边缓存K和V矩阵。每个新token只需计算自身的K和V,其余的都从缓存中读取。对于长度为T的序列,这将时间复杂度从O(T²)降至O(T)。
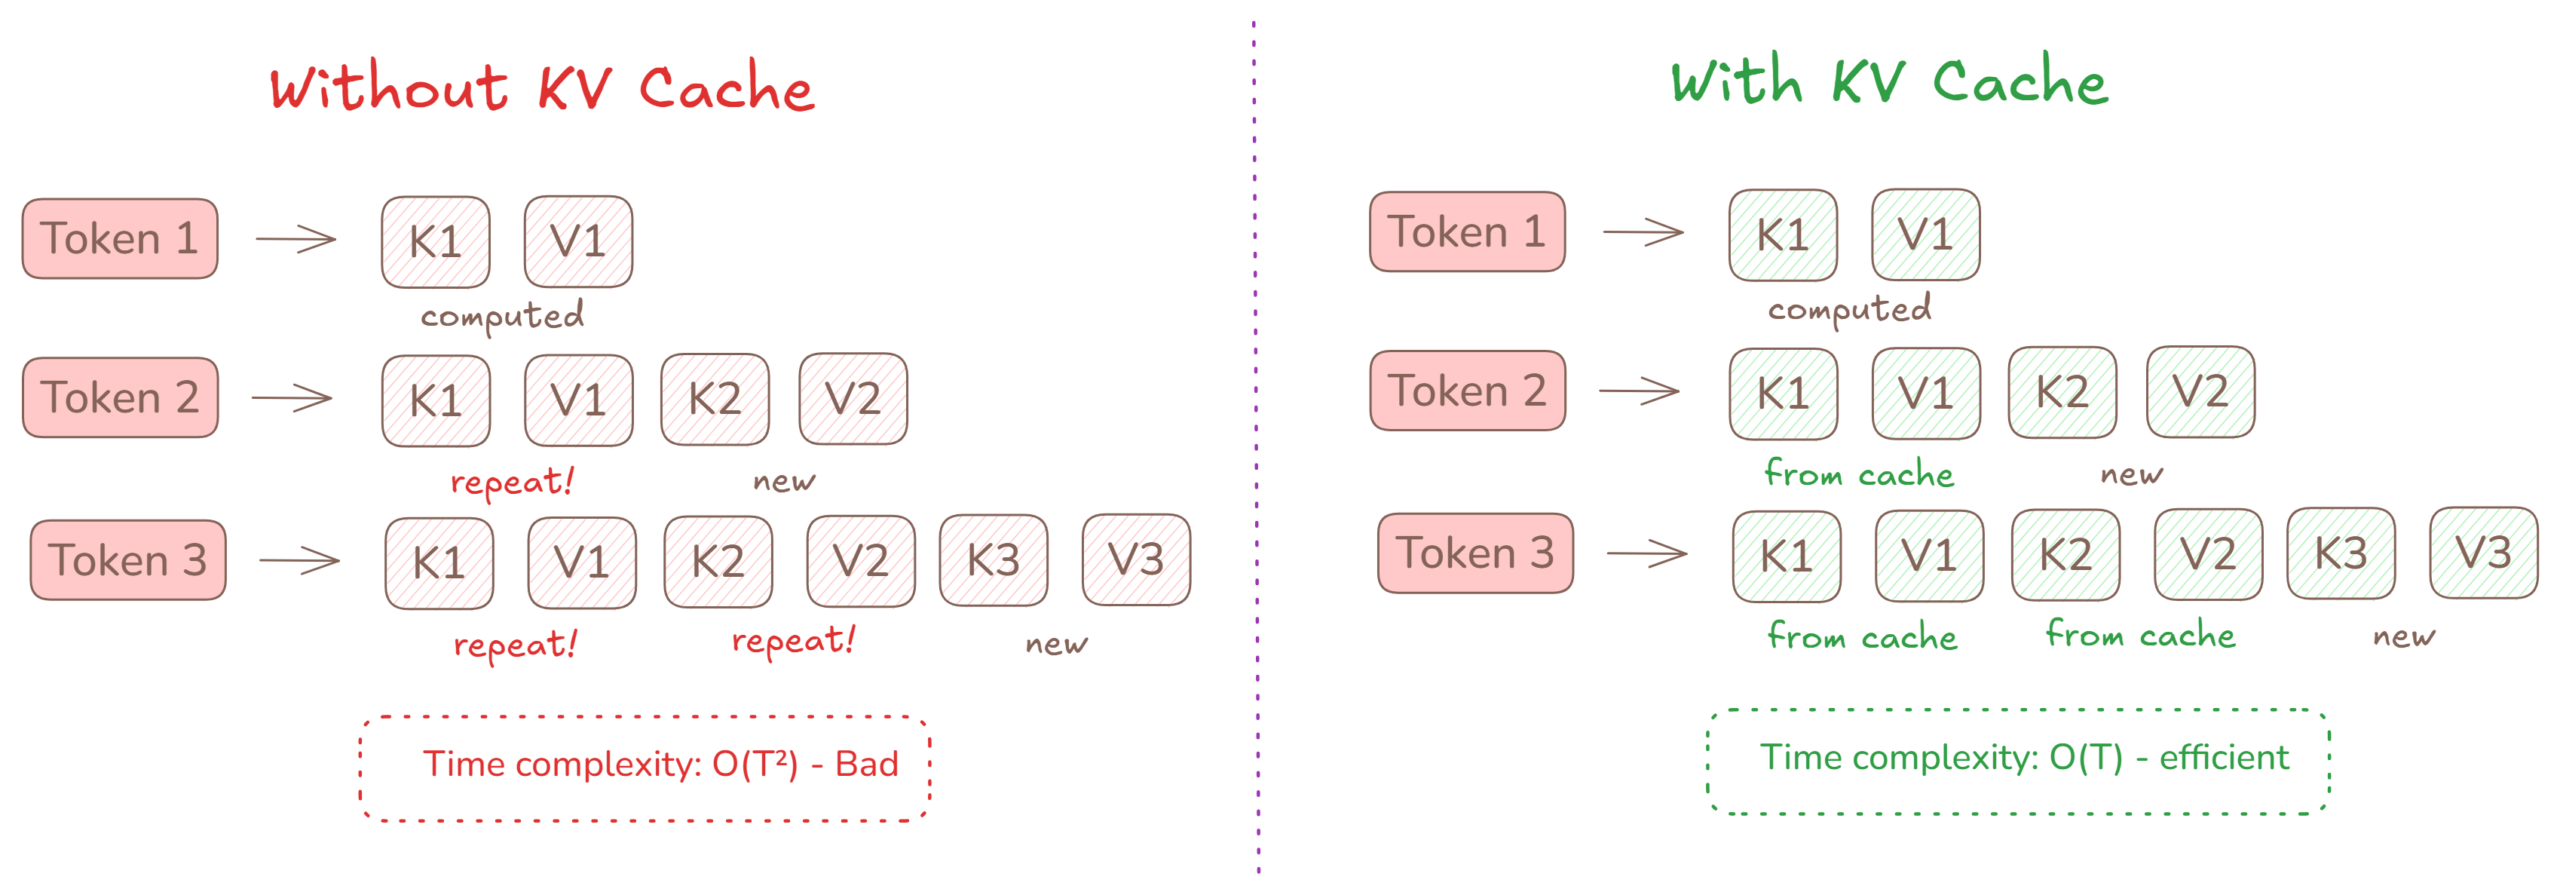
实际提速效果:对于长度为15的序列,无KV缓存时,每一步都要完整计算15次K和V;有KV缓存时,每一步仅需计算1次。这意味着注意力计算量减少了约15倍。综合其他操作,实际整体速度可提升约2倍。
但有一个教程从未提及的权衡点:KV缓存并非免费。它消耗的内存与“层数×序列长度×维度”成正比。在长上下文场景下,这种内存开销会变得非常显著——这也是LLM部署中,内存成为瓶颈而非计算能力的核心原因。
这种内存开销一直是研究领域的重大挑战,而最近谷歌研究院推出了一项突破性技术来解决这个问题。在2026年的论文《TurboQuant: Online Vector Quantization with Near-Optimal Distortion Rate》[5]中,研究人员展示了一种将KV缓存压缩至每个值仅3位的方法。
该技术实现了5-6倍的内存消耗 reduction,且无任何准确率损失。其原理是:先旋转维度坐标,使其遵循Beta分布,再应用劳埃德-马克斯量化(Lloyd-Max Quantization),结合1位量化约翰逊-林登施特劳斯(QJL)变换来校正残差误差。这种方法打破了内存壁垒,使模型能够在单芯片上处理原本需要多块GPU才能承载的大规模上下文。
如需了解TurboQuant如何克服传统方法的所有局限性,可查看此处的深度解析,其中我已直观地拆解了TurboQuant的完整流程。
6. 量化权衡:为何INT8量化时会跳过LayerNorm层
现代LLM体积庞大,以全32位或16位浮点精度存储和运行模型的成本极高(无论是内存还是计算方面)。量化是降低模型权重数值精度的过程,通常从32位浮点降至8位整数(INT8),甚至4位。这使得模型的存储成本大幅降低、运行速度显著提升,因此几乎所有生产环境中的LLM部署都会采用某种形式的量化[6]。
但量化并非盲目应用于所有层,这正是其有趣之处——LayerNorm层几乎总会在INT8量化时被跳过。原因在于一个大多数文章都不会解释的成本-收益计算:
收益微乎其微:LayerNorm几乎没有可量化的参数,仅有γ和β两个参数,与单个线性层中数百万的参数相比,数量微不足道。在1.24亿参数的模型中,这部分参数占总内存的比例可以忽略不计,量化它们带来的内存节省几乎为零。
成本极高:LayerNorm在数学上具有敏感性。它先计算每个token嵌入的均值和方差,再通过γ和β进行缩放。INT8量化会引入微小的精度误差,这些误差会直接扭曲归一化输出,并传导至后续所有层。
权衡结果很明确:量化LayerNorm层几乎没有收益,却会导致模型质量明显下降。因此,LayerNorm层始终保持全精度。
这是量化领域的一个普遍经验:并非所有参数都是平等的。量化时需要思考的问题从来不是“这能节省多少字节?”,而是“相对于节省的成本,该层对精度损失的敏感度如何?”。
结论
这6个感悟并非什么秘密,它们就隐藏在每一个主流LLM的底层架构中。但教程很少会停下来解释这些选择背后的原因:为什么RsLoRA能解决大多数人从未注意到的方差问题?为什么RoPE不会改变token嵌入?为什么权重共享会随着模型规模扩大而逐渐消失?为什么Pre-LN会以性能为代价换取稳定性?为什么KV缓存能将时间复杂度从O(T²)降至O(T)?为什么LayerNorm层能在量化中保持全精度?
从零构建模型,会迫使你直面每一个设计决策——你无法将它们抽象化、回避掉。这也是我建议所有希望真正理解LLM工作原理(而非仅会使用)的人,都尝试从零构建模型的原因。
这6个感悟只是我在构建模型过程中遇到的冰山一角。在接下来的文章中,我将深入解析量化误差的具体数学原理,以及大规模部署LLM的实际挑战。如果你对统计理论与机器学习工程的交叉领域感兴趣,欢迎关注我的下一篇内容。
参考文献
[1] E. Hu, Y. Shen, P. Wallis et al., LoRA: Low-Rank Adaptation of Large Language Models (2021), arXiv:2106.09685(《LoRA:大型语言模型的低秩适配》,2021年)
[2] D. Kalajdzievski, A Rank Stabilization Scaling Factor for Fine-Tuning with LoRA (2023), arXiv:2312.03732(《用于LoRA微调的秩稳定缩放因子》,2023年)
[3] A. Vaswani, N. Shazeer, N. Parmar et al., Attention Is All You Need (2017), arXiv:1706.03762(《注意力就是一切》,2017年)
[4] J. Su, Y. Lu, S. Pan et al., RoFormer: Enhanced Transformer with Rotary Position Embedding (2021), arXiv:2104.09864(《RoFormer:基于旋转位置嵌入的增强型Transformer》,2021年)
[5] Zandieh et al., TurboQuant: Online Vector Quantization with Near-Optimal Distortion Rate (2025), arXiv:2504.19874.(《TurboQuant:近最优失真率的在线向量量化》,2025年)
[6] T. Dettmers, M. Lewis, Y. Belkada, L. Zettlemoyer, LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale (2022), arXiv:2208.07339(《LLM.int8():面向大规模Transformer的8位矩阵乘法》,2022年)
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802022788号






