


 发帖

 雷达卡



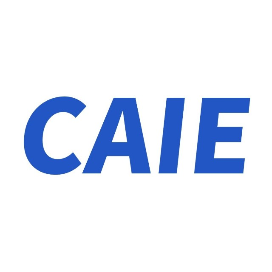
今天凌晨1点,谷歌DeepMind宣布开源基于Gemma3的最新翻译大模型TranslateGemma。
它支持全球55种主流语言,并且有40亿、120亿和270亿三种参数,轻松部署在手机、平板等任何设备上。
这几年大模型发展的飞快,机器翻译水平也跟着涨,但一直有个头疼的问题,厉害的翻译模型要么闭源,要么需要超大算力,普通开发者和小团队根本用不起。
而开源模型又大多不给力,要么翻译不准,要么支持的语言少,效率还低。
谷歌就是瞄准了这个痛点,Gemma3本身已经有不错的多语言能力了,但专门做翻译还差点意思。
所以团队就想,能不能在开源的基础上,把翻译质量提上去,还不用靠堆参数规模,同时多支持点小众语言,让更多人能用得上好的翻译技术,TranslateGemma就应运而生啦。
TranslateGemma能这么能打,核心就是一套精心设计的训练体系,再加上高质量的训练数据。
首先是合成平行数据,这是解决低资源语言数据少的关键。团队用MADLAD-400语料库当基础,给每个语言对最多生成1万个合成样本。生成过程挺有意思,先按文本长度分桶,每个语言对挑100万个源文本片段,保证长短都有。
然后用Gemini2.5Flash模型给每个片段生成两个版本,一个是贪心解码的,一个是温度1.0随机采样的,再用MetricX24-QE指标挑出那些随机采样比贪心解码好很多的文本,这些文本被认为更有训练价值。
最后给这些筛选后的文本生成128个翻译样本,再挑最好的,还会做格式校验,避免出错。
而且这些合成数据分两种长度,短到单句,长到512个token的文本块,不管是日常聊天还是看长文档都能覆盖到,还额外加了30种语言对,比WMT24++基准覆盖的还全。
然后是人工生成的平行数据,有些低资源语言,合成数据还是不如人工翻译准。所以团队引入了SMOL和GATITOS两个数据集,一个覆盖123种语言。
一个覆盖170种语言,大大丰富了小众语言的训练数据,不过这部分数据只在第一阶段训练用,没参与后续的强化学习。
还有30%的通用指令遵循数据,这是从Gemma3原来的训练集里拿的。为啥要加这个?就是怕模型学太专,只懂翻译,其他指令都不会响应了,加了这个能保持模型的通用性,不至于变成只会翻译的“偏科生”。
为了让TranslateGemma获得更强性能,谷歌还加入了强化学习。在第一阶段训练好的模型基础上,用了一套多指标的奖励模型,引导模型生成更符合人类预期的翻译结果。
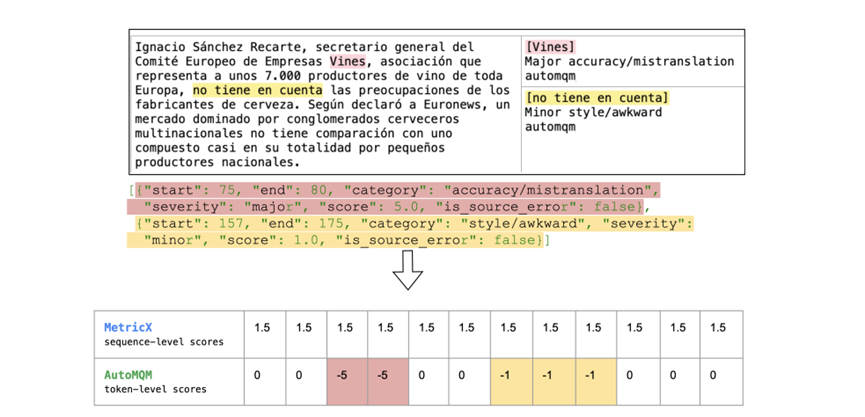
这套奖励模型有五个核心部分,各管一摊。MetricX-24-XXL-QE负责整体质量打分,得分越低越好,范围0到25,为了适配奖励机制,团队把它改成了5.0减原始得分,这样分越高说明翻译越好,而且不用参考译文,直接看源文本和候选译文就行。
Gemma-AutoMQM-QE更细致,能逐词标注错误,比如哪里误译了、哪里漏译了,同样不用参考译文。ChrF是看词汇重叠度的,需要参考译文,为了和其他指标尺度统一,得分翻倍处理。
还有个自然度自动评估器,专门挑那些读起来不自然、不像母语者说的话的片段,进行惩罚,还会排除因为源文本本身不自然导致的问题。
最后还有个通用奖励模型,保证翻译结果不仅准确自然,还符合基本的语言逻辑和指令要求。
算法上也有巧思,团队把序列级奖励和token级奖励结合起来计算优势,再做批次归一化。
简单来说,就是不仅看整个译文的质量,还关注每个词的表现,这样能更精准地引导模型优化,训练效率也更高。
为了测试TranslateGemma性能,谷歌在文本翻译自动评估、人工评估、图像翻译评估三个领域进行了深度评测,结果都非常好。
自动评估用了WMT24++基准数据集,靠MetricX和Comet22两个指标打分。MetricX得分越低错误越少,Comet22得分越高质量越好。
三个参数版本的TranslateGemma都有明显提升:27B版本MetricX从4.04降到3.09,降幅23.5%,Comet22从83.1升到84.4;
12B版本MetricX从4.86降到3.60,降幅25.9%,Comet22从81.6升到83.5;4B版本MetricX从6.97降到5.32,降幅23.6%,Comet22从77.2升到80.1。
用Vistra基准数据集测试,挑了264张只有单一文本的图片,让模型直接翻译图片里的文字,不提供任何额外信息,比如文字位置、OCR结果这些。测试覆盖英语到德语、西班牙语、俄语、中文四种方向。
结果很亮眼,27B版本MetricX从2.03降到1.58,Comet22从76.1升到77.7;12B版本MetricX从2.33降到2.08,虽然Comet22稍微降了点,但整体还是有竞争力;4B版本参数有限,提升不大,但也有小幅进步。
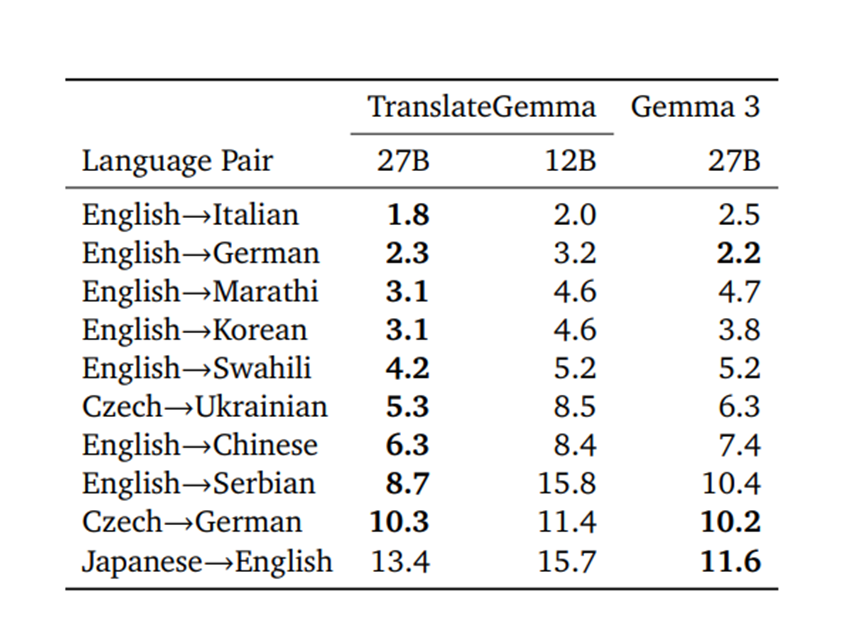
自动评估再好,也得经过人类检验。团队用MQM多维度质量评估框架,请专业翻译人员来打分,标注翻译里的错误,比如误译、语法错误、表达不自然这些,还会给错误分严重程度,最后加权算出综合得分,得分越低越好。
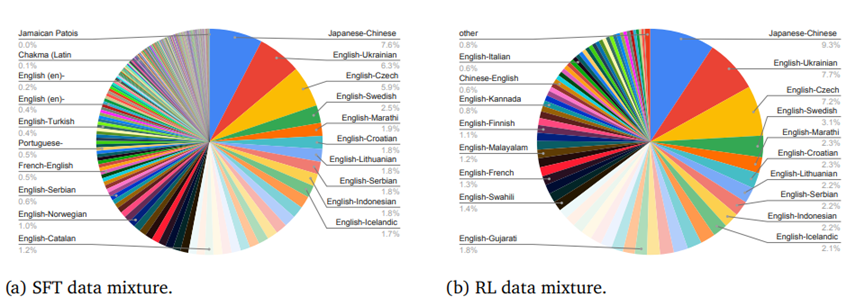
结果和自动评估差不多,大部分语言对里,TranslateGemma都比基准模型表现好。
低资源语言对提升最明显,英语到马拉地语得分从4.7降到3.1,英语到斯瓦希里语和基准模型持平,但TranslateGemma12B参数更小,已经非常不错了。
开源地址:https://huggingface.co/collections/google/translategemma
想转型AI,不被时代淘汰
CAIE注册人工智能工程师认证
岗位能力 × AI工具 ×转型方向 × 场景落地 = 新AI职业价值
扫码免费领取《AI工程师入门学习指南》

 京公网安备 11010802022788号






