


 发帖

 雷达卡



现在的大模型卷参数已经卷到千亿甚至万亿级别,但总感觉有点用力过猛。比如让超级计算机去查字典,明明一眼能找到的答案,非要绕着圈子计算半天。
而今天凌晨,DeepSeek、北大的研究团队直接搞出了Engram架构,算力需求大降,把大模型的稀疏性玩出了新花样。
咱们先说说以前的大模型为啥效率低。语言这东西本来就分两种活,一种是需要动脑子的推理,比如解数学题、分析文章逻辑;
另一种就是简单的知识回忆,比如知道“四大发明”是啥、“戴安娜王妃”是谁。
但传统Transformer架构不管这些,全靠计算搞定。就拿识别“戴安娜王妃”来说,模型得用6层网络一步步拼凑,前3层只知道“威尔士”是个地方,到第6层才认出完整实体。
这就像让你做数学题时,先花半小时默写乘法口诀,纯粹浪费时间。宝贵的网络层被用来干“查字典”的活儿,真正该用在推理上的资源就少了,难怪很多大模型知识问答还行,复杂推理就拉胯。
而Engram的核心思路就是要把计算和记忆给彻底分开。简单来说,就是给大模型外挂了一个超级百科全书,专门用来存那些固定的知识,像是什么历史年份、名人名字、代码里的固定语法这些。
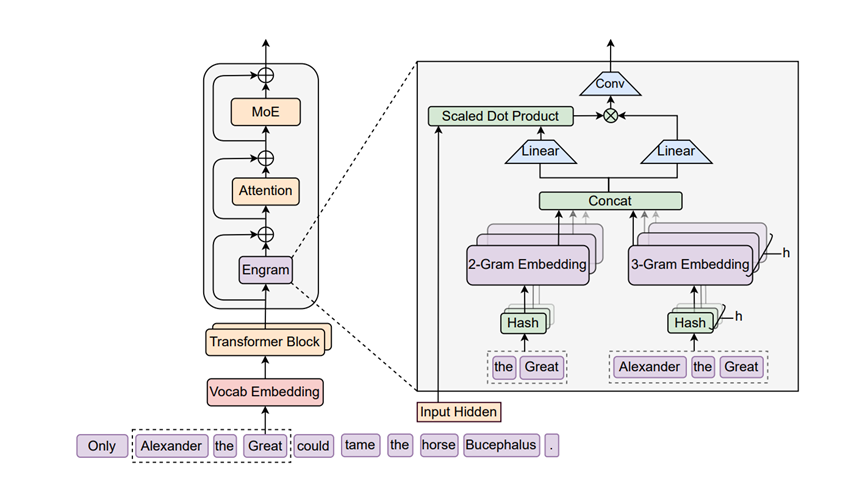
Engram就像是给大脑配了个直接索引,想查什么直接伸手去拿,完全不耽误脑子去干更复杂的逻辑推理活。
咱们深入一点看Engram的核心技术,它到底是怎么做到的。首先啊,这玩意得解决一个特别现实的问题,就是咱们平时说话用的词儿太碎了。
比如Apple和apple,意思其实差不多,但计算机非得把它当成两个完全不同的东西来存。
Engram就很聪明地做了一步压缩,把大小写、格式不一样但其实是一个意思的词全都归为一类,这么一整理,词汇表一下子就精简了不少,存起来自然就快多了。
紧接着又来了个挺有意思的操作,叫多头哈希。大家可能觉得存N-gram这种连续的词组,比如Artificialintelligence,组合起来是个天文数字,根本存不下对吧。
这帮人想了个招,用类似抽奖摇号的方式,通过一个算法把长长的词组映射到一个固定的格子里去,哪怕偶尔几个不同的词撞车了也没事,后面还有办法修补。
这样就能在有限的空间里塞进海量的词组模式,而且查找速度特别快,哪怕你有一万个词要查,它也能在一瞬间找到。
光找到还不行,因为这毕竟是死记硬背的东西,万一跟上下文冲突了怎么办。比如我刚才说Java,你不知道我说的是咖啡还是编程语言。
Engram这里设计了个特别灵巧的门控机制,它就像个特别懂眼的管家,先看看现在的语境,如果发现从记忆里拿出来的东西跟现在聊的天不搭界,它就自动把音量关小,甚至直接忽略。
如果发现特别对口,它就把这个记忆大声告诉模型。这种动静自如的感觉,真的是把大模型调教得像个活人一样。
而且为了不让这个外挂记忆显得太呆板,他们还加了一点深度卷积在里面。这就好比给那些死板的记忆加了一层滤镜,让它们能更好地融入到当前的句子里去,不至于显得格格不入。通过这一套组合拳下来,Engram不仅记得多,还记得灵活。
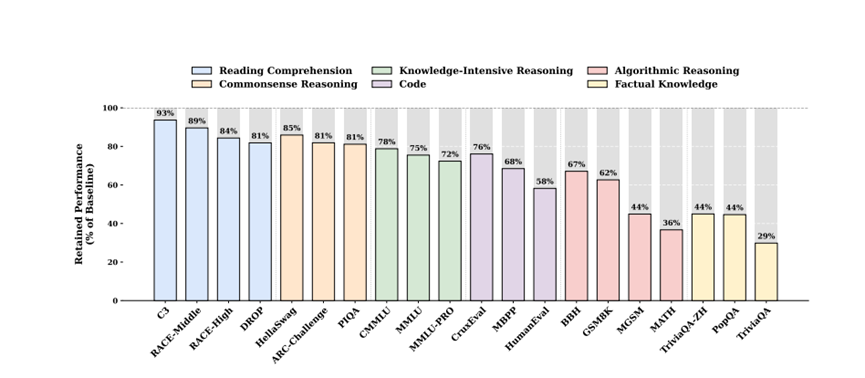
为了评估Engram的性能,研究团队训练了四个模型对比,41亿参数的稠密模型、267亿参数的MoE模型、267亿参数的Engram模型,还有395亿参数的超大Engram模型。
测试结果显示,Engram架构模型直接断层领先。
知识类任务不用多说,MMLU准确率比MoE高3%,中文的CMMLU高4%,零样本的AGIEval更是领先3.2%,相当于知识点记得更牢更准。
让人意外的是推理类任务,提升更明显。BBH逻辑推理高5%,ARC-Challenge高3.7%,阅读理解DROP高3.3%。原来把“查字典”的时间省下来,模型真的能更专注于推理,就像学生不用死记硬背公式,能把更多精力放在解题思路上。
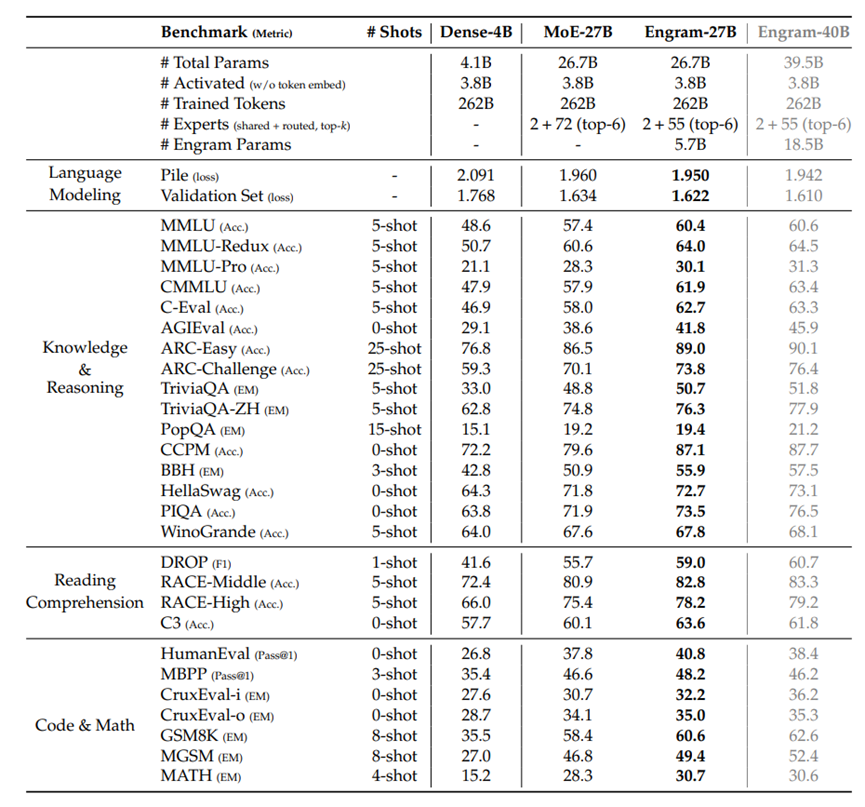
代码和数学任务也不示弱,HumanEval代码生成通过率高3%,GSM8K数学题高2.2%,连难度超高的MATH数据集都高了2.4%。这说明静态记忆里的代码语法、数学公式,真的能帮模型更好地完成结构化任务。
长文本一直是大模型的软肋,以前处理32ktoken的长文档,要么困惑度高,要么关键信息找不到。Engram一出,这个问题直接被解决。
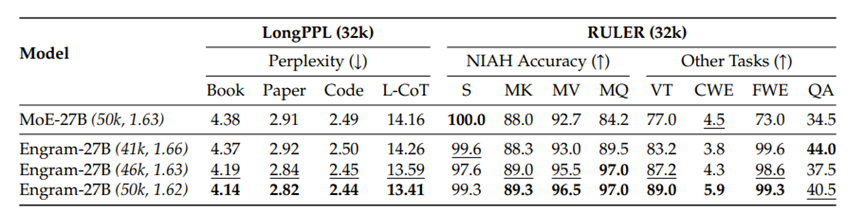
因为它把局部的依赖关系都交给记忆库处理,注意力机制不用再纠结“这个词和前面哪个词相关”,能专心捕捉全局逻辑。
测试显示,同样处理32k长文本,Engram的困惑度比MoE低不少,多查询针寻任务准确率从84.2%冲到97%,变量追踪从77%升到89%,就连高频词提取准确率都快到100%了。
更厉害的是,就算Engram只用82%的预训练计算量,长文本处理性能也能和满算力的MoE打平,要是算力相同,优势还能再扩大。以后不管是读长篇论文、分析海量代码,还是处理超长对话,大模型都能游刃有余。
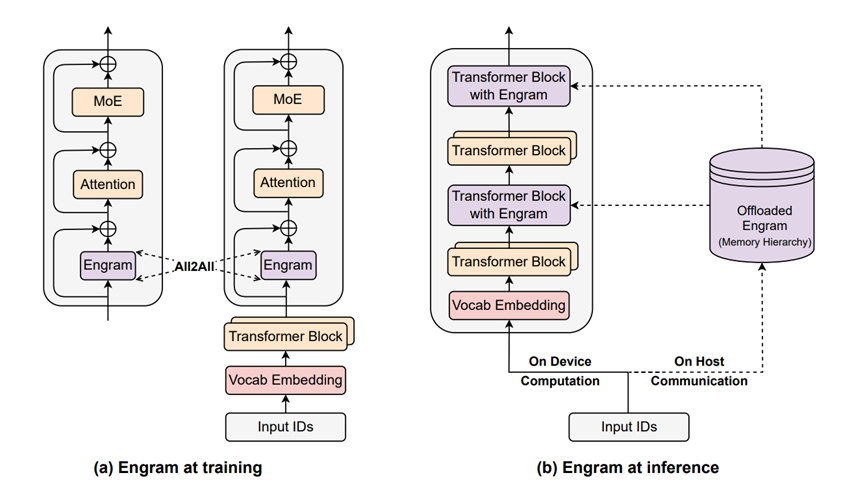
很多人担心,这么大的记忆库,部署起来会不会很麻烦?其实完全不用怕,Engram在部署上做了很多优化。
研究团队测试过,给40亿参数的模型加1000亿参数的Engram记忆库,推理吞吐量只下降了不到2%;
80亿参数的模型加1000亿参数的记忆库,吞吐量也只降了2.78%。这意味着,几乎可以忽略不计的性能损耗,就能给模型增加海量知识,性价比超高。
而且它利用缓存机制,常用知识放GPU高速内存,冷门知识存主机硬盘,命中率能达到99.2%,几乎不影响推理速度。以后部署大模型,不用再为GPU内存不够发愁,千亿参数的记忆库也能轻松扛住。
想转型AI,不被时代淘汰
CAIE注册人工智能工程师认证
岗位能力 × AI工具 ×转型方向 × 场景落地 = 新AI职业价值
扫码免费领取《AI工程师入门学习指南》

 京公网安备 11010802022788号






