


 发帖

 雷达卡



“公司有很多CPU服务器,为什么训练模型还要买昂贵的GPU?”这是很多非技术管理者第一次接触AI预算时最容易提出的问题。真正的答案不在于哪种芯片“更高级”,而在于模型训练要反复进行海量矩阵和张量运算,计算方式天然更适合大规模并行。
问题到底出在哪
CPU擅长处理复杂控制逻辑、分支判断和串行任务,GPU则拥有大量适合同时执行简单运算的计算核心。深度学习训练需要把成批数据送入模型,进行前向计算、误差反传和参数更新,这些步骤包含大量可以并行处理的乘加运算。因此,GPU的优势主要来自并行吞吐,而不是更高主频,也不是芯片里“预装了深度学习算法”。
从机制上看
算力设备与硬件环境
了解算力设备与硬件环境对 AI 的支撑作用,理解 CPU 与 GPU 在串行/并行计算上的差异及其对模型训练的影响。
核心算法组成与训练方法
了解人工智能核心算法的主要组成模块,了解大模型通过更新参数、从数据中学习的基本训练方法。
用一个场景走一遍
一家工业质检公司计划训练缺陷识别模型。管理层看到机房里还有一批空闲CPU服务器,想把它们拼起来替代GPU集群。算法团队应当把预算讨论转成业务问题:现有CPU方案训练一次需要多久,GPU方案能缩短到多久;更快的训练是否意味着更快迭代、更多实验和更早上线;显存容量能否容纳模型参数与中间激活;数据读取、网络带宽和存储是否会成为新的瓶颈。只有把“芯片价格”放进完整的训练周期和机会成本里,算力采购才不是单纯比硬件单价。
哪些说法看似合理
认为GPU主频一定高于CPU。实际训练瓶颈通常是并行吞吐,不是单核主频。 认为GPU内部预置了AI算法。算法由框架和程序实现,GPU提供的是适合并行计算的硬件能力。 把显存理解成装下全部训练数据的仓库。训练数据通常仍在存储和内存中,显存主要容纳参数、梯度与中间结果。
实际操作怎么做
先明确是训练、微调还是推理,不同阶段对算力的要求不同。 测算单次实验时长、每周实验次数和模型迭代周期。 同时检查显存、带宽、存储和数据管道,不把GPU当成唯一瓶颈。 比较按需云算力、长期租赁和自建集群的总成本。 用业务上线时间和实验效率解释投资回报,而不是只报芯片型号。
留一道题自测
自测题
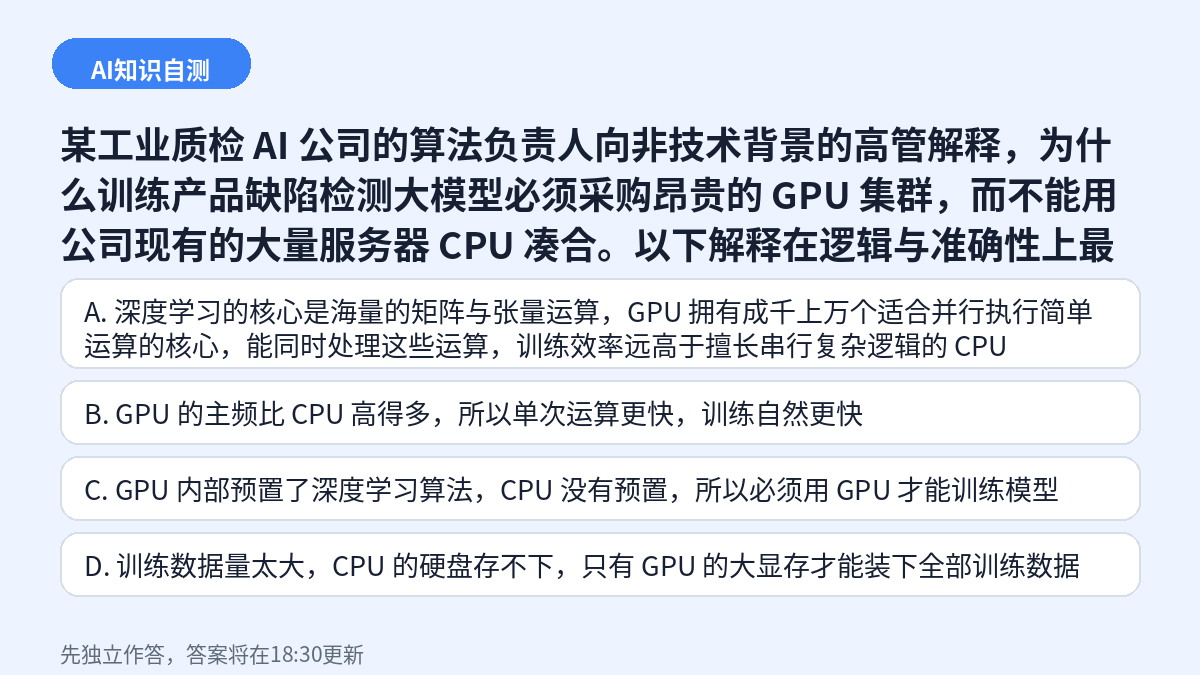
某工业质检 AI 公司的算法负责人向非技术背景的高管解释,为什么训练产品缺陷检测大模型必须采购昂贵的 GPU 集群,而不能用公司现有的大量服务器 CPU 凑合。以下解释在逻辑与准确性上最站得住脚?
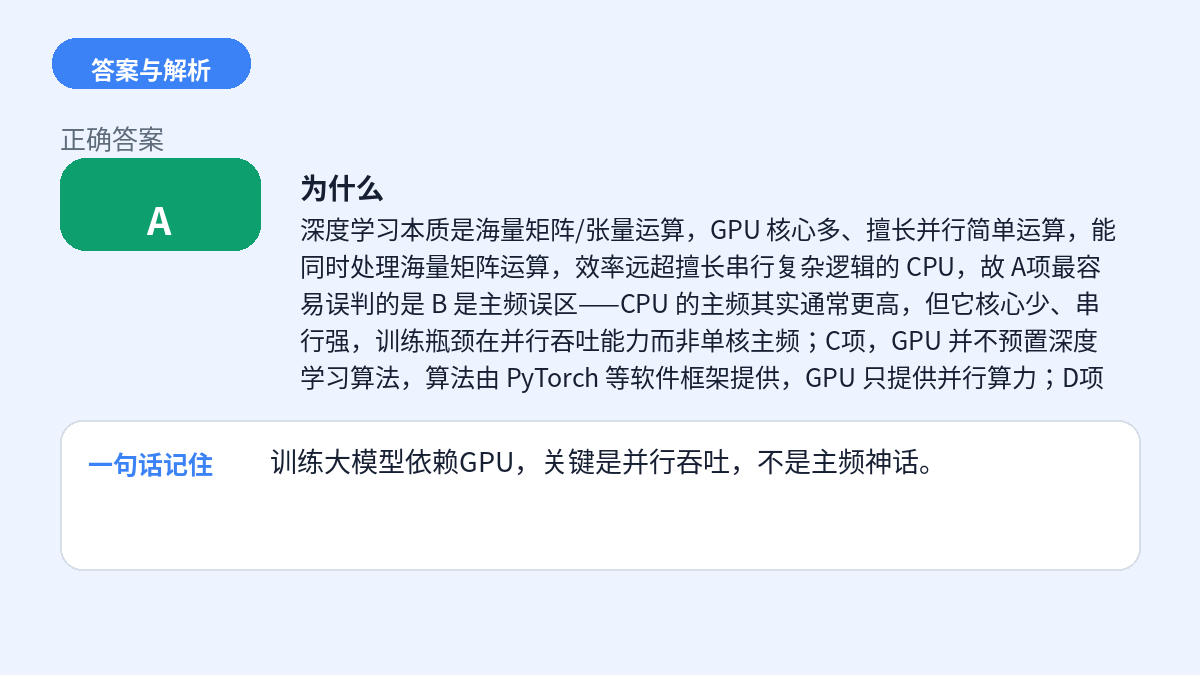
A. 深度学习的核心是海量的矩阵与张量运算,GPU 拥有成千上万个适合并行执行简单运算的核心,能同时处理这些运算,训练效率远高于擅长串行复杂逻辑的 CPU
B. GPU 的主频比 CPU 高得多,所以单次运算更快,训练自然更快
C. GPU 内部预置了深度学习算法,CPU 没有预置,所以必须用 GPU 才能训练模型
D. 训练数据量太大,CPU 的硬盘存不下,只有 GPU 的大显存才能装下全部训练数据
答案将在当天18:30更新到本帖回复区。
用反例检查自己是否真的掌握
理解一个知识点,最好能说出它什么时候不成立。可以把本文场景中的行业、角色或数据条件换掉,再问一次:原来的判断还适用吗?例如把“一家工业质检公司计划训练缺陷识别模型”改成低风险、数据完整且结果可撤销的任务,人工复核强度可能就可以降低。
反过来,如果任务涉及人员、资金、隐私或重大经营后果,就应提高证据、权限和审计要求。能解释条件变化为什么会改变方案,比复述定义更接近真正掌握。
一句话记住:训练大模型依赖GPU,关键是并行吞吐,不是主频神话。
用第二生命 AI 闪卡继续练习
如果你想把本文知识点从“看懂”变成“能回忆、会应用”,可以进入“第二生命”,用 CAIE Level 1 AI 闪卡完成第一组 3 题,并结合解析复盘错因。
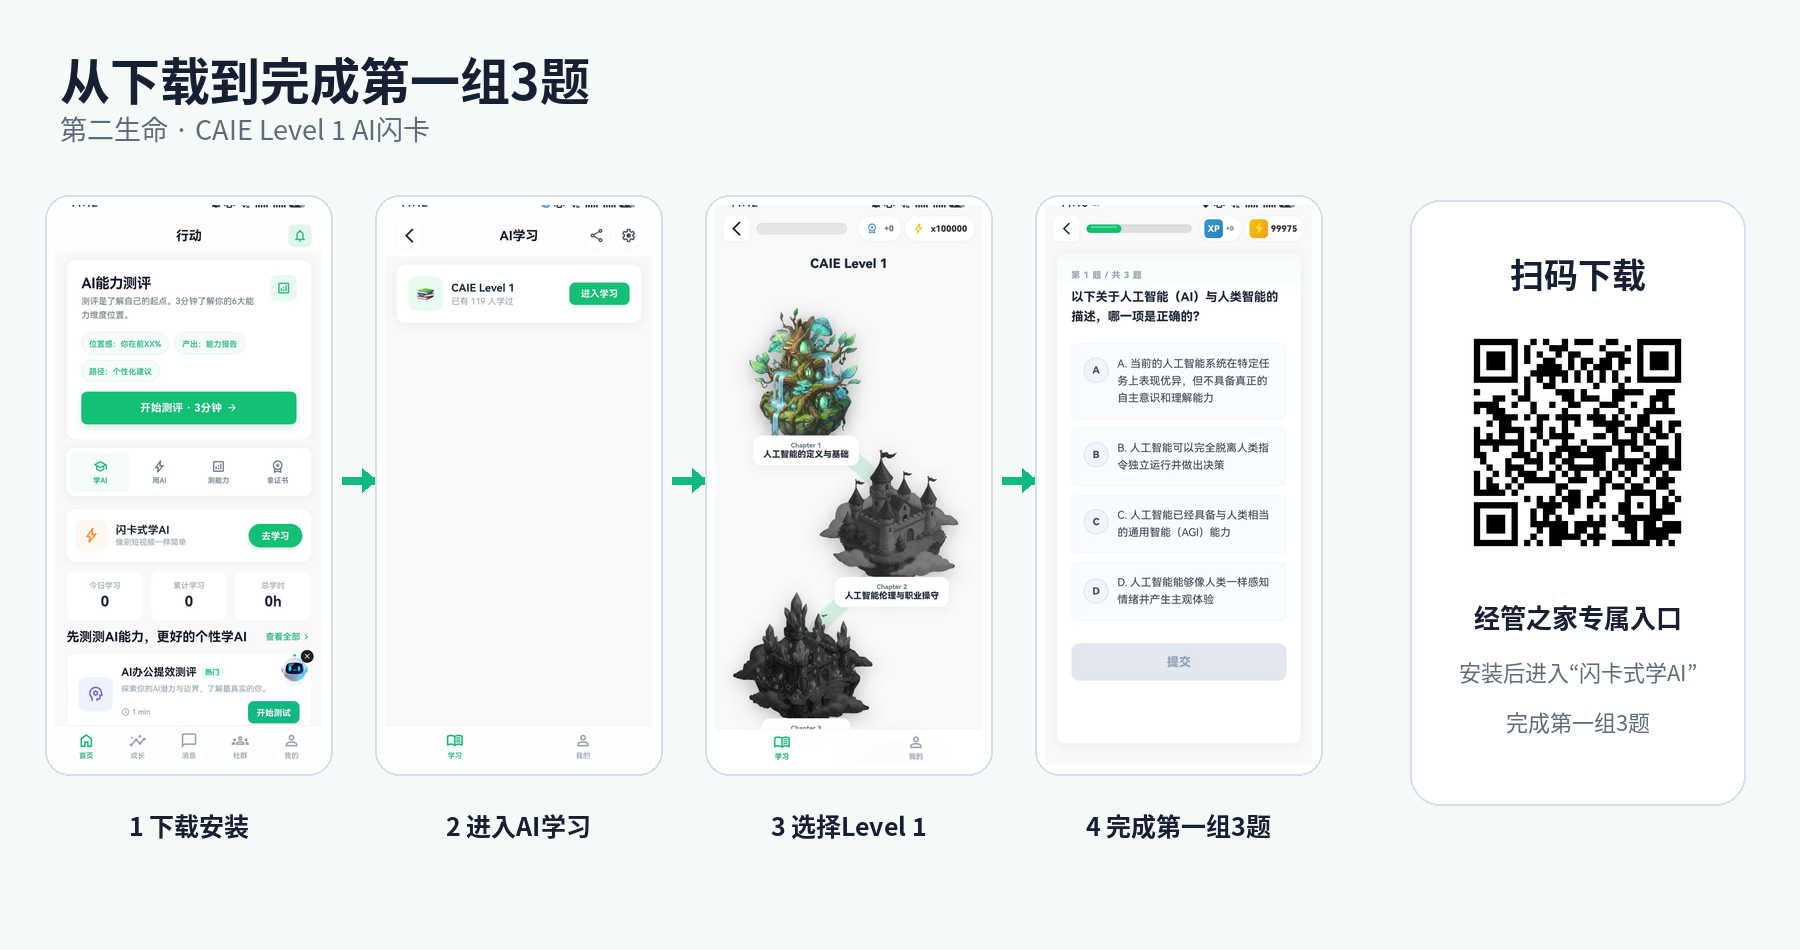
下载入口:立即下载“第二生命”APP
打开路径:第二生命 → 首页“闪卡式学AI” → CAIE Level 1 → 完成第一组 3 题。

 京公网安备 11010802022788号






