


 发帖

 雷达卡



简历筛选模型把“准确率”从78%提高到86%,看起来是一项明确进步。但如果提升来自户籍、性别、年龄等敏感特征,企业可能同时放大了历史招聘偏见。AI伦理最难的地方就在这里:一个指标变好,并不代表系统整体更公平、更合规,也不代表从业者可以把风险留给上线后的用户。
风险不在“能不能做”
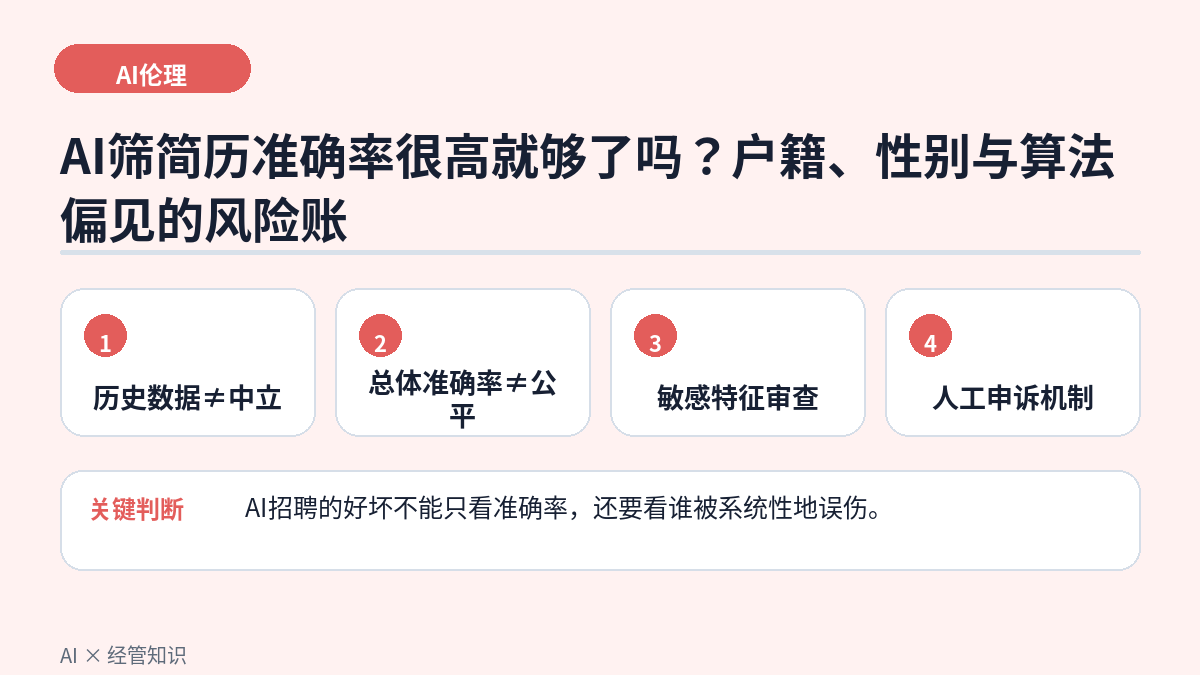
AI招聘工具需要同时检查效果、公平、可解释、最小必要和责任边界。训练数据记录的是过去的决策,而过去的决策可能已经包含结构性偏见。模型若只追求复现历史结果,就可能把偏见包装成“数据规律”。职业操守要求产品、算法、数据和业务负责人主动识别高风险特征,必要时牺牲一部分短期准确率,也要守住不歧视和可问责的底线。
把关键风险拆开
AI伦理问题与治理
了解人工智能领域的重要伦理问题(偏见、公平、隐私、最小必要、算法标签化等)及其治理思路。
AI职业操守
掌握 AI 岗位职业操守的核心准则、实践场景及违规应对措施。
一个真实场景
某公司发现历史上来自某些地区的候选人离职率较高,于是模型把户籍作为筛选特征。这个做法看似基于数据,却可能把地区、教育机会、岗位分配和管理差异混在一起。即便户籍与离职相关,也不能直接证明户籍导致离职。更合理的分析是检查岗位匹配、薪酬、通勤、团队管理和入职支持,并评估模型对不同群体的误拒率。如果敏感特征没有明确、合法且必要的用途,就不应因为“能提高准确率”而保留。
表面合规为什么不够
把历史数据视为中立事实,忽略历史决策本身可能不公平。 只看总体准确率,不比较不同群体的误判率和被拒绝比例。 把风险写进隐私政策就当成完成治理,实际上表面告知不能替代实质公平。
上线前检查表
列出模型使用的全部特征,标记敏感或可能形成代理歧视的变量。 分别评估不同群体的召回率、误拒率和人工复核结果。 对高风险特征做移除、替代或必要性论证。 设置人工申诉和复核渠道,避免模型结果成为不可挑战的结论。 把风险、取舍和审批过程形成书面记录。
文末自测
自测题
某 AI 产品经理为赶在竞品前上线一款简历筛选助手,明知训练数据中混入了应聘者的户籍信息,仍决定保留该特征,理由是它能显著提升模型筛选准确率。从 AI 岗位职业操守的角度,最恰当的做法是?
A. 职业操守要求从业者主动识别并剔除可能带来歧视的敏感特征(如户籍),即使牺牲部分准确率也要守住合规与公平底线,并就风险向上级书面报备
B. 既然能提升准确率且短期内无人发现,可先上线,等问题暴露再处理
C. 只要在隐私政策里写明可能使用户籍信息,就视为已尽到职业操守义务
D. 把责任完全推给数据标注外包团队,由他们承担后续风险
参考答案:A
从业者应以合规、公平、负责为底线,主动识别并规避可能引发歧视的敏感特征,而非为短期指标让步,同时应书面报备风险。A项体现正确导向。最容易误判的是 C 用写进隐私政策这一表面合规动作掩盖实质问题——职业操守要求的是主动消除歧视性特征,而非用一纸声明转移责任,户籍信息用于简历筛选本身即构成歧视风险;B项是侥幸心理;D项把风险转嫁给外包团队,责任主体仍在产品决策方。
用一张检查表做低成本验证
不必立刻改造整条业务流程。先选择一个样本量小、风险可控的任务,记录人工处理结果,再让AI按本文方法完成同一任务。比较速度、错误类型、返工次数和需要人工补充的信息,而不是只比较哪份输出更流畅。
验证时单独检查这项风险:把历史数据视为中立事实,忽略历史决策本身可能不公平。如果模型在这个位置反复出错,就应调整输入、工具或人工节点,而不是继续堆叠提示词。
一句话记住:AI招聘的好坏不能只看准确率,还要看谁被系统性地误伤。
用第二生命 AI 闪卡继续练习
打开“第二生命”后,进入首页“闪卡式学 AI”→ CAIE Level 1。
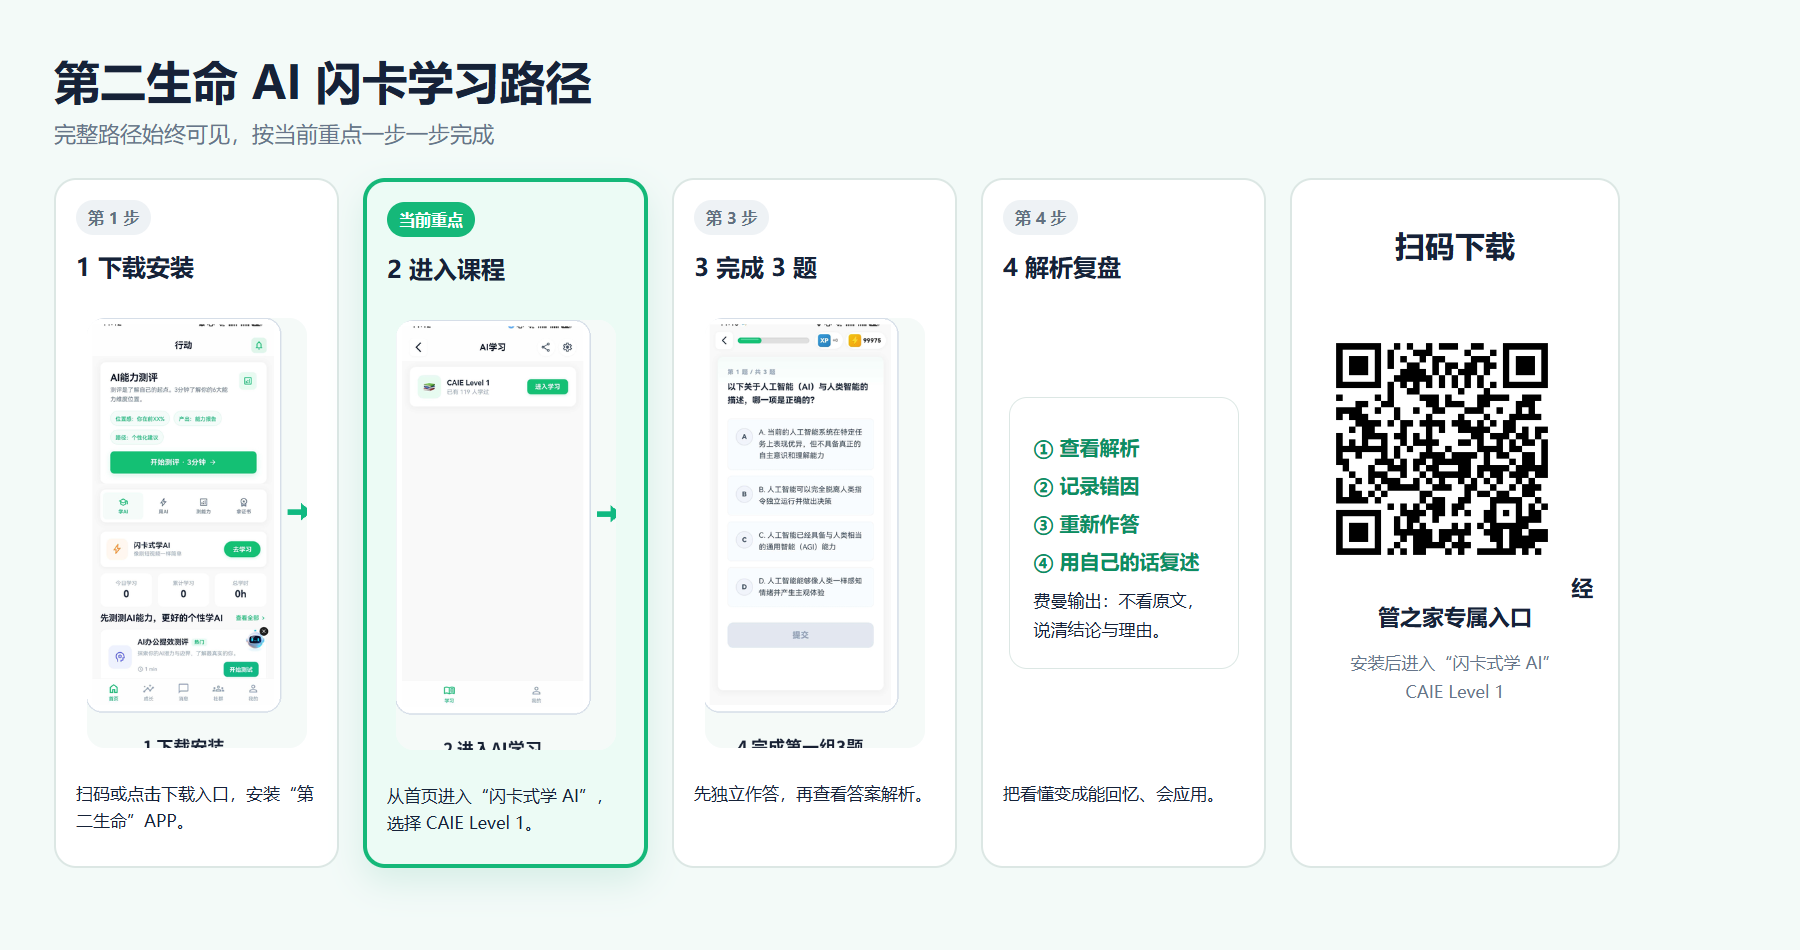
下载入口:立即下载“第二生命”APP
当前步骤:第二生命 → 首页“闪卡式学 AI”→ CAIE Level 1。

 京公网安备 11010802022788号






