


 发帖

 雷达卡



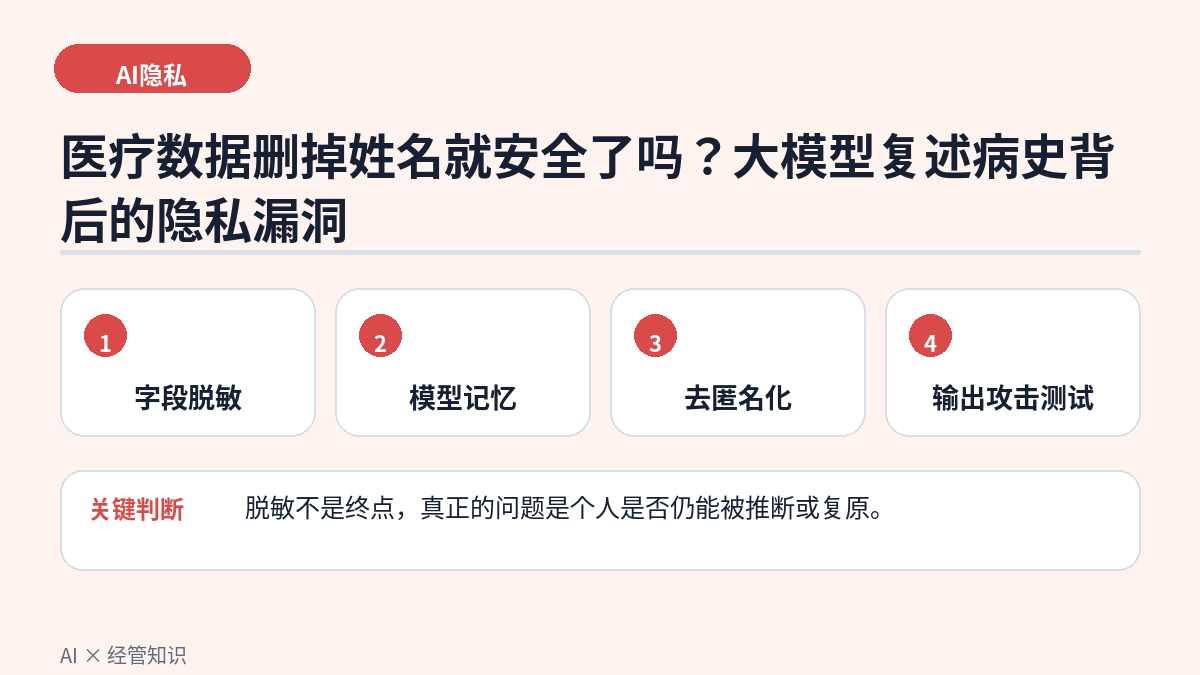
把姓名、身份证号和手机号删掉,通常只是第一步脱敏,不代表数据已经无法关联到个人。大模型可能记住罕见样本、复述训练片段,攻击者也可能结合疾病、地区、职业和时间等背景信息重新识别患者。医疗、金融和人力资源数据尤其需要警惕“看起来匿名,实际上可还原”。
问题到底出在哪
AI隐私风险不仅发生在数据存储阶段,还可能出现在训练、推理和接口使用阶段。常见风险包括训练数据泄露、去匿名化、成员推断和模型逆向。字段脱敏只能移除明显标识,无法自动消除稀有组合、文本记忆和外部信息关联。要判断一份数据能否用于训练,必须从数据可识别性、模型记忆、访问控制和输出测试四个层面同时检查。
从机制上看
AI隐私风险类型
了解 AI 中的隐私风险类型,如数据泄露、去匿名化、模型逆向攻击、成员推断攻击等。
用一个场景走一遍
某医院用脱敏病历训练内部问答模型,演示时模型逐字复述一位罕见病患者的病史。团队可能会说“没有姓名,所以不算泄露”。但如果病史中包含特殊职业、就诊时间和罕见治疗方案,院内人员很容易对应到具体患者。即使没人立即识别,模型能够复述训练样本本身就说明控制失效。此时需要停止相关功能、确认影响范围、调整数据处理和训练方式,并对输出进行系统化攻击测试。
哪些说法看似合理
认为删除直接标识就完成匿名化,忽略准标识符组合。 认为只要接口不公开,内部泄露就不构成风险。 只检查训练数据,不测试模型是否能够被诱导复述或推断成员信息。
实际操作怎么做
识别直接标识、准标识和高敏感文本。 评估单条记录的稀有程度与外部可关联信息。 限制训练样本、访问权限和日志留存。 通过提示攻击、成员推断和复述测试检查模型输出。 建立泄露后的停用、通知、修复和审计流程。
留一道题自测
自测题
某医疗 AI 团队将一批已做字段脱敏(删除姓名、身份证号)的患者病历用于训练问答模型,但在内部演示中,模型竟逐字复述了一位罕见病患者的完整病史片段。团队负责人据此认为数据已脱敏、不存在隐私风险。下列判断最准确的是?
A. 只要删除了姓名等直接标识字段,大模型就绝对不可能还原或泄露任何患者信息
B. 即使做了字段脱敏,大模型仍可能因记忆效应逐字复述训练样本(数据泄露风险),再结合背景信息还可能被去匿名化,脱敏并不等于无隐私风险
C. 隐私风险只发生在模型训练阶段,模型一旦部署上线就彻底安全
D. 只要不对外开放接口,模型内部记住了什么都不会构成隐私问题
参考答案:B
大模型存在记忆效应,可能逐字复述训练数据片段(数据泄露),并可能通过背景信息关联进行去匿名化,因此脱敏并不等同于无风险。B项最容易误判的是 A 用绝对不可能还原的绝对化表述制造虚假安全感,忽视了模型记忆与去匿名化的真实风险;C项把风险限定在训练阶段,否认了部署后通过问答诱导泄露的可能;D项把隐私问题等同于是否开放接口,忽视了即使内部使用、敏感信息被不当复述同样构成隐私事件。
从错误答案倒推业务风险
自测题的价值不只是选出正确项。更值得做的是分析:如果把错误选项当成真实方案,会造成什么成本、合规问题或决策偏差。错误越像常见工作习惯,越应该写进团队检查清单。
本文最需要警惕的是这类做法:认为删除直接标识就完成匿名化,忽略准标识符组合。可以分别写出它的短期便利和长期代价,再判断组织为什么容易选择它。理解诱因,才能设计真正有效的防错机制。
一句话记住:脱敏不是终点,真正的问题是个人是否仍能被推断或复原。
用第二生命 AI 闪卡继续练习
完成题目后,查看解析、复盘错因,并用自己的话重新说出结论。
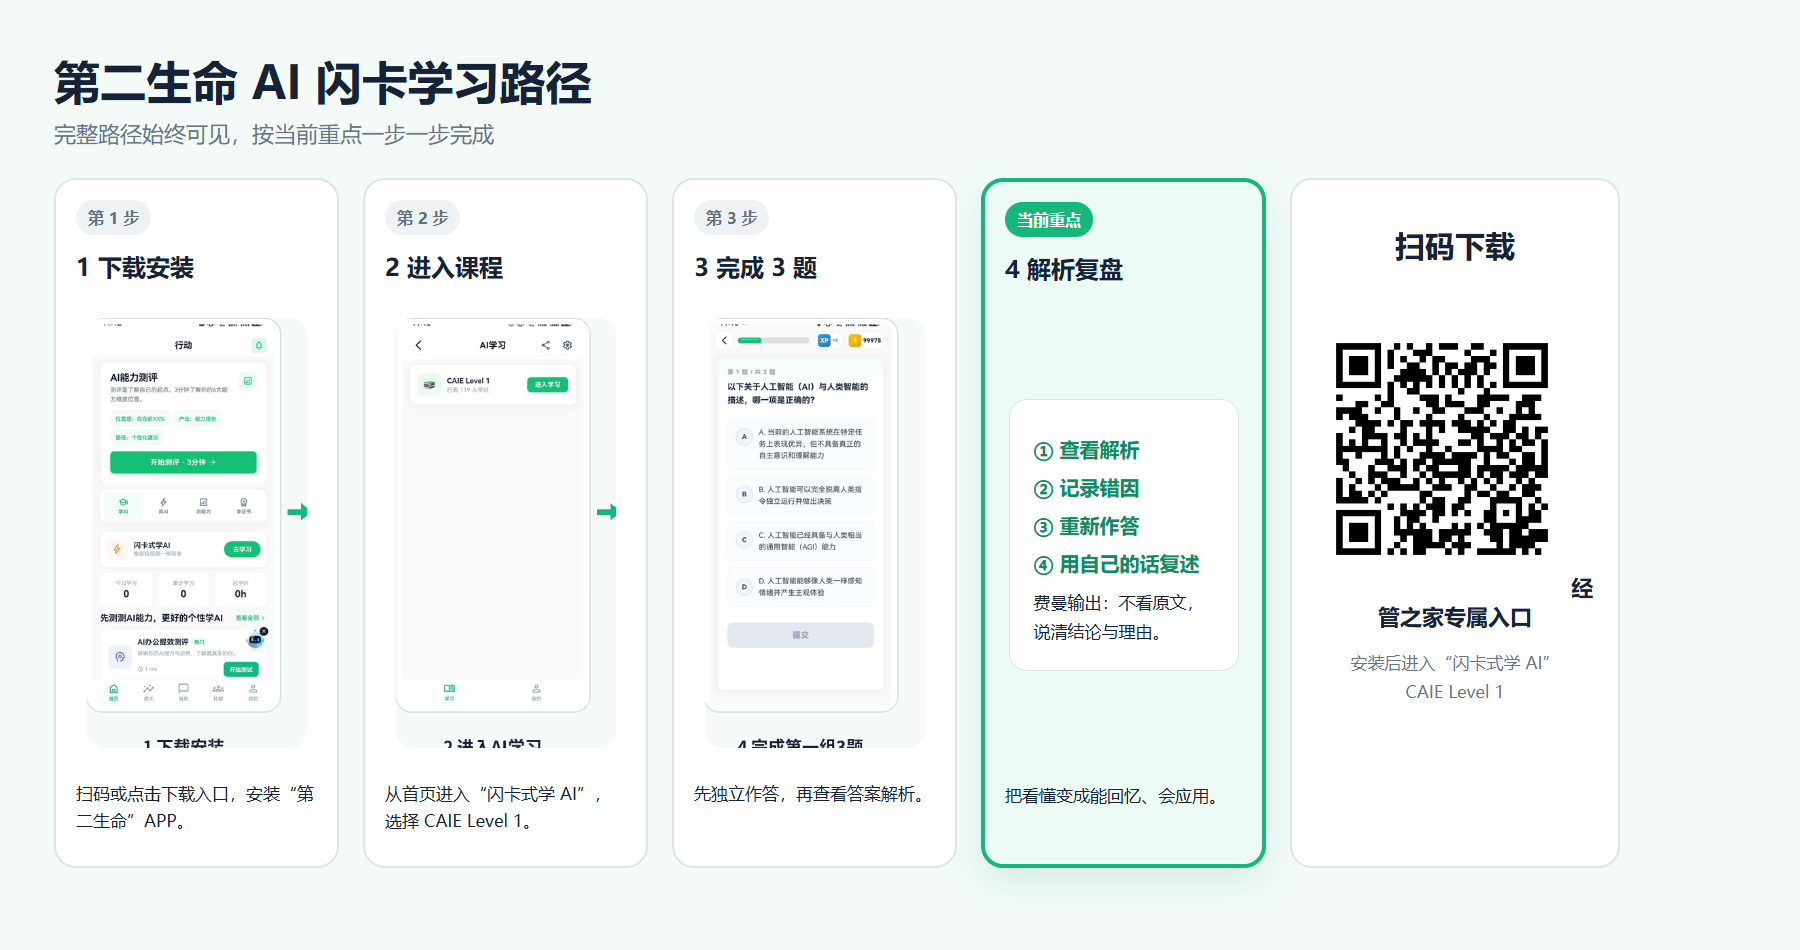
下载入口:立即下载“第二生命”APP
当前步骤:完成题目 → 查看解析 → 记录错因 → 用自己的话复述结论。

 京公网安备 11010802022788号






