


 发帖

 雷达卡



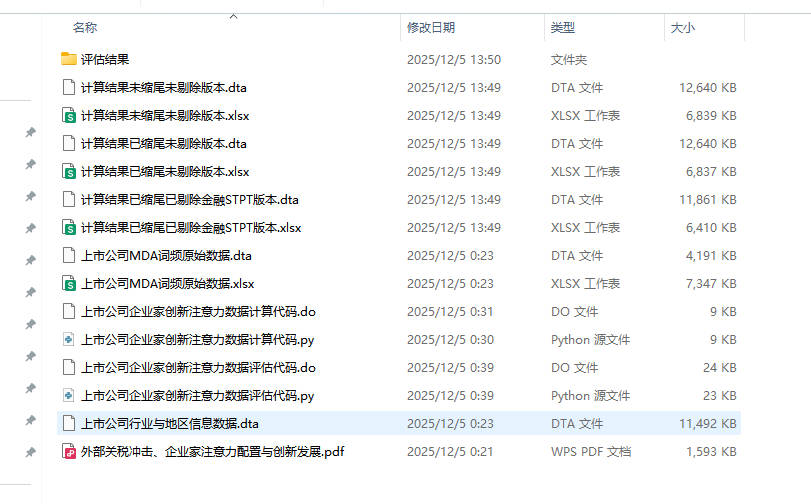
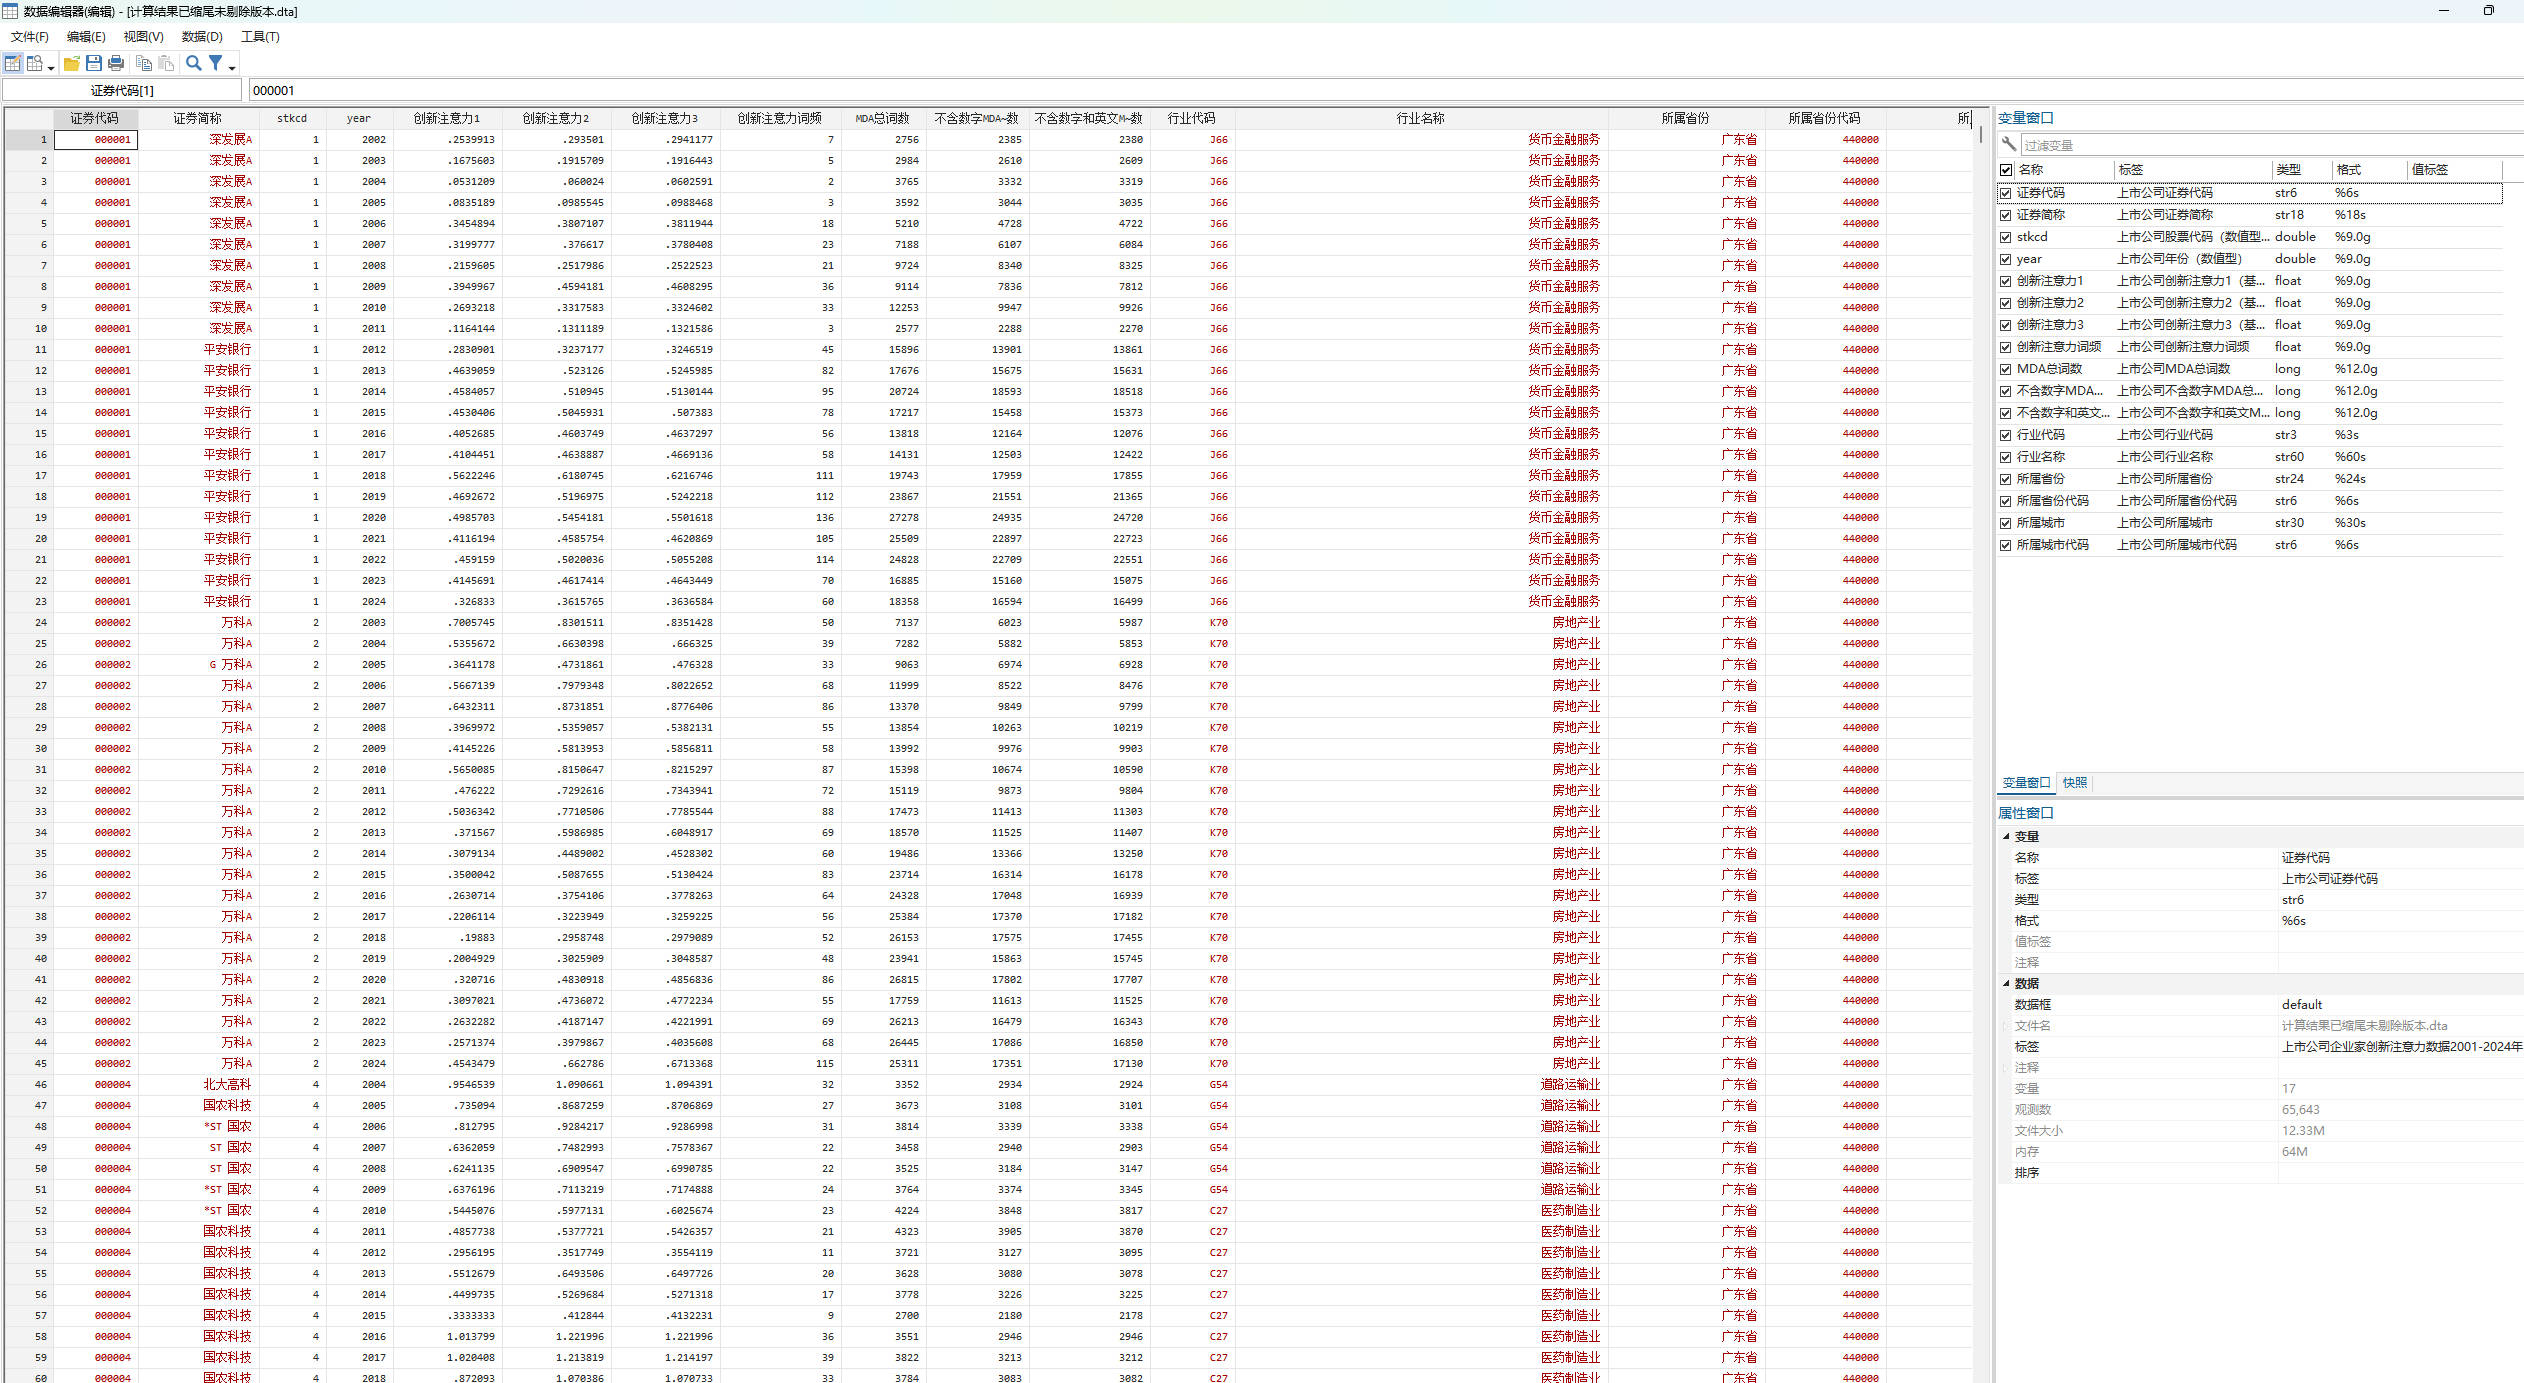
年份:2001-2024
范围:A股上市公司
三个版本:创新注意力(未缩尾未剔除金融STPT)、创新注意力(未缩尾已剔除金融STPT),创新注意力(已缩尾已剔除金融STPT)
文件格式:Dta格式(使用Stata打开)、Xlsx格式(使用Excel打开)
注:提供了剔除所需数据和剔除代码,若无需做该项剔除处理,自行删除相关代码重新运行即可
行业参照证监会2012年行业分类标准,制造业用二级行业分类,其他用一级分类来计算并对连续型变量进行了1%和99%分位数的缩尾处理
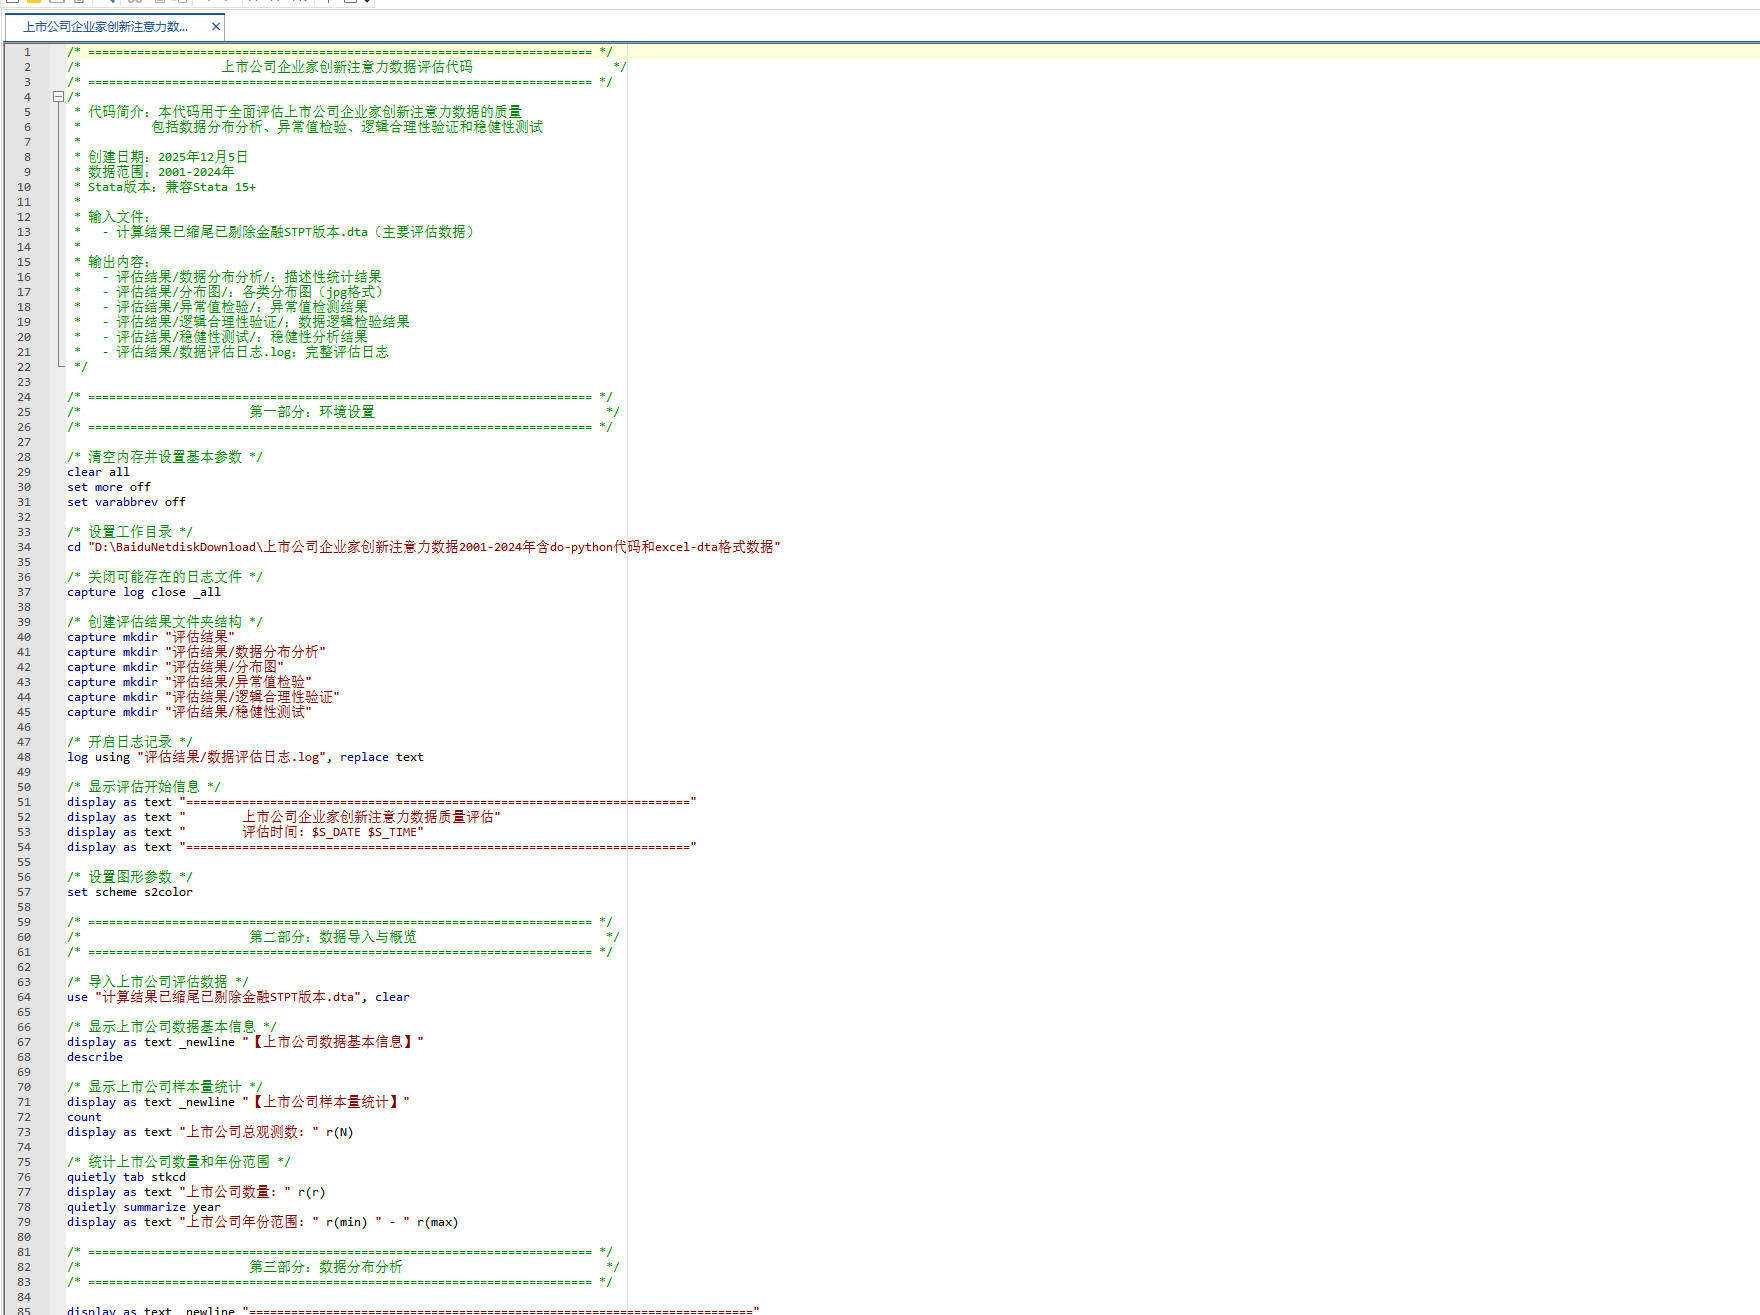
代码格式:do/python文件代码,含生成代码和分析评估代码
计算说明:
数据来源与指标构建
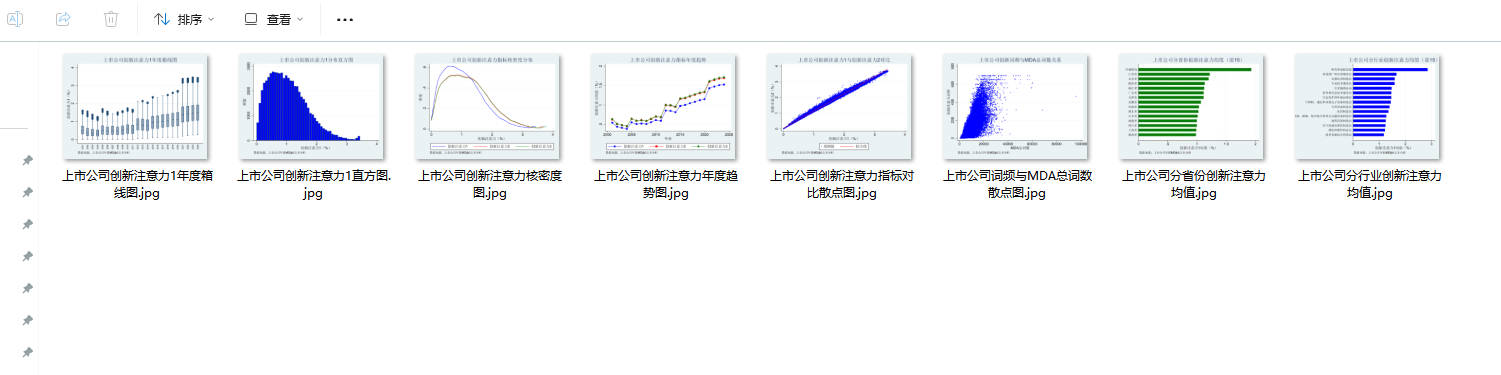
本数据基于中国A股上市公司年报中管理层讨论与分析(MD&A)部分的文本内容,参考余振等(2024)发表于《世界经济》的研究方法构建企业家创新注意力指标。文本分析首先需要构建"创新注意力"词集,参照胡楠等(2021)和Brochet et al.(2015),本文通过Word2vec机器学习方法寻找近义词,缓解人为定义词表的主观性和通用近义词工具的弱相关性。利用Word2vec模型对中文年度财务报告语料进行训练后,生成词向量空间,为每个词分配一个向量,在向量空间中距离越近的词意思越近,可以通过两词的距离计算相似性。
词集筛选方法
具体筛选词集方式如下:第一步为选择既往中文文献中曾用过的"创新注意力"词集作为基础词(黄珊珊和邵颖红,2017),其中包括:"创新""自主""自主""科研""新产品""技术""开发""研究""专利"。第二步根据Word2vec中的CBOW模型(连续词袋模型,Continuous Bag-of-Words Model)对中文年度财务报告语料进行训练,生成词向量空间,在词向量空间中对基础词的相似词进行筛选。筛选标准为:财报文本语料中出现频次在1000次以上,且和基础词频相似度在30%以上的拓展词。第三步为邀请了3名业界和学术界专家对CBOW模型得到的相似词进行人工核查,并筛选出包括"发明"和"技术成果"等额外的"创新注意力"拓展词集。
指标计算方法
本文将"创新注意力"基础词集和"创新注意力"拓展词集分别作为文本分析的词典,并基于词典法对每家企业的年报中MD&A部分进行词频分析。通过计算词集中词汇总词频占MD&A总词频的比例并乘以100,得到企业家创新注意力配置指标。为了验证稳健性,本文还计算了两个指标:词集总词频占不含数字MD&A总词数的比例、词集总词频占不含数字和英文MD&A总词数的比例。这两个指标数值越大,表示企业家越注重创新。
参考文献
外部关税冲击、企业家注意力配置与创新发展
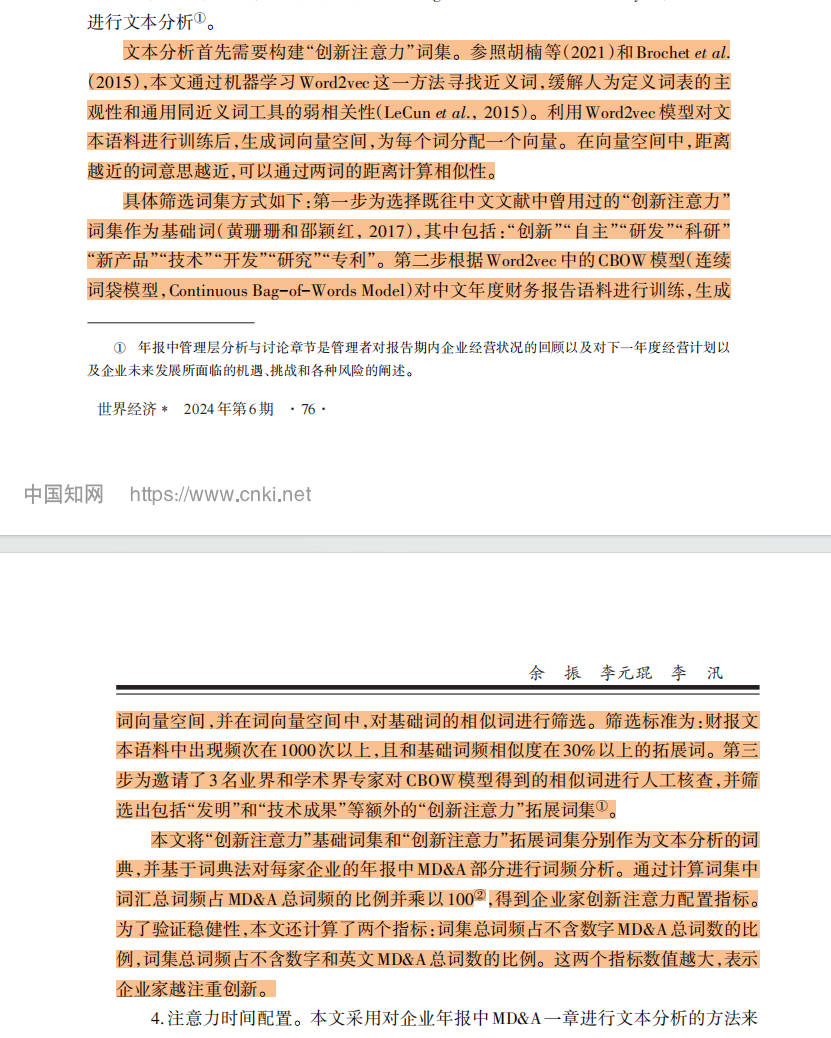
计算代码及评估代码:
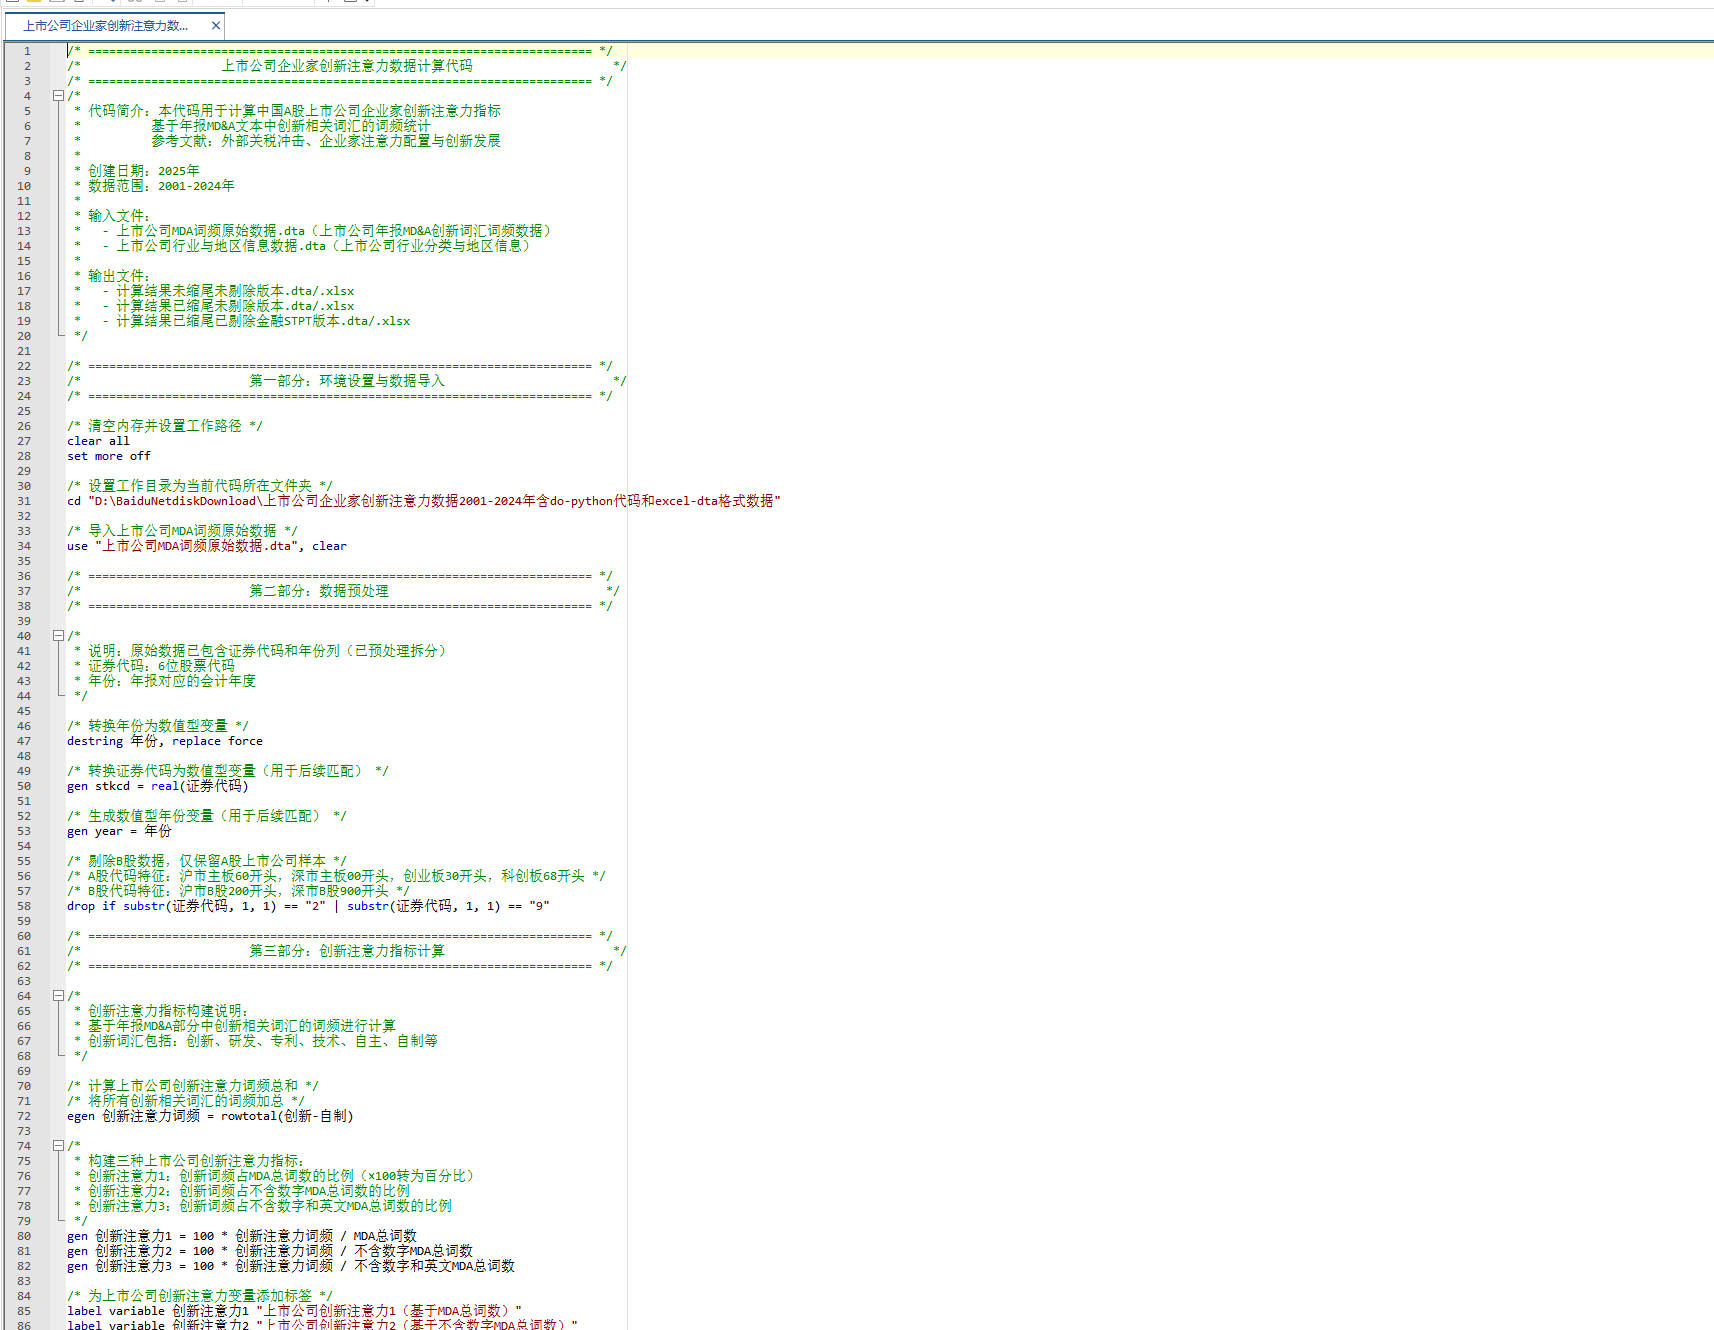
结果数据


 京公网安备 11010802022788号






