


 发帖

 雷达卡



很多人把统计学理解为“一堆公式和计算”,却忽略了它的本质——一门让数据“开口说话”的科学。真正的数据分析高手,不是会算平均数,而是能通过统计概念洞察业务规律。
统计基本概念并非孤立的理论,而是围绕“数据描述、总体推断、风险预判”形成的系统化工具集。CDA数据分析师凭借“统计专业能力+业务理解能力”,成为统计基本概念的“落地转化者”——他们能精准匹配业务需求选择统计方法,用通俗的业务语言解读统计结论,让抽象的统计概念转化为可落地的商业行动。本文将从CDA认证的知识体系出发,系统拆解统计学的本质与基本概念,帮助你把“死记硬背”的统计知识,转化为“活学活用”的数据分析能力。
一、统计学是什么——数据分析的“方法论武器”
1. 统计学的科学定义
统计学是一门收集、处理、分析、解释数据,并从数据中得出结论的科学。这一定义涵盖了一个完整的分析闭环:
收集数据 → 处理数据 → 分析数据 → 解释数据 → 得出结论
”
收集数据:确定数据来源,设计数据获取方案 处理数据:数据清洗、缺失值处理、异常值排查 分析数据:运用统计方法探索数据特征和规律 解释数据:将分析结果转化为业务可理解的语言 得出结论:提出可执行的商业建议
调查和实验是数据收集的两种主要方法,基础的数据分析方法又分为两大类:描述性统计分析方法和推断性统计分析方法。
2. 描述性统计与推断性统计——两大核心支柱
在CDA一级的考试大纲中,统计基本概念模块主要聚焦于这两大分支的底层认知。
描述性统计:涉及收集、整理、总结和呈现数据的技术。它回答的是“数据长什么样”的问题。例如:平均客单价是多少?销售额的波动有多大?——这些都不需要推断,只需要对已有数据进行汇总和描述即可。描述性统计分析要对调查总体所有变量的有关数据进行统计性描述,主要包括数据的频数分析、集中趋势分析、离散程度分析和分布形态分析,以及一些基本的统计图形。
推断性统计:涉及利用样本数据推断总体特征的技术。它回答的是“从样本能得出什么总体结论”的问题。例如,对1000个用户进行了调查,能推断出全部100万用户的行为特征吗?——这就需要推断统计的方法。推断性分析包含参数估计、假设检验、列联分析等内容。
数据分析过程的起点是总体,分析的终点往往是推断。总体是定值,样本是变量。
3. 数据分析与数据挖掘的区别
数据分析与数据挖掘两者常被混淆,但定位不同:
数据分析:以探索数据内的有效信息为主要途径,以解决业务需求为最终目标,包含业务理解、数据清洗、数据探索、数据可视化、数据建模等一整套分析流程 数据挖掘:侧重于从海量数据中发现未知的模式和规律,通常涉及机器学习算法
两者的核心区别在于:数据分析重在“解释已有现象”,数据挖掘重在“发现未知规律” 。
二、统计的基本概念——数据分析的“识字课”
数据、总体、样本、参数、变量这些概念是统计学的基本构成元素,理解它们是掌握所有后续统计方法的前提。
1. 总体与样本——“全部”与“部分”
总体:指根据研究目的确定的同质研究对象的全体。总体是“所有元素的集合”,其中每个元素称为个体。
例如,研究“我国男性的平均身高”这一问题时,总体应为我国所有男性。
样本:从总体中随机抽取的部分个体。例如,从我国所有男性中随机抽取1000人进行身高测量,这1000人就是样本。构成样本的元素的数目称为样本容量。
在实际工作中,我们很少能接触到完整的总体数据——用户有100万,订单有1000万条,但分析资源有限。数据分析师的工作常态是:基于样本数据,推断总体特征。
2. 参数与统计量——“未知的真相”与“已知的线索”
参数:指研究者想要了解的总体的某种特征值。参数通常是未知的,因为不可能观测到总体中的所有个体。常见的参数有总体均值、总体标准差、总体比例等。
统计量:指根据样本数据计算出来的一个量,即样本的某个特征值。常见的统计量有样本均值、样本标准差、样本比例等。
参数是客观存在的“事实”,统计量是我们手中掌握的“线索” 。数据分析师的任务,正是通过手中的统计量,去推断和估计未知的参数。
3. 变量——数据的“容器”与数据类型
变量是描述个体某个特征的名称,其取值会随着个体的不同而发生变化。
数据的计量尺度和具体的统计方法息息相关,大致分为3类:
| 计量尺度 | 变量类型 | 特征 | 典型示例 |
|---|---|---|---|
| 名义测量 | 分类变量 | 最低等级,仅区分类别,无大小、顺序关系 | 性别(1或2)、民族(1、2、3…) |
| 次序测量 | 顺序变量 | 量化水平更高,数值代表有序分类 | 受教育程度的高低(1、2、3…) |
| 连续变量测量 | 数值变量 | 量化程度最高,采用实际测量值 | 年龄、身高、销售额、温度 |
连续变量测量可进一步细分为间距测量和比例测量:
间距测量:可进行加减运算,但不能进行乘除运算,因其“0”值不是物理上的绝对“0” 比率测量:最高级的测量等级,0值具有物理上的绝对意义,可进行加减乘除运算
✅ 数据级别的排序:从数据级别的高低排序,依次是数值数据 > 顺序数据 > 分类数据。数值数据包含的信息最丰富,可以进行算术运算;顺序数据只能比较大小,不能做加减;分类数据只能区分类别,信息量最少。
三、常用统计分布——数据世界的“规律地图”
1. 正态分布——“最自然的分布”
正态分布是最常见、最重要的连续型概率分布,许多自然和社会现象都近似服从正态分布(如身高、考试成绩、测量误差等)。正态分布的形态呈“钟形曲线”,对称分布在均值两侧,具有“中间高、两头低”的特点。
正态分布在数据分析中的应用极为广泛,是参数估计、假设检验等推断统计方法的重要理论基础。
2. 两点分布与二项分布
两点分布(也称伯努利分布)是最简单的离散型概率分布,只有两种可能的结果(成功/失败、是/否)。例如:掷一次硬币,正面朝上的概率为p,反面朝上的概率为1-p。
二项分布是n次独立的两点分布试验之和,描述的是在n次试验中成功次数k的概率分布。
四、实战演练:从一份“用户满意度调查”看统计概念的完整应用
背景
你是某互联网公司的数据分析师。公司刚刚进行了一次用户满意度调查,收集了500份有效问卷。调查内容包括:用户ID、年龄、性别、城市等级(一线/新一线/二线/其他)、满意度评分(1-5分)、是否推荐给朋友(是/否)。
老板要求你回答以下问题:
用户的平均满意度是多少?波动大不大? 不同城市等级的用户,满意度是否有差异? 能否用这500个样本推断全体100万用户的情况?
完整操作流程
第一步:明确总体与样本
总体:该公司全部100万注册用户 样本:500份有效问卷的填写用户 目标:用样本统计量推断总体参数
第二步:识别变量类型与计量尺度
| 变量 | 计量尺度 | 变量类型 | 说明 |
|---|---|---|---|
| 用户ID | 名义测量 | 分类变量 | 仅用于标识,不能计算 |
| 年龄 | 比率测量 | 数值变量 | 有绝对零点,可比较倍数 |
| 性别 | 名义测量 | 分类变量 | 仅区分类别,无顺序 |
| 城市等级 | 次序测量 | 顺序变量 | 一线>新一线>二线>其他 |
| 满意度评分 | 间距测量 | 数值变量 | 1-5分,无绝对零点 |
| 是否推荐 | 名义测量 | 分类变量 | 是/否两类结果 |
第三步:描述性统计分析
根据CDA大纲的要求,描述性统计需从集中趋势、离散程度、分布形态三个维度进行描述:
集中趋势:计算满意度的均值、中位数、众数 离散程度:计算满意度的标准差、方差、极差等 分布形态:观察偏态与峰态
第四步:推断统计
用样本统计量推断总体参数:
点估计:样本平均满意度为4.2分 → 推断总体平均满意度约为4.2分 区间估计:计算95%置信区间 → 推断总体平均满意度在4.1-4.3分之间
这就是一套完整的“识别变量类型 → 描述性统计 → 推断统计”的实战流程。掌握了统计基本概念,你就能从一堆数字中提炼出有价值的商业洞察。
”
结尾:从“会用统计量”到“用统计做分析”
很多数据分析师会算均值、标准差,但当被问到“总体和样本有什么区别”“参数和统计量有什么关系”“数据级别的排序是怎样的”时,却答不上来。
知其然还要知其所以然,这正是CDA Level I认证的价值所在。
统计基本概念模块在CDA一级考试中要求达到**〖熟知〗级别**,是考试的重点部分。从统计学的含义与应用,到总体、样本、参数、变量等核心概念,再到正态分布、两点分布等常用分布——这些知识不仅是考试的得分点,更是数据分析师日常工作的“底层语言”。
统计基本概念是商业数据分析的“基础语言”——从描述数据分布的“均值、中位数”,到推断总体特征的“抽样、置信区间”,再到验证业务假设的“假设检验”,这些概念构成了数据分析的底层逻辑。CDA数据分析师凭借“统计专业能力+业务理解能力”,成为统计基本概念的“落地转化者”。
下一步行动:
找一份真实的业务数据,练习识别各列数据的变量类型和计量尺度 用描述性统计方法(均值、标准差、直方图、箱型图)快速了解数据的分布特征 尝试用一个样本数据,推断总体的关键特征
数字是冰冷的,但掌握统计的人能让它们说出真相。
”
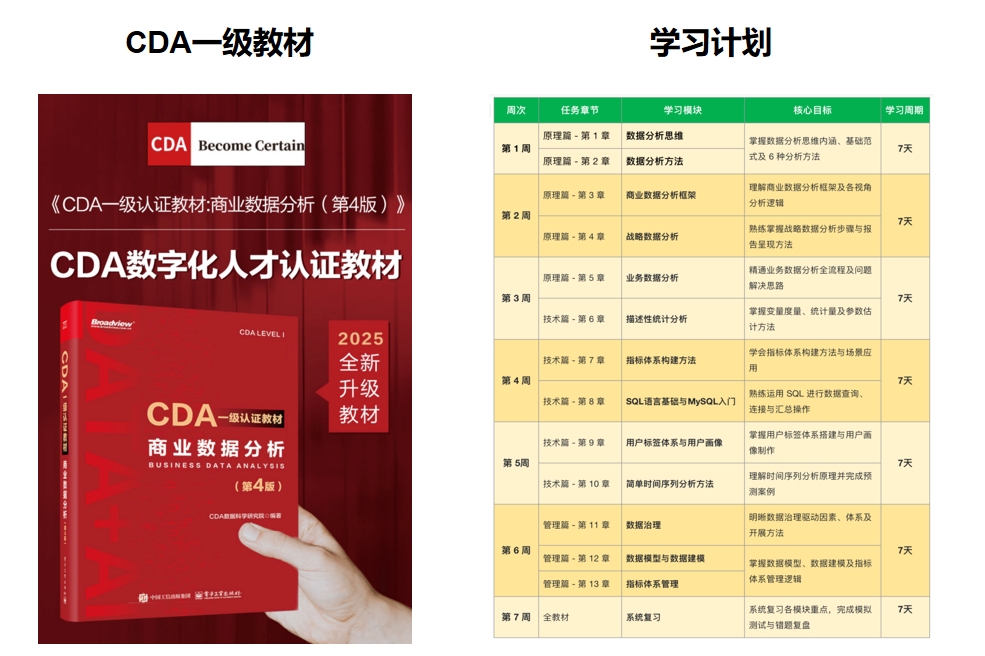
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !




 京公网安备 11010802022788号






