


 发帖

 雷达卡



一、大模型推理延迟的核心痛点
随着大语言模型(LLM)从科研原型走向产业落地,所有工程团队都会面临一个核心现实:搭建智能模型只完成了一半工作,面向用户提供实时推理服务,是完全独立的另一大工程难题。
在生成式AI领域,推理指训练完成的模型接收输入提示词、生成回复的完整过程,而推理延迟就是这一过程的耗时。传统Web应用的延迟通常以毫秒为单位,但若不做专项优化,大模型推理延迟会高达数秒甚至更久,直接导致用户体验极差、算力成本居高不下。
想要优化延迟,首先需要理清大模型的生成逻辑,其推理分为两个独立阶段:
1. 预填充阶段(读取阶段):模型一次性读取全部提示词内容。该阶段属于计算密集型任务,提示词越长,预填充耗时越久。
2. 解码阶段(生成阶段):模型逐Token串行生成回复内容。由于每一个新Token都需要依赖前文所有Token的上下文,该阶段无法并行计算,属于内存带宽密集型任务。
两个阶段对应决定用户体验的两大核心指标:首Token响应时间(TTFT)(首个输出Token的生成耗时)、单Token生成耗时(TPOT)(后续持续生成的速度)。
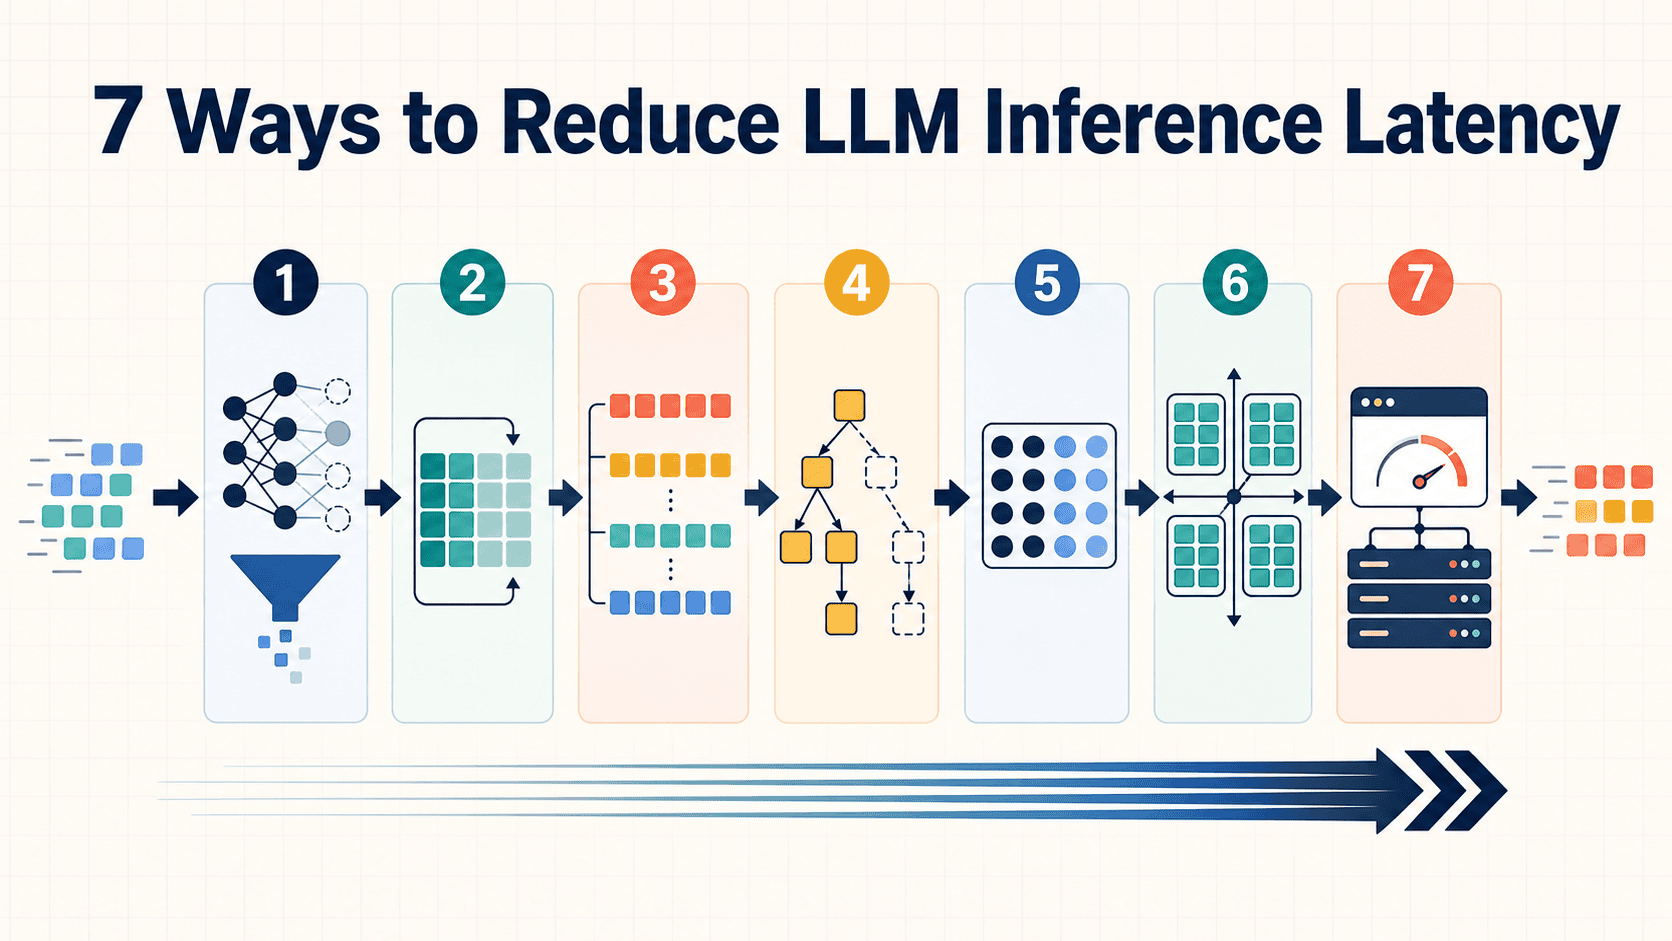
下文将详解七种经过产业验证、可落地的大模型推理延迟优化方案。
二、七大推理延迟优化方案
方案一:模型量化
大语言模型的本质是海量数值权重的集合。默认情况下,模型权重以16位浮点格式(FP16/BF16)存储。一个700亿参数的模型,仅加载FP16权重就需要约140GB显存;每生成一个Token都需要在GPU中频繁搬运这些数据,会造成严重的内存带宽瓶颈,直接拉高单Token生成耗时(TPOT)。
量化技术的核心是将模型权重从16位浮点压缩为8位整型(INT8)或4位整型(INT4),大幅缩减模型内存占用。4位量化模型的内存吞吐速度是FP16模型的4倍,可直接降低解码阶段的推理延迟。
该方案的取舍:模型推理精度会出现轻微损耗。不过目前主流的激活感知权重量化(AWQ)、GPTQ等优化量化技术,能够最大限度减少精度损失,实现速度与效果的平衡。
方案二:键值缓存(KV缓存)
大模型基于Transformer架构搭建,核心依赖自注意力机制。当模型生成第100个Token时,需要计算该Token与前99个Token的关联关系。如果每生成一个新Token,都重复计算所有前文Token的键值矩阵,会产生海量冗余计算,而**键值缓存(KV缓存)**正是为消除这一冗余设计。
KV缓存会将已处理Token的键、值矩阵预存在显存中。生成下一个Token时,模型直接读取缓存的历史上下文,仅对最新Token做计算,大幅缩减运算耗时、降低TPOT。
该方案的取舍:存在显存占用成本。随着生成文本长度增加,KV缓存会动态扩容、持续占用显存。因此,生产级大模型系统的核心优化要点之一,就是平衡缓存容量与生成速度。
方案三:推测解码
大模型自回归生成的串行特性,是推理延迟最顽固的瓶颈。后一个Token的生成必须依赖前一个Token的结果,无法直接并行加速。而推测解码通过双模型联动机制突破了这一限制,支持模型一次性批量生成多个Token。
整套机制依赖两个模型协同工作:
- 目标模型:高精度、大参数量、推理速度慢(如 Llama-3-70B)
- 草稿模型:轻量、小参数量、推理极速(如 Llama-3-8B)
核心运行逻辑(伪代码示例)
# 草稿模型快速批量生成5个候选Token(耗时可忽略)
draft_tokens = draft_model.generate(prompt, n=5)
# 目标模型一次性并行校验所有候选Token
accepted = target_model.verify(draft_tokens)
# 校验通过则批量采纳所有Token,完成快速生成
output_tokens.extend(accepted)
在实际落地中,Hugging Face 框架可直接通过 assistant_model=draft_model 参数启用该能力,自动完成校验循环逻辑。当草稿模型生成内容准确率较高时,可彻底规避串行生成的内存带宽瓶颈,在不损失输出质量的前提下,将生成速度提升2–3倍。
方案四:连续批处理
传统机器学习服务器采用静态批处理机制提升GPU利用率:收集一批请求后统一并行处理,全部完成后再统一返回结果。该机制适配常规任务,但不适用于大模型——大模型的输出Token长度差异极大。若一批4个请求中,3个仅需100个Token即可完成,1个需要1000个Token,前3个请求会被迫等待,造成资源浪费与延迟升高。
**连续批处理(迭代级调度)**彻底解决该问题:无需等待整批请求完成,推理引擎以Token为最小粒度,持续接入新请求、剔除已完成请求。短请求完成后立即返回结果,释放的算力资源即刻调度给新用户,有效降低单请求延迟与服务器整体等待耗时。
方案五:模型剪枝与知识蒸馏
如果说量化是压缩模型权重的存储体积,模型剪枝则是直接剔除无效权重。神经网络普遍存在参数冗余,并非所有神经元、注意力头都对任务效果有正向贡献。剪枝技术通过识别并移除低效层、无效注意力头,精简模型整体架构,从根源减少计算量。
知识蒸馏则是另一种优化思路:用高精度大模型(教师模型)的输出逻辑,训练轻量化小模型(学生模型),让小模型复刻大模型的推理能力。诸如情感分析、结构化数据提取等简单任务,无需70B超大模型支撑。将大模型能力蒸馏至8B专用小模型后,推理延迟可大幅降低,在高端GPU上甚至能压缩至数十毫秒,同时保留任务所需的核心推理精度。
方案六:专用推理引擎部署优化
若直接使用开源框架默认的生成接口部署大模型,必然会存在严重的延迟问题。主流开源框架主打科研灵活性与调试便捷性,并非为生产环境的高吞吐、低延迟场景设计。想要极致提速,必须依托专用推理服务框架部署模型。
行业主流高性能推理引擎:
- TGI(Hugging Face):基于Rust+Python开发
- vLLM:基于Python,搭载优化后的C++/CUDA核心算子
- TensorRT-LLM(NVIDIA):纯C++/CUDA底层实现,硬件级极致优化
这类专用引擎会自动落地三大核心优化:
1. 分页注意力机制:为KV缓存提供非连续智能内存管理,提升内存利用率;
2. 内置连续批处理能力,深度适配生产调度场景;
3. 优化CUDA核心算子,实现Transformer运算硬件级加速。
无需大幅修改模型代码,仅更换部署引擎,即可同时显著优化首Token响应时间(TTFT)与单Token生成耗时(TPOT)。
方案七:上下文与提示词精细化管理
工程团队常常忽略最简单、最高效的TTFT优化手段:减少输入模型的无效数据。在检索增强生成(RAG)工作流中,开发者往往会冗余灌入海量检索上下文以防信息缺失,但其中大部分内容与当前问题无关。提示词每增加一个无效Token,都会拉长预填充阶段的计算耗时。可通过两种精准策略优化:
1. 提示词压缩
通过轻量NLP模型,对向量数据库检索的原始内容进行摘要、筛选,仅保留与问题强相关的核心语句,在不损耗答案质量的前提下,大幅削减预填充阶段的计算开销。
2. 提示词缓存
若业务依赖固定、超长的系统提示词(如2000字的行为规范指令),主流API与推理引擎支持缓存该固定提示词的预填充状态。新用户请求时,模型无需重复计算固定系统提示,仅处理用户专属提问,直接缩短首Token响应耗时。
三、生产环境的组合式优化落地
大模型推理延迟优化极少依靠单一方案,核心思路是多层优化叠加、渐进式提效。
举例:采用INT8量化模型 + vLLM部署 + 连续批处理调度 + 推测解码加速的组合方案,整体推理性能会实现质的飞跃,完全区别于原生未优化模型。
所有提速方案都存在取舍,需要平衡基础设施成本、吞吐上限与工程复杂度。落地优化时,需建立标准化评估体系,衡量投入产出比,避免单纯提速导致托管成本失控。
以上七种方案覆盖了从模型权重、内存调度、引擎部署到提示词工程的全链路推理架构。系统性落地这套优化策略,是打造高速、低成本、可落地的生产级生成式AI应用的最可靠路径。
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !







 京公网安备 11010802022788号






