


 发帖

 雷达卡



爬虫与网页抓取:核心区别
很多人会混淆网页抓取(Scraping)与网页爬虫(Crawling),但二者本质完全不同。
网页抓取:针对单个指定页面提取内容。你向工具传入一个URL,工具仅返回该页面的格式化干净数据。
网页爬虫:能力范围更广。你只需提供一个起始URL,工具会自动追踪站内所有链接,批量采集关联页面的全部内容。该能力极其适合采集分散在多页面的文档资料、产品页面、博客文章、帮助中心知识库等内容。
现代网页爬虫已全面向AI原生方向迭代。新一代工具不再仅抓取原始HTML源码,还支持自然语言指令提取、结构化数据输出、Markdown/JSON标准化导出、全站检索、页面截图、AI智能体联动等能力。这意味着你可以精准指定全站提取目标信息,直接获得可用于检索增强生成(RAG)、智能研究体、数据分析、各类AI应用的高质量干净数据。
下文将详细测评2026年七款主流网页爬虫工具与API,涵盖托管式商用接口、AI原生提取工具、开源爬虫框架三大类别。
一、Olostep
Olostep 是本次测评的首选工具。其爬虫API支持单URL起步,自动遍历全站子页面,输出适配AI应用的标准化干净数据。无需逐页手动抓取,可一键爬取整站数据,快速完成RAG知识库搭建、行业调研、站点监控、结构化数据提取等工作流的数据预处理。
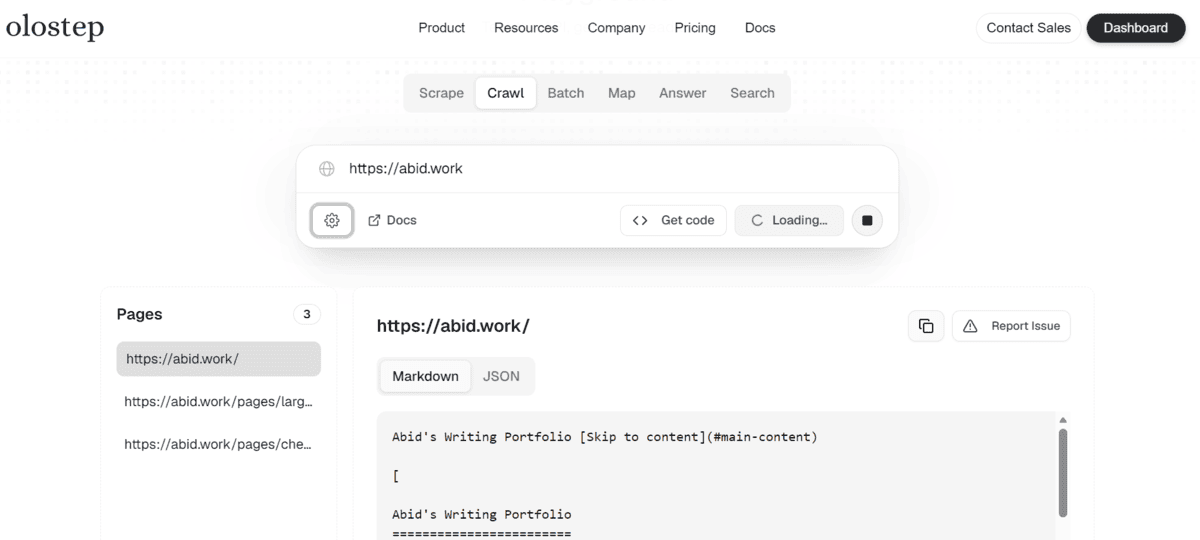
在与 Firecrawl、Exa 等主流爬虫API的对比测试中,Olostep 凭借低成本、高速度、高准确率脱颖而出。尤其适配文档站、博客、产品详情页、帮助中心、企业官网、知识库等多页面资讯类站点的数据采集场景。
该工具还提供模型上下文协议(MCP)服务、智能体插件与命令行工具(CLI),可无缝对接 Claude Code、Cursor、Windsurf、VS Code 等代码智能体与开发工具,快速搭建自动化AI工作流。
最佳适用场景:高性价比全站爬取、AI研究智能体、RAG知识库流水线、结构化数据提取、大规模网页数据自动化工作流。
二、Firecrawl
Firecrawl 是AI领域知名度最高的爬虫API之一,核心优势是极简的全站爬取体验:传入起始URL即可自动遍历关联页面,输出适配大模型应用的干净标准化数据。
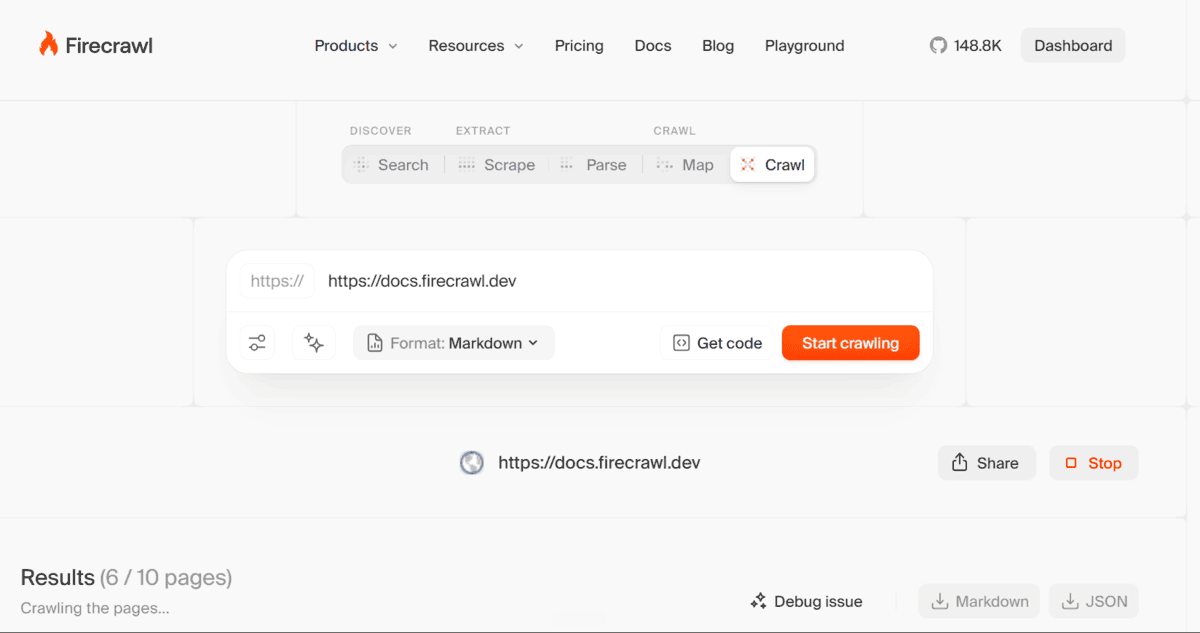
无需自研爬虫框架,即可快速采集文档站、博客、帮助中心、产品页面、知识库内容,输出格式规整,可直接接入RAG流水线、AI智能体、企业内部检索系统。
Firecrawl 与 Olostep 综合性能接近:实测中 Olostep 性价比更高,但 Firecrawl 在部分站点、特定爬取任务中,速度与准确率表现更优。
最佳适用场景:文档全站爬取、标准化Markdown数据导出、RAG流水线、AI智能体开发、大模型即用型网页数据采集。
三、ScrapeGraphAI
ScrapeGraphAI 是一款优质的本地开源爬虫与数据抓取工具,依托大模型与图逻辑算法,可实现网页、本地HTML、xm l、JSON、Markdown等多格式文件的智能数据提取。
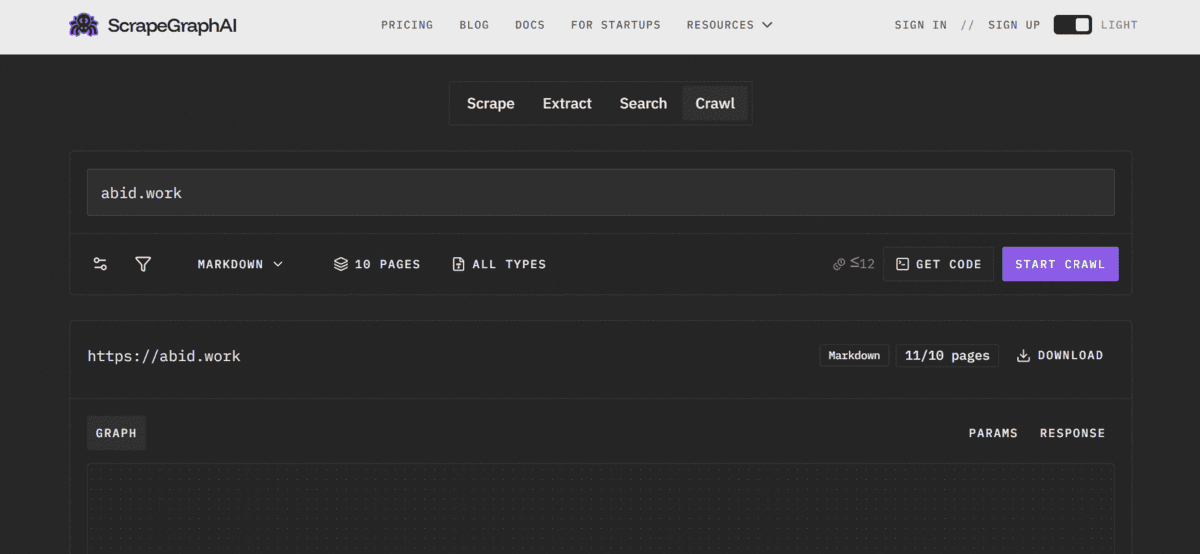
工具核心取舍在于部署配置:用户需自行接入大模型服务(OpenAI、Groq、Azure、Gemini等API),或通过Ollama部署本地模型。相较于Olostep、Firecrawl这类托管式工具,它的自定义权限更高,但配置成本也更高。
内置CLI命令行工具,支持数据抓取、智能提取、全站检索、多页爬取、站点监控等功能,完美适配本地AI智能体工作流。
最佳适用场景:开源本地化爬取、AI智能抓取、自然语言指令提取、结构化JSON数据导出、自定义私有化爬虫流水线。
四、Scrapling
Scrapling 是轻量化专业Python开源爬虫框架,适配单页抓取至大规模全站爬取全场景。相比重型商用托管平台,它能为开发者提供更高的自定义控制权,是优质替代方案。
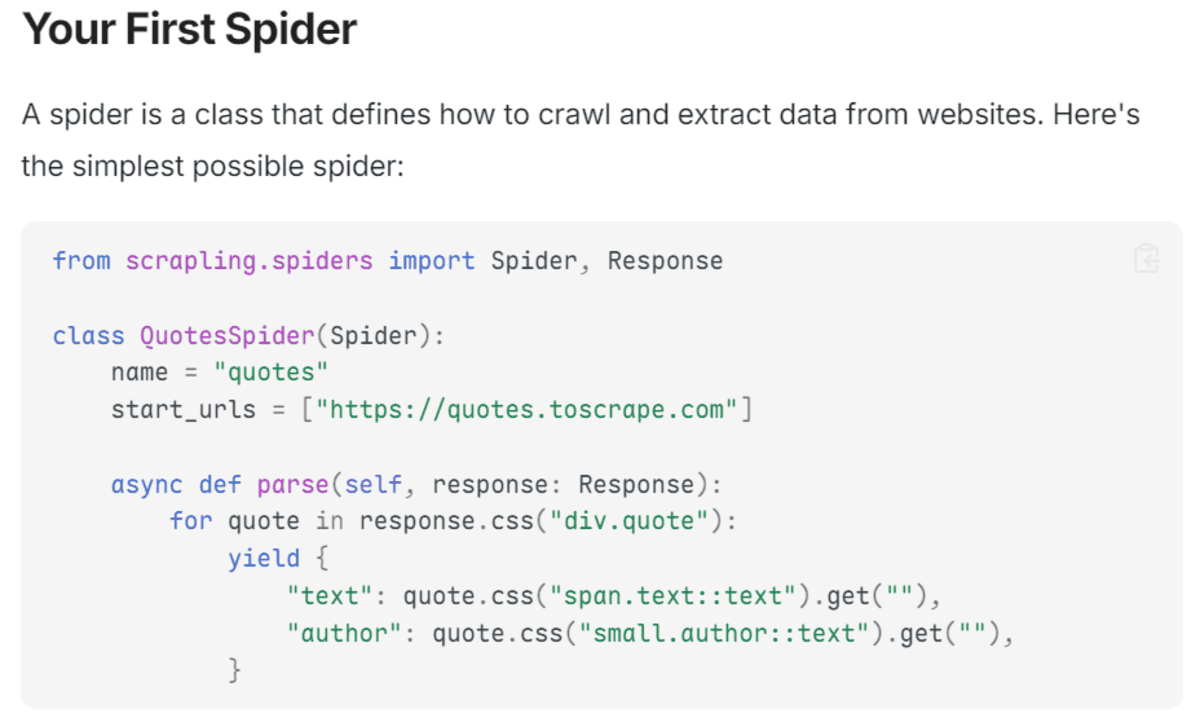
其核心亮点为自适应解析器:可自主学习页面布局变化,自动定位变动后的页面元素,大幅提升爬虫稳定性,避免网页改版导致的爬虫失效问题。同时内置数据抓取器、爬虫框架、并发爬取、任务暂停恢复、自动代理轮换等全套能力。
短板在于需要开发者自主部署、运维管理,但对于需要灵活适配现代复杂网页的Python爬虫场景,它的综合表现十分出色。
最佳适用场景:Python爬虫开发、自适应智能抓取、大规模全站爬取、定制爬虫工作流、自主运维网页数据流水线。
五、Crawl4AI
Crawl4AI 是一款免费开源、可私有化部署的爬虫工具,专为AI工作流量身打造,可将网页内容一键转换为适配大模型的标准Markdown格式,广泛用于RAG知识库、AI智能体、数据自动化流水线。
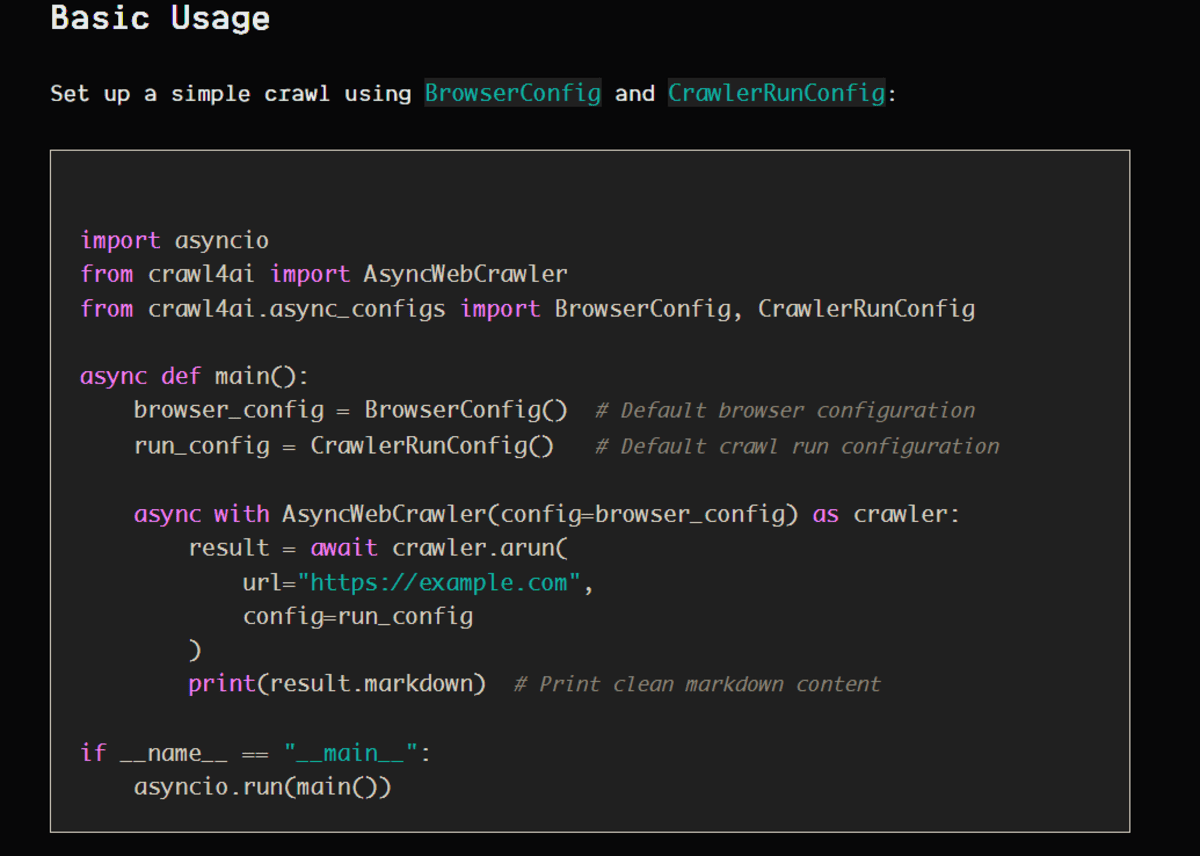
相较于Olostep、Firecrawl等托管式工具,它的自定义权限更高,支持浏览器渲染、并发爬取、代理配置、会话管理,同时兼容CSS、XPath、大模型智能提取三种结构化数据采集方式。
短板为需要自主完成部署、扩容、异常重试、站点适配等全流程运维。但作为私有化部署的AI专用爬虫,它是目前最优的开源选择之一。
最佳适用场景:私有化部署爬虫、大模型即用型Markdown数据生成、RAG流水线、AI智能体开发、自定义数据提取工作流。
六、Scrapy
Scrapy 是Python生态中最成熟、最经典的开源爬虫框架,主打结构化网页数据采集,开发者可全权自定义爬虫规则、请求逻辑、解析规则、异常重试、数据导出与流水线配置。
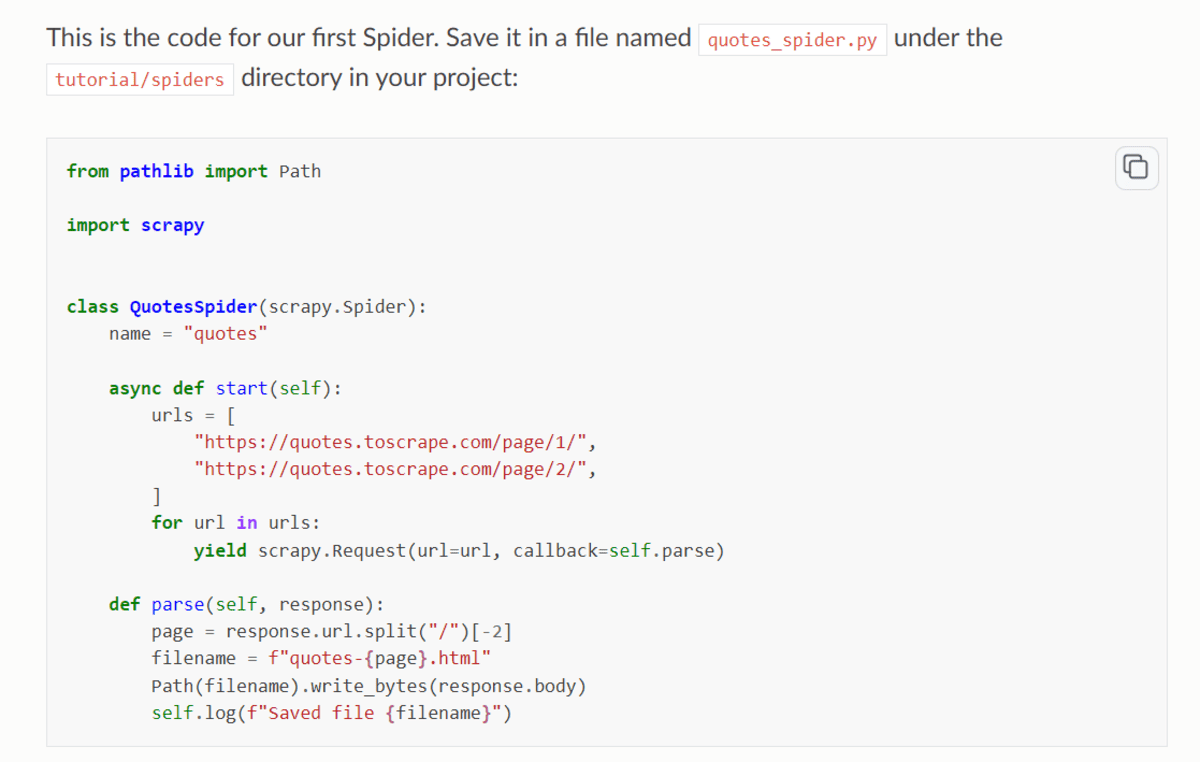
极其适配具备固定页面规律的定制化爬虫开发。核心短板为非AI原生框架,默认不支持智能格式化、自然语言提取、大模型适配输出,如需Markdown清洗、指令化提取、RAG适配能力,需自行叠加大模型层二次开发。
最佳适用场景:Python定制爬虫、结构化数据提取、大规模批量爬取、生产级数据流水线、需要全量自主管控的团队开发场景。
七、Crawlee
Crawlee 是适配 ja vasc ript、Typesc ript、Python 多语言的优质开源爬虫开发框架,内置链接发现、请求队列、异常重试、代理轮换、浏览器自动化、数据存储等全套通用爬虫能力,帮开发者规避大量基础开发工作。
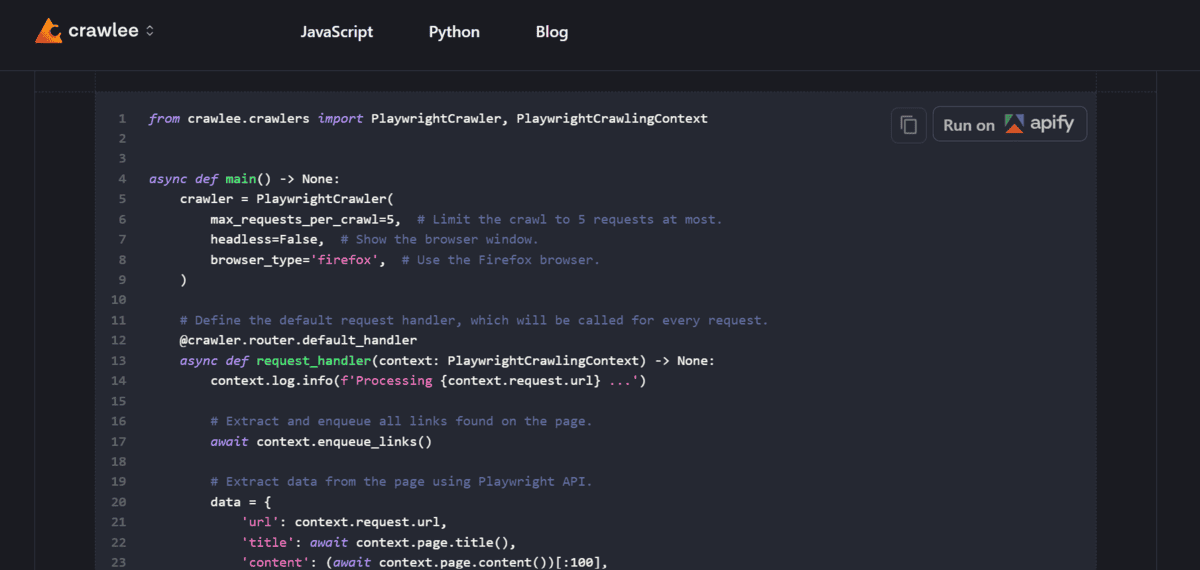
适配介于「傻瓜式托管API」与「从零自研爬虫」之间的开发场景:无需从零搭建底层逻辑,同时可深度自定义爬虫规则,完美适配定制网页爬虫、浏览器渲染页面采集、私有化部署工作流,支持团队自主掌控代码与基础设施。
短板为纯开发框架、非开箱即用AI爬虫工具,需要开发者自主开发、调试、运维爬虫逻辑,灵活性极高但存在一定开发成本。
最佳适用场景:定制化爬虫开发、前端技术栈团队(JS/TS)、Python开发团队、浏览器渲染页面爬取、私有化部署、可扩展网页数据流水线。
总结与选型建议
爬虫工具的核心选型标准:自主管控需求强度、部署运维成本、场景适配度。
1. 追求低成本、极速部署、AI智能体快速联动:首选 Olostep,综合性价比、速度、准确率最优;
2. 主打RAG与AI应用、需要极致干净的标准化网页数据:首选 Firecrawl;
3. 需本地私有化部署、自定义大模型接入:首选开源工具ScrapeGraphAI;
4. Python开发、需要自适应稳定爬虫框架:首选 Scrapling;
5. 纯免费私有化AI爬虫流水线:首选 Crawl4AI;
6. 大规模结构化数据、生产级定制爬虫:首选老牌框架 Scrapy;
7. JS/TS/Python多语言团队、需要灵活定制自研爬虫:首选Crawlee。
工具功能是基础,易用性、成本、爬取速度、数据准确率才是落地核心。最优的爬虫工具,是能以最低成本、最快速度产出干净可用数据、简化而非加重工作流的工具。
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802022788号






