


 发帖

 雷达卡



FAQ本身就是成型的问答答案,内容预制完成、问答一一对应。用户提问“我的免赔额是多少?”,只需一次检索即可获取标准答案——该答案早已由客服团队数月前编写定稿。若将FAQ当作普通PDF原始文档,套用通用的「嵌入+检索」RAG流水线,只会浪费其天然结构化优势,最终匹配效果甚至不如简单的文本查找。当数据源本身就是问答对结构时,RAG系统必须适配其专属特性。
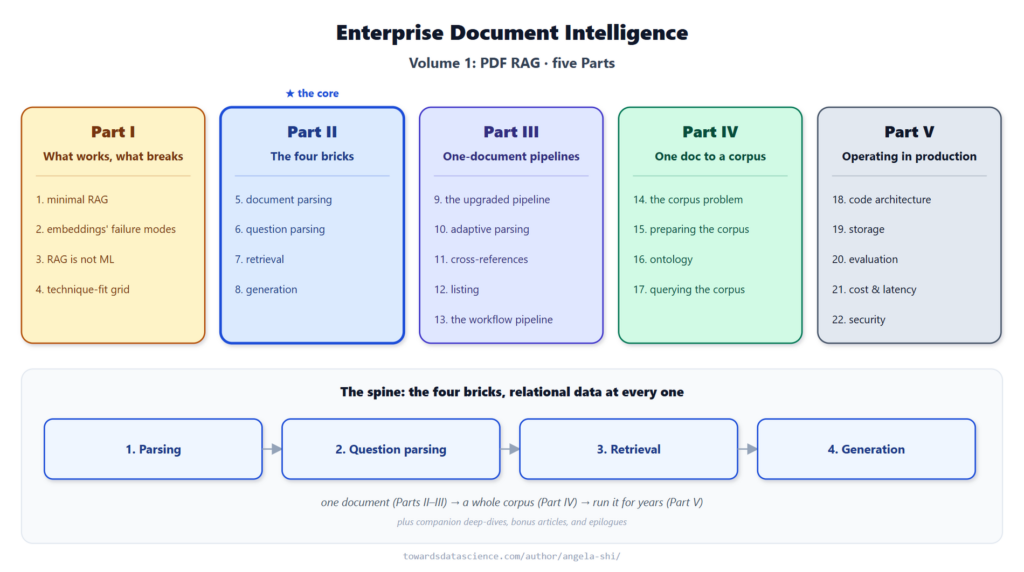
本文是《提示词与上下文循环:所有RAG系统的三大工程层级》系列文章的番外篇。该系列核心是基于四大核心模块搭建企业级RAG系统,而FAQ-RAG是特殊落地场景:开发者可自主设计语料库,流水线四大模块全部重构优化,解析流程极简、检索兼具缓存能力、少样本提示工程彻底转化为检索任务。
🧭 系列入门指引:本系列全部文章均发布在两位作者的Towards Data Science专栏,可快速查阅完整体系与本文定位: https://towardsdatascience.com/author/angela-shi/ https://towardsdatascience.com/author/kezhanshi/
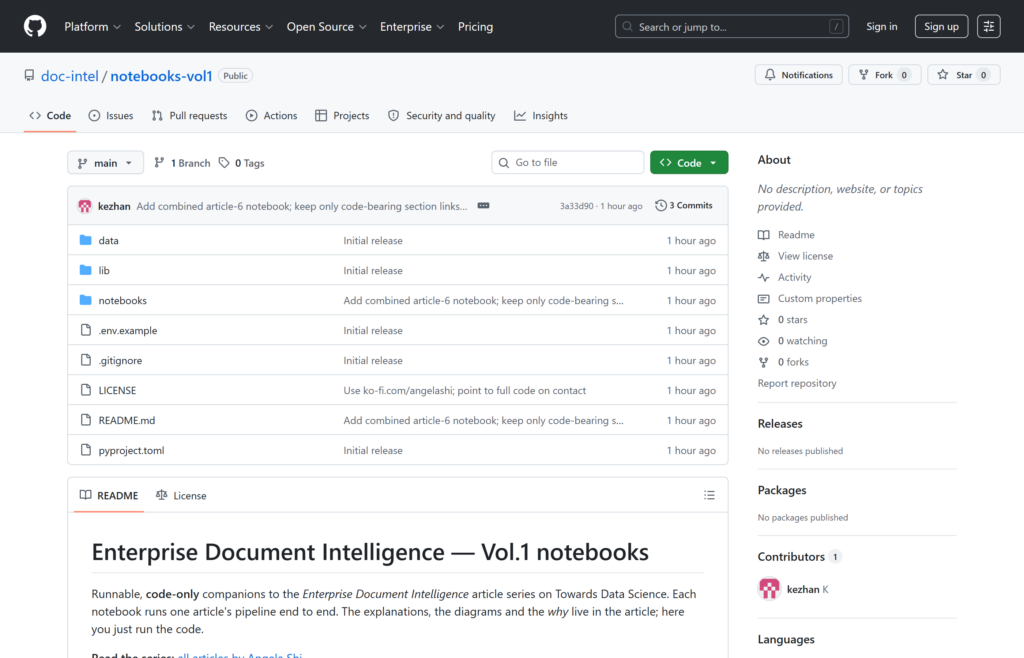
📓 可运行代码案例:GitHub开源配套工程 https://github.com/doc-intel/notebooks-vol1
客服机器人上线数周后,日志会呈现一个典型规律:用户绝大多数提问,都是15个核心高频问题的变体。“如何退保?”“能否提前终止保单?”“如何停止保障服务?”本质是同一个问题,对应的标准答案早已由客服团队两年前编写完成。但传统RAG系统会为每一次重复提问消耗生成算力,全然忽视本地已存在现成答案。
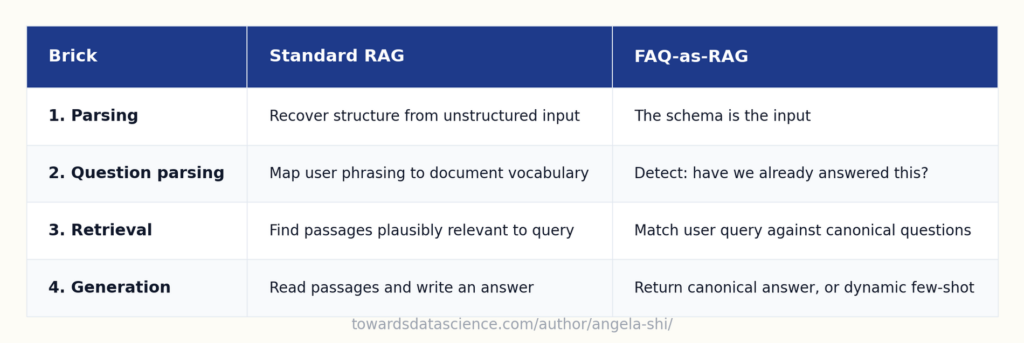
这就是典型的FAQ场景难题,绝大多数RAG教程并未覆盖该场景的优化方案。通用RAG的预设前提是:接手杂乱无章的存量语料(PDF、扫描件、合同文档),解析是核心难点。而FAQ场景完全相反:语料库由开发者自主构建,结构可完全自定义,流水线四大核心模块会随之适配重构,其中生成环节的成本远低于行业通用方案。
本篇番外将基于虚构的家庭保险产品,以15组模拟FAQ问答数据,完整拆解四大核心模块的适配逻辑。本文核心目的并非搭建FAQ问答机器人,而是论证:当语料库可自主设计时,RAG整体架构会发生颠覆性优化。
一、为何FAQ是完全不同的RAG场景
本系列常规场景中,语料库是固有约束条件:十年前撰写的合同文档、200dpi扫描生成的PDF、页码与原版不匹配,系统需要耗费大量算力与工程成本,从残缺杂乱的文件中还原有效结构。绝大多数工程工作,都是为了修复他人遗留的文档结构缺陷。
而FAQ场景的结构化优势前置:运营团队可自主定义数据范式、问答粒度(一个知识点对应一组问答)、标准提问话术、标准答案文案、分类标签。无需修复残缺结构,因为语料从源头就是规整可用的。这一特性直接重构了RAG四大模块的工程逻辑。
二、自主定义范式,解析环节极致简化
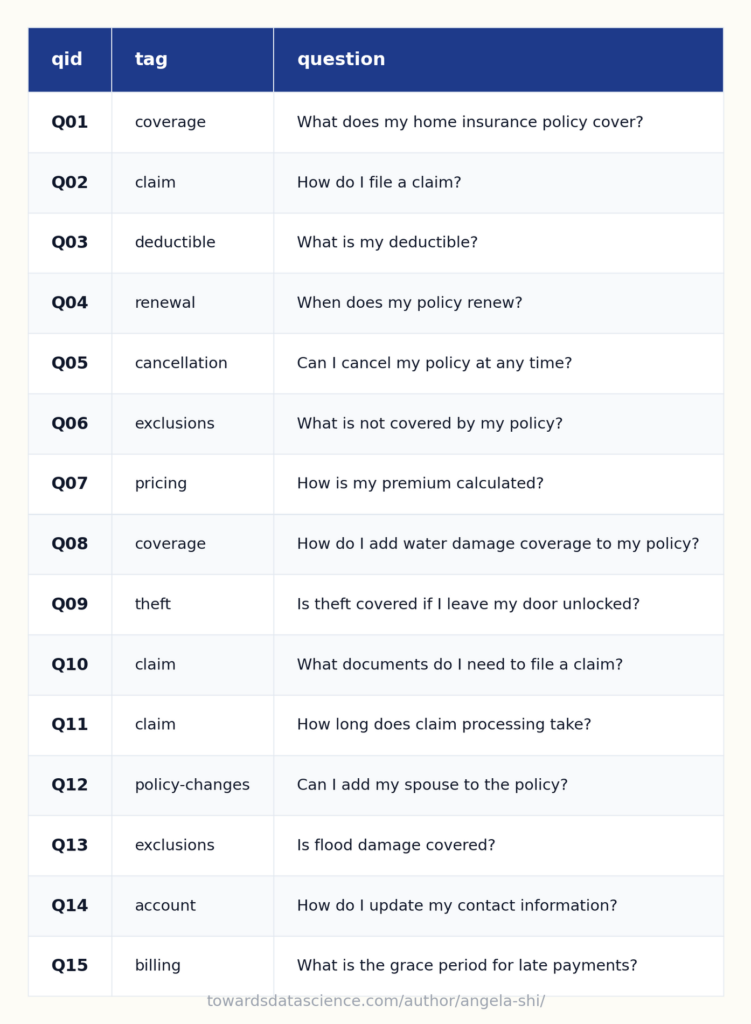
FAQ场景的“解析”,仅需加载结构化文件即可,无需处理PDF排版、无需重构页面结构、无需OCR识别。FAQ维护团队一次性定义数据范式,即可长期复用。
from pydantic import BaseModel, date

class FAQEntry(BaseModel):
    qid: str            # 用于交叉索引的唯一稳定ID
    tag: str            # 粗粒度主题分类(保障范围、理赔、免责条款等)
    question: str       # 标准化规范提问话术
    answer: str         # 面向用户的最终定稿标准答案

class FAQCorpus(BaseModel):
    entries: list[FAQEntry]
    last_updated: date  # 语料库最后更新时间
    owner: str          # 语料库维护责任团队
本系列第5篇(文档解析)、第10篇(自适应解析)提到的复杂解析工程,在FAQ场景中完全不适用。取而代之的是更关键的工作:语料库版本管理。产品迭代会同步更新FAQ答案,团队必须可追溯任意日期、任意用户收到的答案版本。这属于语料库运维范畴,而非文档解析范畴,本系列第19篇(数据存储)有详细讲解,而FAQ是该能力的高频落地场景。
三、问题解析:将用户提问转化为缓存查询
通用文档的问题解析,核心是将用户口语化提问,适配文档的专业词汇体系。而FAQ场景的核心逻辑变为:判断用户提问是否匹配已标准化的官方问答,所有查询结果仅分为三类,系统可提前预判分支逻辑:
精准匹配:用户提问与标准化问题语义完全一致,直接原样返回标准答案,无需调用大模型生成。
近似匹配:用户提问与标准化问题高度相关但不完全一致,以标准答案为基础,通过大模型小幅改写适配用户话术。
匹配失败:无匹配的标准化问题,说明提问超出FAQ覆盖范围,或属于需要新增的知识点。
三类结果可通过同一套检索能力实现区分,核心差异仅在于相似度阈值与后续处理逻辑。
import numpy as np

def classify_query(
    user_query: str,
    faq_corpus: FAQCorpus,
    *,
    direct_threshold: float = 0.92,    # 精准匹配阈值
    adjacent_threshold: float = 0.78   # 近似匹配阈值
) -> tuple[str, float, str]:
    """
    将用户提问与标准化FAQ问题匹配
    返回:(匹配问题ID, 相似度, 匹配结果类型)
    结果类型:direct精准匹配 | adjacent近似匹配 | miss匹配失败
    """
    q_vec = embed(user_query)
    sims = cosine_against(q_vec, faq_corpus.canonical_vecs)
    top_idx = int(np.argmax(sims))
    top_sim = float(sims[top_idx])

    if top_sim >= direct_threshold:
        outcome = "direct"
    elif top_sim >= adjacent_threshold:
        outcome = "adjacent"
    else:
        outcome = "miss"

    return faq_corpus.entries[top_idx].qid, top_sim, outcome
查询分类是核心前置逻辑,系统会根据分类结果路由至不同处理分支,实现精细化调度:
def answer_query(
    user_query: str,
    faq_corpus: FAQCorpus,
    llm_client,
) -> AnswerRecord:
    """顶层入口:提问分类 + 分支路由调度"""
    qid, sim, outcome = classify_query(user_query, faq_corpus)
    canonical = faq_corpus.by_qid(qid)

    # 精准匹配:缓存命中,无需大模型调用,毫秒级响应
    if outcome == "direct":
        return AnswerRecord(
            text=canonical.answer,
            source="canonical",
            qid=qid,
            similarity=sim,
        )

    # 近似匹配:以Top3标准化问答为上下文,动态少样本生成适配答案
    if outcome == "adjacent":
        prompt = build_prompt(user_query, faq_corpus, k=3)
        text = llm_client.complete(prompt)
        return AnswerRecord(
            text=text, source="dynamic_fewshot", qid=qid, similarity=sim,
        )

    # 匹配失败:记录知识点缺口,交由兜底流程处理
    log_unanswered(user_query, top_qid=qid, similarity=sim)
    return AnswerRecord(
        text=FALLBACK_MESSAGE, source="miss", qid=None, similarity=sim,
    )
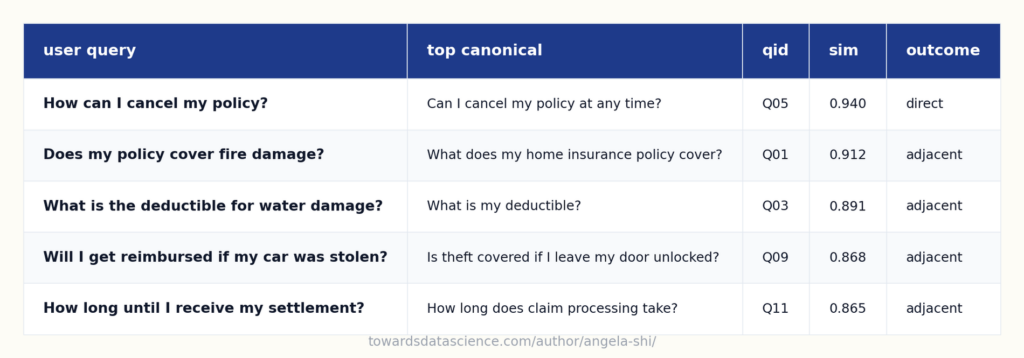
三类分支的成本差异极大:
精准匹配:耗时仅数毫秒、零大模型Token消耗,纯缓存响应;
近似匹配:一次嵌入调用 + 一次大模型生成,提示词长度可控(系统提示+3组问答+用户提问,通常低于1000Token);
匹配失败:单次运行成本最低,但长期成本最高——每一条失败记录,都代表FAQ团队需要补充优化的知识点缺口。
实战落地核心要点:
精准匹配阈值保守设置(示例0.92),仅在语义完全一致时触发缓存兜底,避免高置信度错误匹配破坏用户信任;
线上绝大多数流量为近似匹配,用户提问话术、场景、范围存在差异,需要动态适配改写;
匹配失败数据是核心迭代信号,可精准定位FAQ知识库的缺失与漏洞。
四、检索重构:将检索能力转化为系统缓存
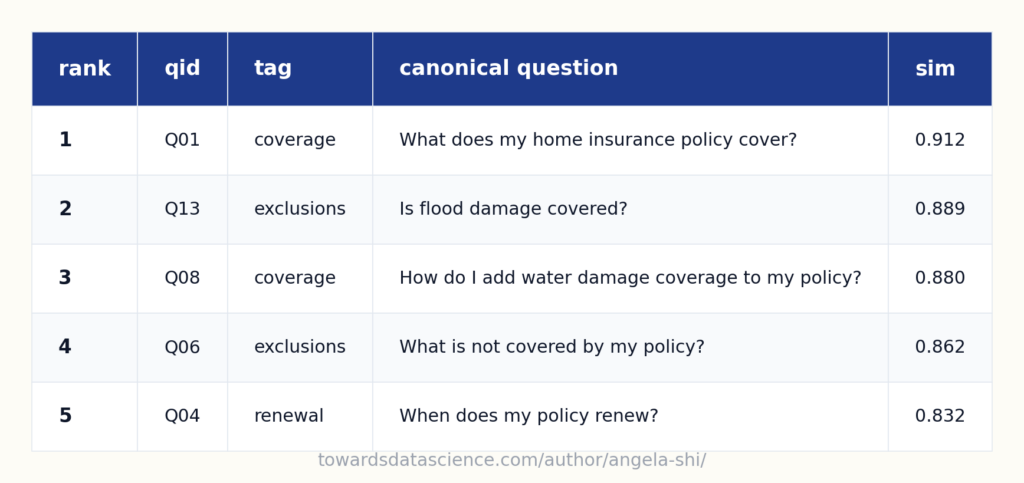
匹配分类完成后,检索流程基本结束。精准匹配直接返回标准答案,近似匹配调取Top-K邻近问答对,匹配失败则放弃当前检索结果。FAQ检索与通用RAG的核心区别:通用RAG检索文本片段,FAQ检索完整问答对——问答对是FAQ语料的最小语义单元,也是近似匹配场景下少样本生成的唯一上下文素材。
class FAQRetriever:
    """
    预计算标准化问题嵌入向量,全局缓存
    单次用户提问仅需:1次嵌入调用 + 1次矩阵向量运算
    """
    def __init__(self, faq_corpus: FAQCorpus):
        self.entries = faq_corpus.entries
        # 初始化时一次性预计算所有标准化问题向量,全局缓存
        self.canonical_vecs = np.stack(
            [embed(e.question) for e in self.entries]
        )

    def top_k(self, user_query: str, k: int = 5) -> list[tuple[FAQEntry, float]]:
        q_vec = embed(user_query)
        # 余弦相似度批量计算
        sims = self.canonical_vecs @ q_vec / (
            np.linalg.norm(self.canonical_vecs, axis=1) * np.linalg.norm(q_vec)
        )
        order = np.argsort(-sims)[:k]
        return [(self.entries[i], float(sims[i])) for i in order]
核心工程优化要点:
查询阶段语料静态化:标准化问题嵌入向量在FAQ发布时一次性计算、永久缓存,用户提问仅需单次嵌入与矩阵运算,数千条FAQ规模下,检索延迟稳定保持毫秒级;
嵌入缓存版本管理:FAQ问答文案修改后,对应嵌入向量同步更新,缓存键需关联问题原文(或原文哈希值),杜绝旧向量残留;更换嵌入模型需全局清空缓存;
小语料优先混合打分:小规模FAQ语料(如15条数据)仅靠余弦相似度易出现歧义,叠加BM25词匹配混合打分可精准纠错,融合公式如下:
def hybrid_score(
    user_query: str,
    faq_corpus: FAQCorpus,
    *,
    alpha: float = 0.6,
) -> np.ndarray:
    """
    混合相似度打分:余弦相似度(语义) + BM25(词法)
    alpha=1.0 纯余弦相似度;alpha=0.0 纯BM25
    """
    cos_scores = cosine_against(embed(user_query), faq_corpus.canonical_vecs)
    bm25_scores = faq_corpus.bm25.get_scores(tokenize(user_query))

    # 归一化至[0,1]区间,保证加权融合有效
    cos_norm  = (cos_scores  - cos_scores.min())  / (cos_scores.ptp()  + 1e-9)
    bm25_norm = (bm25_scores - bm25_scores.min()) / (bm25_scores.ptp() + 1e-9)

    return alpha * cos_norm + (1.0 - alpha) * bm25_norm
典型纠错场景:仅靠余弦相似度,“缴费金额多少?”可能同时匹配「保费定价」与「账单结算」两个近似问题,叠加BM25精准匹配关键词(保费、缴费、免赔额)后,可快速消除歧义。
五、生成优化:动态少样本替代静态固定示例
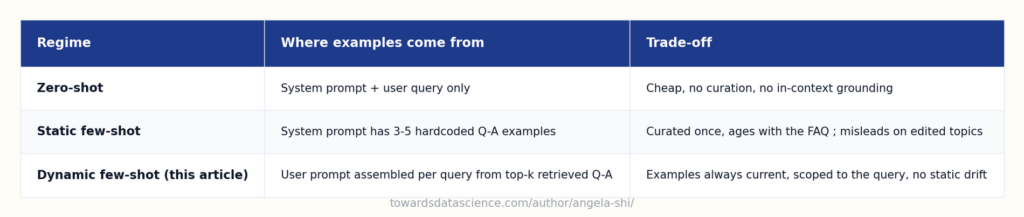
传统少样本提示工程为静态固化配置:工程师在系统提示词中硬编码3组固定问答示例,随项目打包发布。该方式初期可用,但长期会严重老化:FAQ知识库迭代更新后,静态示例不会同步更新,逐渐过时失效,成为隐性故障源头。
FAQ-RAG天然适配动态少样本:直接将本次检索获取的Top-K标准化问答对,作为实时上下文示例灌入提示词。示例随FAQ迭代自动更新,无需人工维护,完美适配知识库变更。
def build_prompt(user_query: str, faq_corpus, k: int = 3) -> str:
    """基于实时检索结果,动态构建少样本提示词"""
    similar = retrieve_top_k(user_query, faq_corpus, k=k)
    examples = "\n\n".join(
        f"Q: {row.question}\nA: {row.answer}"
        for row in similar
    )
    return (
        "你是客服智能助手,请参考下方检索的官方问答示例,回答用户问题。\n\n"
        f"--- 实时FAQ参考示例 ---\n{examples}\n\n"
        f"--- 用户提问 ---\n{user_query}"
    )
静态与动态少样本方案对比如下:
# ========== 传统静态少样本(老旧方案) ==========
SYSTEM_PROMPT = """你是客服智能助手。
示例1:
Q: 如何退保?
A: 需提前30个工作日书面申请,平台将按剩余保障天数按比例退还保费...
示例2:
Q: 我的免赔额是多少?
A: 标准免赔额为500美元,水渍理赔专属免赔额另有规定...
"""
# 缺陷:FAQ更新免赔额至750美元后,硬编码示例不会同步更新,持续输出错误答案

# ========== 本文动态少样本(最优方案) ==========
def build_prompt(user_query: str, faq_corpus, k: int = 3) -> str:
    similar = retrieve_top_k(user_query, faq_corpus, k=k)
    examples = "\n\n".join(f"Q: {row.question}\nA: {row.answer}" for row in similar)
    return "基于实时官方FAQ示例回答用户问题..."
# 优势:FAQ任意内容更新,下一次查询自动生效,提示词永久同步最新知识库
动态少样本的核心价值:
输出范围可控:杜绝大模型泛化互联网通用答案,严格匹配企业官方话术、数值、口径;
性价比极高:仅增加数百Token提示词长度,大幅提升回答精准度,成本增幅可忽略;
自动矛盾检测:若大模型生成答案与检索示例冲突,日志可精准捕获异常,快速定位FAQ内部矛盾或提问越界问题。
六、基于用户提问流,动态迭代FAQ知识库
上述方案均基于FAQ初始知识库完整的前提,但实际落地中,预先搭建全覆盖FAQ知识库成本极高,且无法预判用户所有提问话术。更合理的设计思路是:默认知识库天然残缺,通过用户真实提问持续补全迭代。
6.1 匹配失败流转人工,而非兜底通用RAG
常规RAG的惯性逻辑:FAQ匹配失败时,兜底调用产品手册通用RAG检索。该方案仅能解决表面问题,掩盖核心漏洞:新知识点的标准答案,需要业务专家定义,而非大模型自主解读文档生成。
最优架构:匹配失败的提问直接进入人工审核队列,由客服专家编写标准化问答,补充进FAQ知识库。后续同类提问即可实现精准/近似匹配,系统绝不编造无依据答案,主动暴露知识库缺口。
def route_query(user_query: str, faq_corpus, expert_queue):
    """FAQ流水线路由:双分支反向迭代知识库"""
    qid, sim, outcome = classify_query(user_query, faq_corpus)

    # 精准匹配:直接返回缓存答案
    if outcome == "direct":
        answer = faq_corpus.get(qid).answer
        return answer, {"source": "cache", "qid": qid, "sim": sim}

    # 近似匹配:动态少样本生成,同时标记待人工抽检
    if outcome == "adjacent":
        answer = generate_with_dynamic_fewshot(user_query, faq_corpus, k=3)
        expert_queue.flag_for_review(user_query, neighbor_qid=qid, answer=answer)
        return answer, {"source": "fewshot", "neighbor": qid, "sim": sim}

    # 匹配失败:升级人工处理,补充知识库
    expert_queue.escalate(user_query, sim=sim)
    return None, {"source": "expert_pending", "sim": sim}
6.2 从“主观预判高频问题”到“客观数据定义高频问题”
传统FAQ搭建均为团队主观预判高频问题,上线三个月后普遍失真:大量预设问题无人提问,用户真实高频问题却未收录。
基于提问流的迭代方案彻底反转逻辑:以初始极简知识库为基础,通过日志统计匹配失败的提问聚类频次,将高频共性问题迭代补充为标准化问答,同时下线长期无访问的陈旧知识点。最终FAQ完全贴合用户真实提问习惯,「高频问题」从主观猜测变为客观数据结论。
迭代核心链路:每条提问日志记录用户话术、匹配结果、关联QID、相似度;每周批量对失败提问做嵌入聚类,按聚类规模排序,优先由专家补充高频缺口。
6.3 人机协同:系统赋能专家,而非替代专家
三类核心人工工作,暂无任何模型可替代:
新问题标准答案编撰:企业口径、数值、例外规则、官方话术,必须由业务专家定义;
近似答案抽检审核:校验模型改写答案是否偏离官方口径,动态微调匹配阈值与标准化问答;
陈旧知识点下线更新:适配产品迭代、政策变更、规则调整,清理失效FAQ内容。
系统的核心价值是放大专家效率:复用标准化答案、精准暴露迭代缺口、统一全量用户回答口径,杜绝模型无依据编造答案。
七、场景边界:FAQ方案的局限与通用RAG的互补场景
FAQ的简化优势来自架构倒置,但通用RAG的经典难题并未消失,只是转移到了新层级:
核心难点转移为语料治理:传统RAG的解析成本,转化为FAQ的权限管控、版本追溯、内容迭代、陈旧清理等治理工作,成本并未消失,只是前置到内容编辑阶段;
全景查询仍需通用检索:针对“列出所有免责条款”这类全景统计类提问,Top-K局部检索完全失效,需要全量语料遍历能力,对应本系列第12篇「全景检索」方案;
评估体系仍需细分故障场景:聚合准确率指标无法识别FAQ核心故障——精准匹配误判,必须基于细分问题类型做专项评估。
八、总结:自主设计语料库,重构RAG全链路成本分布
FAQ-RAG的本质,是开发者主动掌控语料结构后的全链路优化:解析简化为结构化数据加载、问题解析简化为相似度阈值判断、检索简化为预计算矩阵运算、生成简化为动态上下文填充。工程成本并未消失,而是上移至语料范式设计、内容标准化、版本治理、阈值调优等前置环节。
两大可通用至全场景的核心设计思路:
答案缓存机制:所有存在固定标准答案、重复提问的场景,均可通过FAQ缓存逻辑,规避冗余大模型调用;
动态少样本检索:彻底替代静态提示词示例,实现提示词与知识库实时同步。
只要业务存在固定高频问答场景,就应保留FAQ结构化优势,切勿盲目套用通用RAG流水线,造成性能、成本、精准度的多重损耗。
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !



 京公网安备 11010802022788号






