


 发帖

 雷达卡



清华大学联合字节跳动智能创作实验室搞了个大动作DreamID-Omni,专门用来解决以人为中心的音视频生成可控性问题的统一框架。
这也解决了Sora、Ovi、LTX-2等视频模型非常头疼的多人对话大难题。

即将开源:https://github.com/Guoxu1233/DreamID-Omni
其实你看Sora或其他的知名开源模型,生成的视频确实越来越逼真。但只要一涉及到人,特别是多个人一起说话的场景,问题就来了。
比如你想生成两个人聊天的视频,经常会出现张冠李戴的情况,A的声音配到了B的嘴上,或者两个人的脸糊在一起。
这就很尴尬了,因为目前的模型大多是专机专用,生成视频的只管画面,做动画的只管动嘴,想要把它们统一起来,还得保证人不乱,太难了。
而这次DreamID-Omni的核心思想是,把参考式生成、视频编辑、还有音频驱动动画这三大任务,全都塞进了一个模型里。以前你需要三个不同的工具才能干完的活,现在这一个框架全包圆了。

DreamID-Omni的基础架构是基于双流扩散Transformer做的,简单说就是分了视频和音频两条并行的处理链路。
两条链路之间会通过双向交叉注意力做同步和对齐,保证生成的音视频能完美匹配,不会出现音画不同步的情况。
而这个框架最核心的创新,就是设计了对称条件扩散Transformer,能把参考图像、人物声音、原视频、驱动音频这些不同类型的控制信号。
全都整合到同一个特征空间里,不用改架构,就能在不同任务之间无缝切换,这一点真的太香了。
团队为视频和音频分别构建了专属的条件序列,把人物身份信息和内容结构信息融合在一起。
简单理解,就是把人物的脸和声音这些核心身份特征,跟含噪的视频、音频原始数据拼在一起,让模型能精准提取和保留这些身份信息。
同时把原视频、驱动音频这些结构信息,以加法的方式注入进去,作为内容的基础框架,保证生成的内容在空间和时间上的一致性。
这种设计就像是给模型搭了两个通道,一个专门管保留人物身份,一个专门管控制内容结构,两者互不干扰又能协同工作。
接下来说说我觉得这篇论文最牛的突破,就是解决多人生成时的混淆问题。大家如果试过AI换脸或者让AI生成多人对话,肯定遇到过这种崩溃时刻。
明明给的是A的声音,结果B的嘴在动,或者两张脸长得像双胞胎一样分不清。这就是所谓的身份-音色绑定失效。

研究团队为了治这个毛病,想了一招叫双层次解耦策略。咱们打个比方,信号层面上,他们发明了一种叫Syn-RoPE的技术。
这就好比在开会的时候,给每个人发了一个专属座位牌。不管你怎么移动位置,你的声音和你的脸永远被锁定在这个专属的座位上,别人的信号怎么也窜不过来,彻底杜绝了抢麦的情况。
而在语义层面上,他们搞了个结构化描述。以前咱们写提示词可能比较随意,比如写“两个人在聊天”。现在的AI可不吃这套,它容易晕。
这个新框架强制要求把提示词写得跟剧本似的,谁是主角、谁说了哪句台词、情绪怎么样,标注得清清楚楚。
这样模型就知道,这个专属代号的人,应该说这句词,那个专属代号的人,应该做那个动作。
这一套组合拳下来,多人生成那种乱成一锅粥的情况就再也不会出现了。
当然,要把这么多任务塞到一个模型里训练,也是个技术活。为了解决这个问题,团队设计了一个多任务渐进式训练方案。
简单来说,就是分步走。第一步先练好基本功,学会怎么根据参考生成内容,而且不能是死记硬背的复制粘贴。
第二步再加大难度,让它学会把人和声音分离开来。最后一步,才是把编辑、动画这些高难度的任务加进来。
这种先易后难、循序渐进的培养方式,既保证了模型能听懂人话,又保证了它能干细活。
在和当前最先进的模型对比测试中,DreamID-Omni的表现可以说是一骑绝尘。在参考式音视频生成任务里,不管是和Wan2.6这样的商业闭源模型比。
还是和Qwen-Image结合LTX-2、Ovi的级联管道比,亦或是和Phantom、VACE这些视频生成模型比,DreamID-Omni在各项核心指标上多数都是最优。
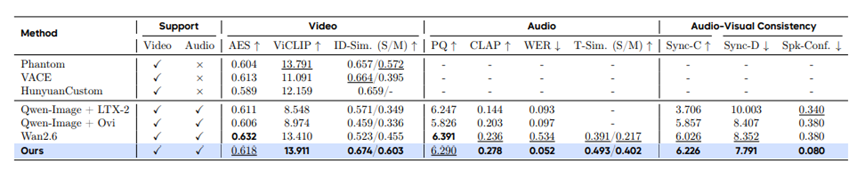
尤其是多人物场景的说话人混淆率只有0.08,远低于其他模型,而且是唯一一个能实现人物身份和声音精准绑定的模型。
在视频编辑任务里,对比VACE、HunyuanCustom这些SOTA模型,DreamID-Omni在视频相关的指标上全是最优。
还具备其他模型没有的音频生成能力,生成的音频不仅内容准确,还能和人物身份完美匹配,唇形同步度也很高。
除此之外,团队还邀请了30名专业的视频创作者做了盲态用户研究,从文本视频对齐、人物身份相似度、视频质量等七个维度给模型打分。
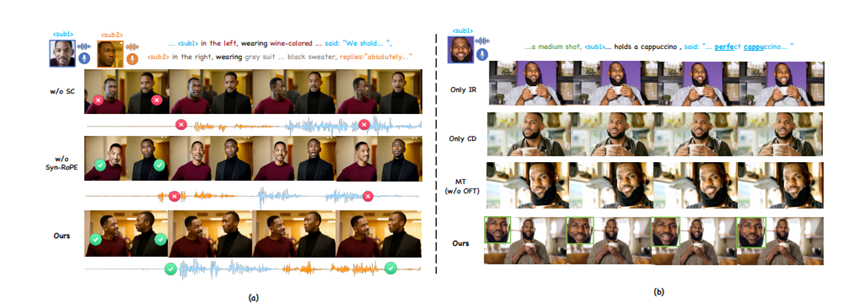
结果DreamID-Omni在所有维度都拿到了最高分,尤其是人物身份相似度、文本音频对齐、唇形同步这三个维度,优势特别明显。
专业创作者的评价其实最有说服力,这也证明了DreamID-Omni的生成结果在实际应用中具备极高的价值。
想转型AI,不被时代淘汰
CAIE注册人工智能工程师认证
岗位能力 × AI工具 ×转型方向 × 场景落地 = 新AI职业价值
扫码免费领取《AI工程师入门学习指南》

 京公网安备 11010802022788号






