


 发帖

 雷达卡



在上一篇文章《PDF 生产级 RAG 流水线:关系型解析、目录检索、结构化答案输出》中,我们完成了四大核心模块(文档解析、问题解析、检索、生成)的全面升级,搭建出简洁线性的端到端流水线:输入 PDF 文档,输出结构化、带溯源举证的标准化答案。此前验证仅基于单篇文档、单个问题,而真正的落地考验是:零代码改动的前提下,这套流水线能否适配各类风格迥异的真实文档。
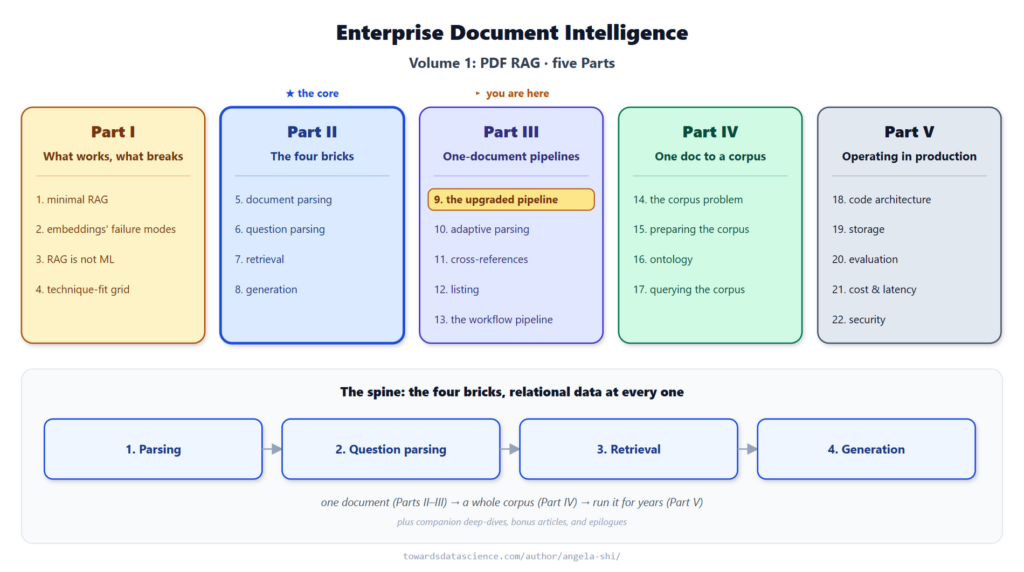
本文将聚焦这一核心验证:使用同一套未改动的流水线,对四类差异化极强的 PDF 文档进行压力测试——学术论文、NIST 官方标准、经典 RAG 论文、目录结构损坏的行业报告,全面验证流水线的通用性、稳定性与容错能力。
本文是《企业文档智能》系列第三部分「升级流水线」的第二篇配套文章。系列第三部分第一篇文章《逐模块升级基线 RAG》已完成四大模块的独立迭代优化,本文将所有升级后的模块整合为单次统一模型调用,基于真实业务文档完成全链路实战验证。
配套可运行代码笔记已开源至 GitHub:doc-intel/notebooks-vol1。代码支持单次调用批量处理四份测试文档,逐份输出结构化答案与全模块审计日志,同时支持自定义上传 PDF,零改动复用整套流水线能力(PDF 问答核心逻辑)。
开源配套代码仓库:doc-intel/notebooks-vol1
此前分模块升级核心能力:文档解析输出带目录的关系型结构化数据与文档全局摘要;问题解析将杂乱的用户自然语言输入转化为标准化结构化查询指令;检索模块依托轻量大模型解析文档原生目录,融合目录检索与关键词检索结果;生成模块输出结构化答案,每条结论附带可溯源文本片段与四项上下文质量评估指标。四大模块独立迭代优化完成后,需整合为统一整体,实现工程化落地。
本文将所有模块封装为统一函数,通过单次模型调用完成全链路处理,输入 PDF 与问题,即可输出结构化答案+从问题解析到溯源举证的完整审计轨迹。模块联动后衍生出两大专属辅助链路:支撑双大模型模块运行的文档全局摘要链路、从生成模块反向回流至检索模块的反馈调优链路。
本次测试固定沿用公开的15页 arXiv 经典论文《Attention Is All You Need》,搭配含两处拼写错误的固定问题「位置编码有哪些实现方式?」作为基准用例。同时新增三份差异化测试文档,针对性考验不同模块性能:NIST 网络安全2.0标准文档、RAG 开山经典论文、原生目录结构损坏的《2024年4月世界银行大宗商品市场展望报告》(文末附所有文档来源与开源协议)。
一、全链路生产级流水线架构解析
系列第1期「极简基线 RAG」的架构图仅展示了四大模块的线性串联结构,仅适用于入门介绍,无法体现升级后生产级流水线的核心链路能力。本文架构新增两条工业级专属辅助链路,完整还原生产代码运行逻辑。
四大模块封装为统一 pdf_qa 调用、双辅助链路:文档摘要供给链路、检索反向反馈链路
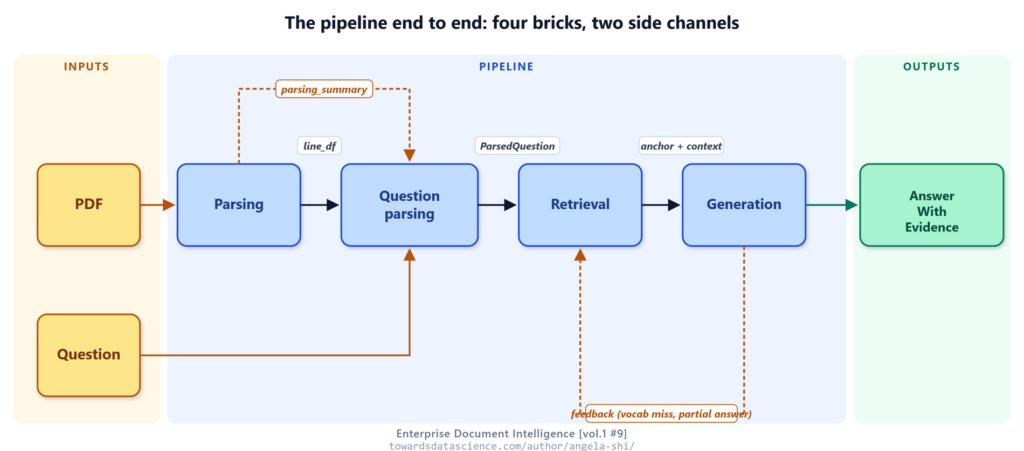
分三层读懂整套架构:
第一层为核心主线四大模块,沿用系列经典架构名称,模块间通过Pydantic 结构化范式契约传递数据(解析输出行数据、问题解析输出结构化查询、检索输出锚点上下文),而非原始字典数据。四大模块完全解耦,无相互导入依赖,独立性极强。
第一条辅助链路:文档全局摘要供给问题解析模块。基线 RAG 中,问题解析仅能读取用户原始问题文本;升级后,问题解析模块可获取解析模块输出的文档级结构化摘要(文档类型、总页数、核心字段、全局概述)。
相同问题「名称是什么?」,针对简历文档与200页企业年报的解析逻辑完全不同。该链路通过 PromptContext 上下文聚合器嵌入模型调用的用户内容层实现,无需改动模块接口,接口签名全程稳定,可自适应不同文档类型。
第二条辅助链路:生成模块反向反馈回路。模型单次生成未必能完整作答,会输出两类核心反馈信号:「检索上下文仅覆盖部分答案」「用户提问术语与文档表述存在偏差(如用户提问抵扣、文档表述超额)」。
调度器捕获反馈信号后,自动反向优化上游模块:多数场景下拓展检索关键词、补充检索范围,复杂场景下重构用户查询指令。系列第13期「工作流流水线」将详解迭代循环逻辑,本文仅采用单次正向调用模式,适配短论文、合规文档等简单场景的核心需求。
四大模块的独立开发、详细代码、迭代逻辑均对应系列专属文章,本文仅展示模块整合联动逻辑,不重复赘述单模块源码:
文档解析:第5A期(PDF核心有效信息筛选)、第5B期(关系型数据模型搭建)
问题解析:第6A期(核心原理)、第6B期(信息提取规则)、第6C期(任务分发逻辑)
检索模块:第7A期(检索即筛选核心思想)、第7B期(锚点检测机制)、第7C期(大模型仲裁筛选)
生成模块:答案契约范式、提示词组装、结果校验(第8A-8C期,后续更新链接)
此前文章逐模块独立运行测试,生产级工程代码则将所有模块封装为统一调用函数 pdf_qa,函数命名直观体现能力与适配对象:专注 PDF 文档问答。同系列可拓展衍生 Excel 问答、PDF 翻译、双文档对比等通用能力,四大模块作为核心插件即插即用,其余逻辑为通用工程调度链路。
def pdf_qa(pdf_path, question, *, client=None, expert_dict=None,
           context: PromptContext | None = None):
    # 模块1:文档解析,输出结构化行数据、页面数据、目录数据、文档摘要
    parsed_pdf = parse_pdf(pdf_path, method="fitz")
    line_df, page_df, toc_df = parsed_pdf["line_df"], parsed_pdf["page_df"], parsed_pdf["toc_df"]
    parsing_summary = parsed_pdf["parsing_summary"]

    # 封装文档上下文,供给双大模型模块调用
    pipeline_ctx = (context or PromptContext()).with_doc_context(
        DocContext.from_parsing_summary(parsing_summary)
    )

    # 模块2:问题解析,模型纠错+信息提取+关键词拓展
    parsed = parse_question(question, client=client, context=pipeline_ctx)
    keywords = expand_with_expert(parsed.keywords, expert_dict or {})
    shape = infer_answer_shape(question)

    # 模块3:检索融合策略:关键词页面筛选 + 大模型目录路由筛选
    kw_pages, _ = retrieve_pages(page_df, line_df, keywords, top_k=3)
    selection = reason_on_toc(question, toc_df, client=client)
    toc_pages = expand_sections_to_pages(toc_df, selection.section_ids)
    pages = sorted(set(kw_pages['page_num']) | toc_pages)
    filtered = line_df[line_df['page_num'].isin(pages)]

    # 模块4:生成答案,根据输出范式匹配结构化模型,绑定溯源上下文
    schema = ListAnswer if shape == 'listing' else AnswerWithEvidence
    answer = llm_answer_with_evidence(question, filtered, client=client,
                                     context=pipeline_ctx)
    return answer, {'pages': pages, 'keywords': keywords,
                    'toc_selection': selection.model_dump()}
上述为精简版函数,生产环境完整版包含更多可配置参数,兼顾灵活性与通用性:
store:模块级缓存配置
method:解析引擎选型
top_k:检索候选范围配置
use_toc:目录失效时自动关闭大模型目录路由
include_bbox:布局敏感场景坐标适配
所有参数默认值兼容精简版核心逻辑,检索底层复用统一工具函数,保障单文档问答与跨文档批量问答的目录路由逻辑完全一致,避免逻辑割裂。
1.1 基准测试用例:《Attention Is All You Need》论文全链路执行日志
模块1 文档解析:输入论文PDF路径,输出标准化 line_df、page_df、toc_df 结构化数据表与文档摘要。
模块2 问题解析:输入含拼写错误的原始问题,输出标准化结构化解析结果:
{
  "in": {
    "raw_question": "What are the optoins for posiitional encoding?"
  },
  "out": {
    "raw_keywords": ["posiitional encoding"],
    "corrected_keywords": ["positional encoding"],
    "expert_keywords_added": ["sinusoidal", "learned"],
    "final_keywords": ["positional encoding", "sinusoidal", "learned"],
    "expected_answer_shape": "listing"
  }
}
模块3 检索模块:输入最终关键词、页面数据、目录数据,输出检索状态与融合筛选结果:
{
  "in": {
    "final_keywords": ["positional encoding", "sinusoidal", "learned"],
    "scope": "page_df + toc_df"
  },
  "out": {
    "keyword_candidates": [
      {"page": 6, "matched_keywords": ["positional encoding", "sinusoidal", "learned"], "match_count": 3},
      {"page": 9, "matched_keywords": ["positional encoding", "sinusoidal", "learned"], "match_count": 3},
      {"page": 4, "matched_keywords": ["learned"], "match_count": 1}
    ],
    "toc_routing": {
      "section_ids": ["10"],
      "reasoning": "Section 10, 'Positional Encoding', explicitly focuses on…",
      "selected_sections": [
        {"section_id": "10", "title": "Positional Encoding", "start_page": 6, "end_page": 6}
      ]
    },
    "merged_pages": [4, 6, 9]
  }
}
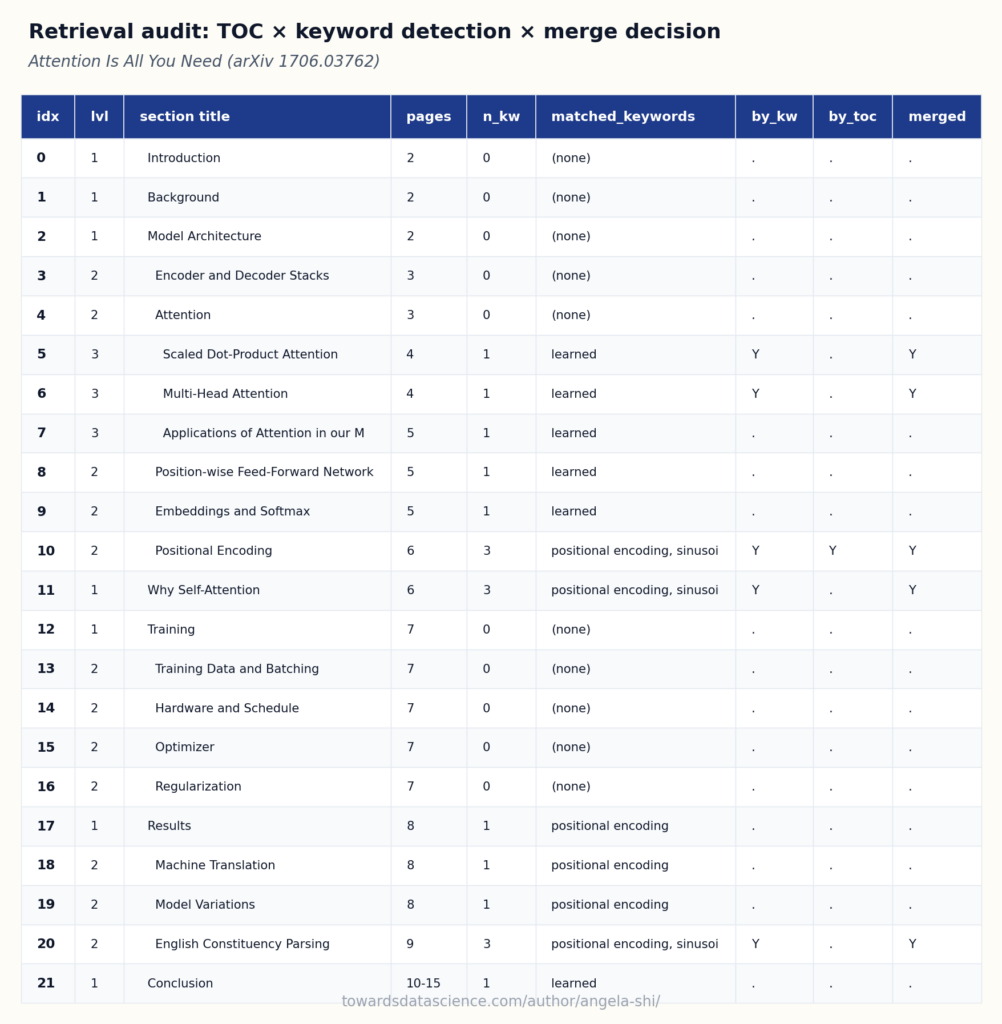
检索模块采用确定性合并策略,融合关键词匹配页面与目录路由筛选页面。逐段审计日志可完整还原筛选逻辑,精准定位每一个入选章节的匹配依据,全程可追溯、可复现。
章节级审计:关键词筛选、目录筛选双维度校验,明确各章节入选状态
模块4 生成模块:输入原始问题、合并筛选页面、过滤后文本行数据,输出带精准溯源的结构化列表答案,附带四项上下文质量指标:
{
  "in": {
    "question": "What are the optoins for posiitional encoding?",
    "merged_pages": [4, 6, 9],
    "filtered_line_df": "256 rows"
  },
  "out": {
    "items": [
      {"text": "Sinusoidal positional encodings", "start_page_num": 6, "start_line_num": 33, "end_page_num": 6, "end_line_num": 35, "quote": "PE(pos,2i) = sin(pos/100002i/dmodel)\nPE(pos,2i+1) = cos(po…"},
      {"text": "Learned positional embeddings", "start_page_num": 6, "start_line_num": 41, "end_page_num": 6, "end_line_num": 41, "quote": "We also experimented with using learned positional embeddin…"},
      {"text": "positional embedding instead of sinusoids", "start_page_num": 9, "start_line_num": 111, "end_page_num": 9, "end_line_num": 111, "quote": "positional embedding instead of sinusoids"}
    ],
    "answer_found": true,
    "complete_answer_found": true,
    "context_completeness": 1.0,
    "context_structured": true,
    "confidence": 1.0,
    "caveats": []
  }
}
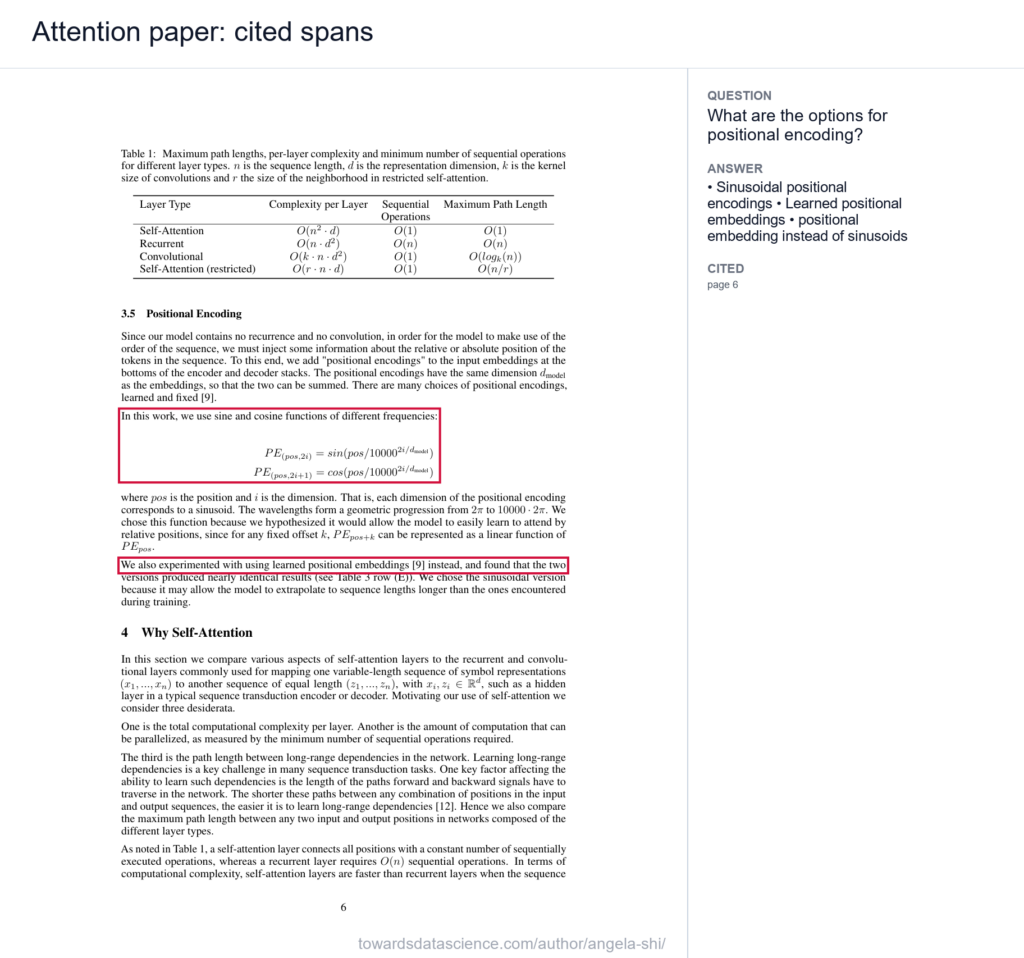
所有溯源行号、页码均对应PDF真实位置,工具可自动在原文中标记对应文本区块,直观匹配答案与原文依据。
左侧原文溯源页面、右侧问题与结构化答案展示
整套流程仅20行核心Python代码、4次模型调用(问题解析2次、生成2次,其余模块无模型调用)。完整溯源日志可复刻每一步执行逻辑,无需重跑流水线即可完成全流程审计复盘。
上述基准用例为结构规整的学术论文,接下来零代码改动复用同一流水线,完成三类复杂文档的压力测试:合规标准文档、经典技术论文、目录损坏的异常文档。
二、场景一:海量匹配结果中的精准答案定位(NIST 标准文档)
测试文档为32页《NIST 网络安全框架 2.0》,原生目录完整、单栏标准排版,是企业合规检索的典型文档类型。本次问题为单一定义类问题(非列表类),问题解析模块自动识别输出范式为「单条精准答案」,流水线自动切换对应生成模型范式,核心调度逻辑不变,仅输出结构化范式自适应调整。列表类问题将在系列第12期详解,本文聚焦单答案分支的落地效果。
模块1 文档解析:输入NIST标准PDF,输出完整 line_df、page_df、toc_df 结构化数据。
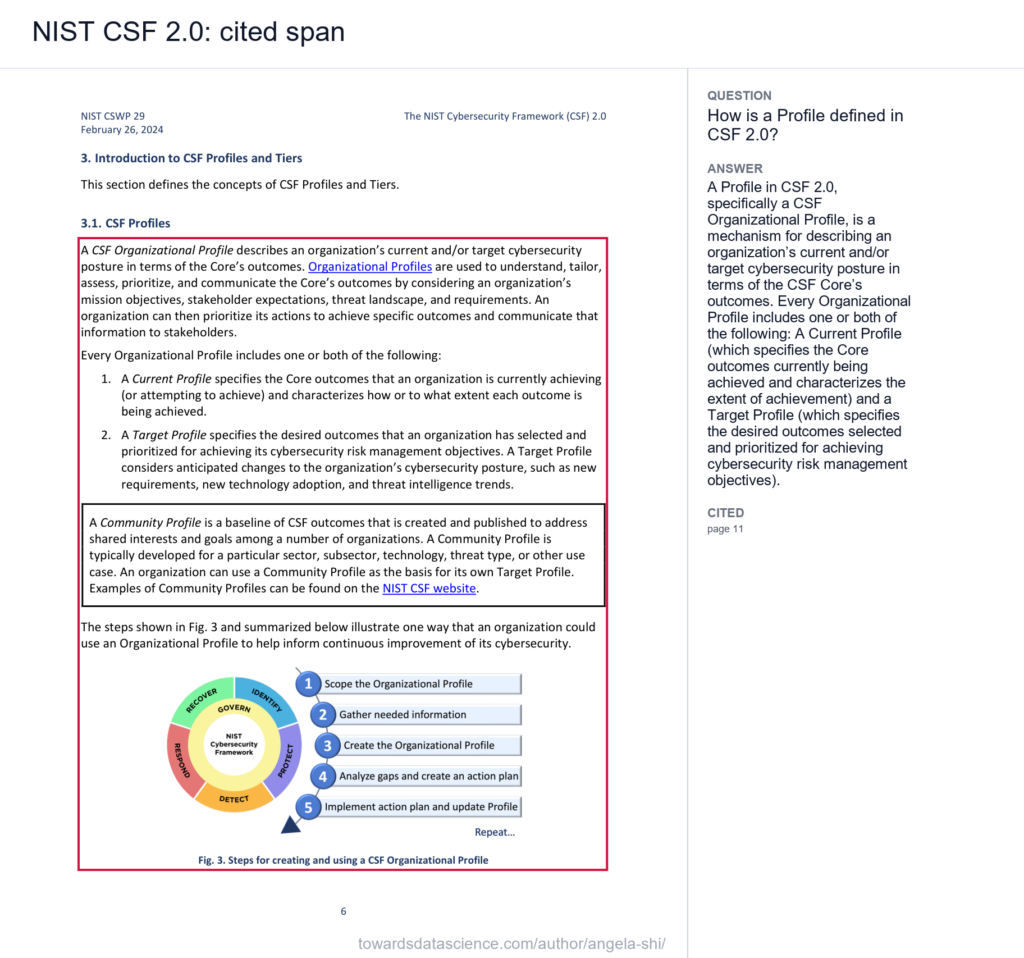
模块2 问题解析:输入问题「CSF 2.0 如何定义 Profile(配置文件)?」,输出标准化解析结果:
{
  "in": {
    "raw_question": "How is a Profile defined in CSF 2.0?"
  },
  "out": {
    "raw_keywords": ["Profile", "CSF 2.0"],
    "corrected_keywords": ["Profile", "CSF 2.0"],
    "expert_keywords_added": [],
    "final_keywords": ["Profile", "CSF 2.0"],
    "expected_answer_shape": "single"
  }
}
模块3 检索模块:双策略融合检索,精准筛选定义所在页面:
{
  "in": {
    "final_keywords": ["Profile", "CSF 2.0"],
    "scope": "page_df + toc_df"
  },
  "out": {
    "keyword_candidates": [
      {"page": 2, "matched_keywords": ["Profile", "CSF 2.0"], "match_count": 2},
      {"page": 5, "matched_keywords": ["Profile", "CSF 2.0"], "match_count": 2},
      {"page": 4, "matched_keywords": ["Profile"], "match_count": 1}
    ],
    "toc_routing": {
      "section_ids": ["3", "2", "11"],
      "reasoning": "Section 3.1 (CSF Profiles) directly addresses the definit…",
      "selected_sections": [
        {"section_id": "2", "title": "3. Introduction to CSF Profiles and Tiers", "start_page": 11, "end_page": 14},
        {"section_id": "3", "title": "3.1. CSF Profiles", "start_page": 11, "end_page": 12},
        {"section_id": "11", "title": "Appendix C. Glossary", "start_page": 31, "end_page": 32}
      ]
    },
    "merged_pages": [2, 4, 5, 11, 12, 13, 14, 31, 32]
  }
}
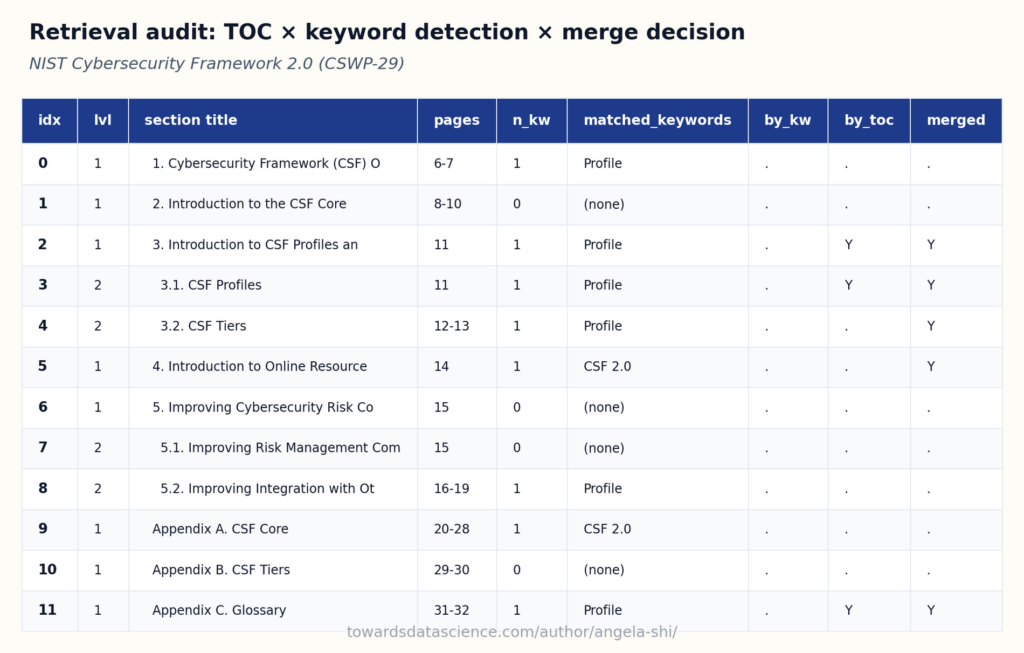
目录级审计日志清晰展示:关键词匹配海量相关页面,目录路由精准锁定核心定义章节,融合后兼顾覆盖率与精准度。
双检索信号协同生效:目录定位核心章节,关键词补充周边关联页面
模块4 生成模块:输出带精准溯源的单条结构化答案,四项质量指标全部达标:
{
  "in": {
    "question": "How is a Profile defined in CSF 2.0?",
    "merged_pages": [2, 4, 5, 11, 12, 13, 14, 31, 32],
    "filtered_line_df": "280 rows"
  },
  "out": {
    "answer": "A Profile in CSF 2.0, specifically a CSF Organizational Pro…",
    "start_page_num": 11,
    "start_line_num": 8,
    "end_page_num": 12,
    "end_line_num": 20,
    "confidence": 1.0,
    "justification": "Lines 11:8-12:20 provide a detailed definition of CSF P…",
    "quotes": [
      "A CSF Organizational Profile describes an organization's cu…",
      "Every Organizational Profile includes one or both of the fo…",
      "A Community Profile is a baseline of CSF outcomes that is c…"
    ],
    "caveats": [],
    "complete_answer_found": true,
    "context_structured": true,
    "llm_discovered_keywords": ["Organizational Profile", "Current Profile", "Target Profile", "Community Profile"]
  }
}
自动标记原文定义区块,答案精准匹配权威释义,无冗余、无遗漏。该问题无列表类触发词,流水线自动适配单答案输出范式,无需人工修改代码分支,自适应能力极强。
溯源区块精准定位定义原文,右侧展示问答结果
三、场景二:跨多章节的复合型答案生成(经典 RAG 论文)
测试文档为2020年 RAG 开山论文《Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks》,全文18页、目录完整,中段包含大量实验结果表格。本次问题聚焦 RAG 核心架构原理,答案分散在多个章节,考验流水线的跨章节上下文融合能力。
模块1 文档解析:输入RAG原始论文PDF,输出完整结构化数据表。
模块2 问题解析:输入问题「RAG 如何融合检索与生成模块?」,识别为单答案复合型问题:
{
  "in": {
    "raw_question": "How does RAG combine retrieval and generation?"
  },
  "out": {
    "raw_keywords": ["RAG", "retrieval", "generation"],
    "corrected_keywords": ["RAG", "retrieval", "generation"],
    "expert_keywords_added": [],
    "final_keywords": ["RAG", "retrieval", "generation"],
    "expected_answer_shape": "single"
  }
}
模块3 检索模块:关键词全局匹配+目录章节定位,覆盖架构核心章节:
{
  "in": {
    "final_keywords": ["RAG", "retrieval", "generation"],
    "scope": "page_df + toc_df"
  },
  "out": {
    "keyword_candidates": [
      {"page": 1, "matched_keywords": ["RAG", "retrieval", "generation"], "match_count": 3},
      {"page": 2, "matched_keywords": ["RAG", "retrieval", "generation"], "match_count": 3},
      {"page": 3, "matched_keywords": ["RAG", "retrieval", "generation"], "match_count": 3}
    ],
    "toc_routing": {
      "section_ids": ["2", "3", "4"],
      "reasoning": "Section 2.1 Models likely explains the overall architectu…",
      "selected_sections": [
        {"section_id": "2", "title": "2.1 Models", "start_page": 3, "end_page": 3},
        {"section_id": "3", "title": "2.2 Retriever: DPR", "start_page": 3, "end_page": 3},
        {"section_id": "4", "title": "2.3 Generator: BART", "start_page": 3, "end_page": 3}
      ]
    },
    "merged_pages": [1, 2, 3]
  }
}
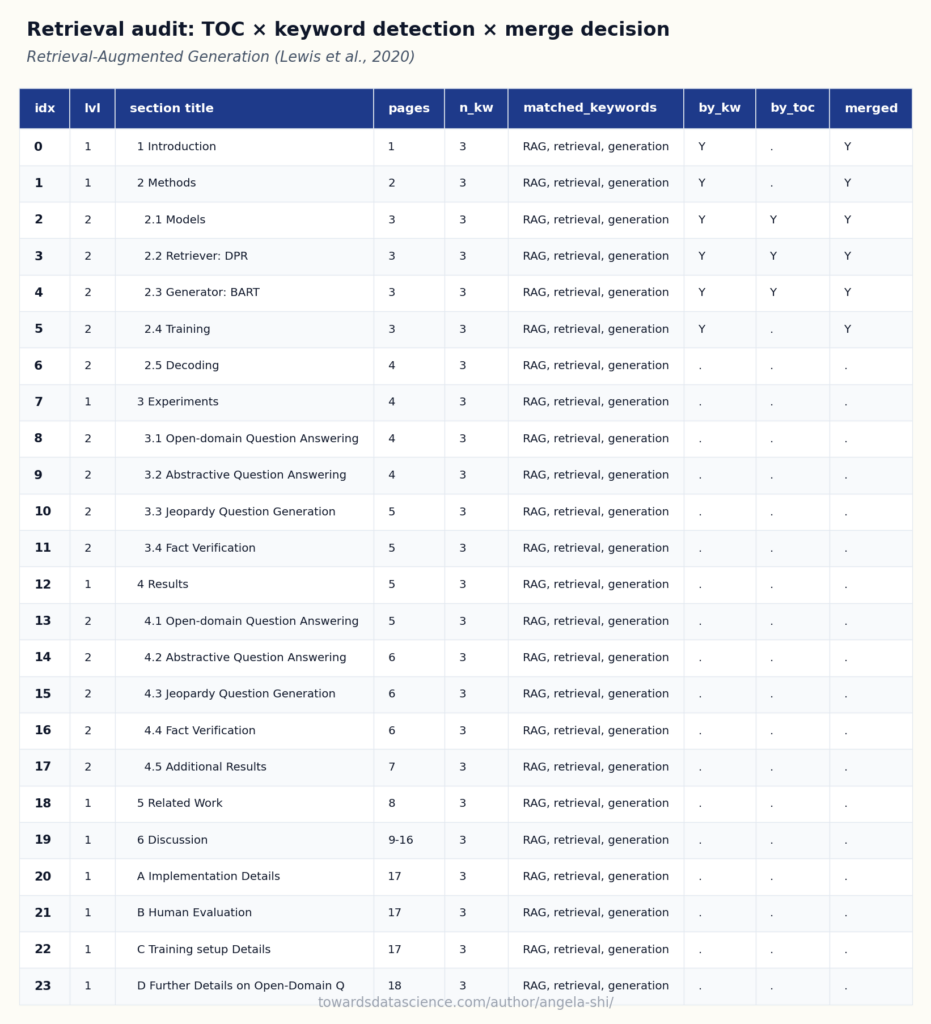
该文档目录标题无完整复合关键词,关键词检索承担核心筛选作用,目录检索辅助锁定核心架构章节,精准覆盖模型、检索器、生成器三大核心模块。
关键词主导筛选、目录辅助定位核心章节
模块4 生成模块:融合多章节上下文,输出完整架构解析答案,诚实标注信息边界:
{
  "in": {
    "question": "How does RAG combine retrieval and generation?",
    "merged_pages": [1, 2, 3],
    "filtered_line_df": "200 rows"
  },
  "out": {
    "answer": "RAG combines retrieval and generation by using a pre-traine…",
    "start_page_num": 2,
    "start_line_num": 46,
    "end_page_num": 3,
    "end_line_num": 40,
    "confidence": 0.98,
    "justification": "Lines 2:46 to 3:40 describe the mechanism: the retrieve…",
    "quotes": [
      "Figure 1: Overview of our approach. We combine a pre-traine…",
      "The retrieval component pη(z|x) is based on DPR ... Calcula…",
      "The generator component pθ(yi|x, z, y1:i-1) could be modell…",
      "RAG-Sequence Model ... the model uses the same document to…",
      "In the RAG-Token model we can draw a different latent docum…"
    ],
    "caveats": [
      "The detailed algorithmic steps (e.g., training or more adva…"
    ],
    "complete_answer_found": true,
    "context_structured": true,
    "llm_discovered_keywords": ["retriever", "generator", "marginalize", "latent document", "seq2seq", "DPR", "BART", "Maximum Inner Product Search", "RAG-Sequence", "RAG-Token"]
  }
}
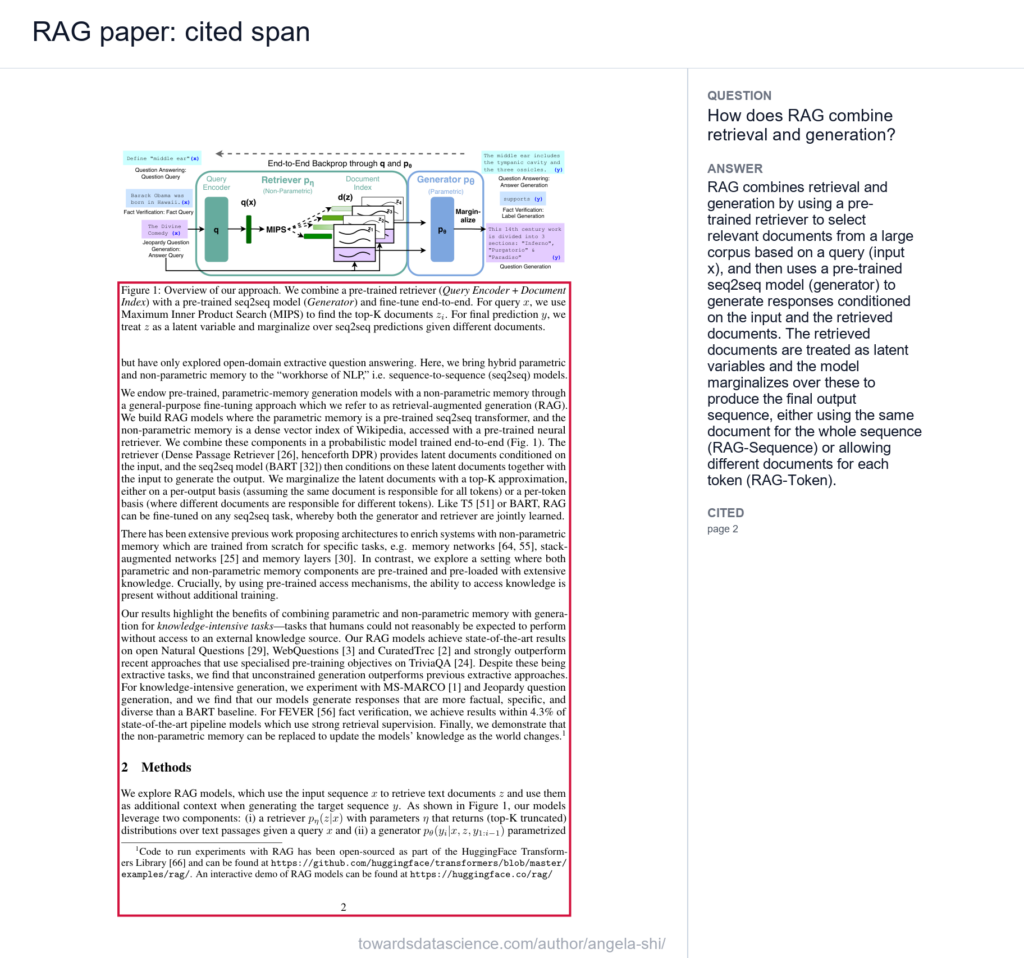
流水线自动融合跨章节上下文,精准提炼 RAG 架构耦合逻辑,同时诚实标注「未覆盖详细算法步骤」的信息边界,无幻觉、无过度推断。
跨章节溯源区块精准覆盖核心架构原理
四、场景三:目录损坏文档的容错能力测试(世界银行展望报告)
本次为极限压力测试:2024年4月世界银行大宗商品市场展望报告,PDF 原生目录存在结构性损坏,所有章节标题均显示为「空白页面」,目录无任何有效语义信息,完全考验流水线的降级容错能力。
模块1 文档解析:解析输出常规行数据、页面数据,但 toc_df 完全失效,所有章节标题为空,属于典型的解析降级场景。
模块2 问题解析:输入问题「2024年能源价格市场展望如何?」,输出标准化单答案检索指令:
{
  "in": {
    "raw_question": "What is the energy price outlook for 2024?"
  },
  "out": {
    "raw_keywords": ["energy price", "2024"],
    "corrected_keywords": ["energy price", "2024"],
    "expert_keywords_added": [],
    "final_keywords": ["energy price outlook", "2024"],
    "expected_answer_shape": "single"
  }
}
模块3 检索模块:目录路由完全失效,流水线自动降级为纯关键词检索:
{
  "in": {
    "final_keywords": ["energy price outlook", "2024"],
    "scope": "page_df + toc_df"
  },
  "out": {
    "keyword_candidates": [
      {"page": 1, "matched_keywords": ["2024"], "match_count": 1},
      {"page": 3, "matched_keywords": ["2024"], "match_count": 1},
      {"page": 4, "matched_keywords": ["2024"], "match_count": 1}
    ],
    "toc_routing": {
      "section_ids": [],
      "reasoning": "None of the sections listed in the table of contents prov…",
      "selected_sections": []
    },
    "merged_pages": [1, 3, 4]
  }
}
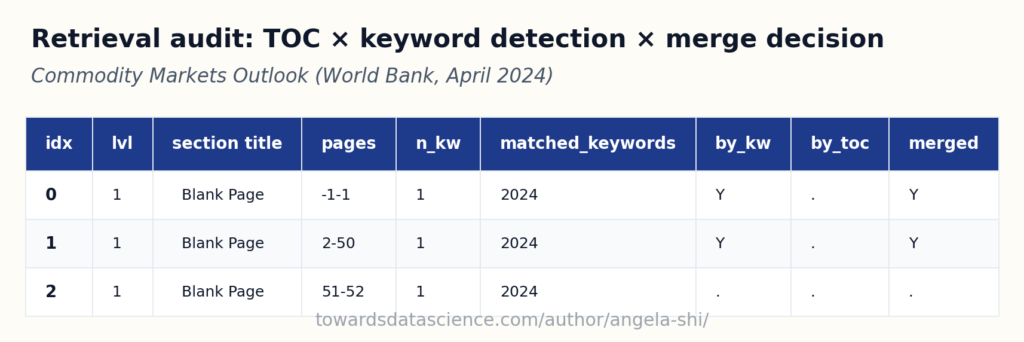
审计日志直观暴露目录损坏问题,无任何有效章节筛选结果,流水线无损触发降级策略。
所有章节目录匹配为空,审计日志实时暴露文档结构异常
模块4 生成模块:基于无效上下文,诚实返回无结果,拒绝幻觉生成:
{
  "in": {
    "question": "What is the energy price outlook for 2024?",
    "merged_pages": [1, 3, 4],
    "filtered_line_df": "47 rows"
  },
  "out": {
    "answer": "NA",
    "start_page_num": null,
    "start_line_num": null,
    "end_page_num": null,
    "end_line_num": null,
    "confidence": 0.0,
    "justification": "None of the provided lines discuss the energy price out…",
    "quotes": [],
    "caveats": [
      "No substantive content from the Commodity Markets Outlook r…"
    ],
    "complete_answer_found": false,
    "context_structured": true,
    "llm_discovered_keywords": ["Commodity Markets Outlook", "data cutoff date", "license"]
  }
}
本次结果并非流水线 Bug,而是核心能力体现:当检索上下文无有效答案信息时,流水线主动放弃作答、诚实返回无结果,坚决杜绝大模型幻觉。
传统简易 RAG 会基于首页无效文本强行生成看似合理的虚假预测结果,而本流水线可精准识别上下文缺失问题。该场景的根治方案在上系列第10期「自适应解析」:当原生目录损坏时,通过正文内容重构有效目录,修复检索失效问题。
四类文档完整测试结论:两套输出范式全覆盖(列表型、单条型),三种正常作答场景、一种诚实拒答场景。零代码改动、零架构调整,仅自适应调整生成层 Pydantic 结构化范式,全程可审计、可追溯、无幻觉。同时可通过四大质量指标精准定位故障类型:目录失效、文本乱码、无匹配内容等。
五、传统简易 RAG 与生产级结构化 RAG 的核心差距
为验证流水线优势,我们基于基线简易 RAG(关键词/向量匹配、Top-K 筛选、直接生成)与本文升级流水线,在相同文档、相同问题下做对照测试,差距集中体现在复杂标准文档场景,简单规整论文两类流水线均可正常作答。
简易 RAG 在复杂合规文档中的典型缺陷:
NIST 配置文件定义问题:仅匹配高频关键词页面,无法定位核心定义段落,返回低置信度无结果;
NIST 安全控制目录问题:检索无效内容,完全无法作答;
零信任架构问题:仅召回部分结论,高置信度输出不完整答案,形成隐性幻觉;
信息安全等级标准问题:仅覆盖部分评级定义,刻意补全缺失信息,产生虚假内容。
本流水线通过目录路由+关键词融合检索、结构化上下文约束、答案溯源绑定,所有场景均输出完整、精准、可举证的答案,无缺失、无幻觉。
简易 RAG 的本质是概率匹配,仅能应对简单短文档、关键词高度匹配的场景。一旦文档篇幅变长、问题与文档术语存在偏差,有效答案会被海量无效上下文淹没。此时简易 RAG 只会出现两种结果:低置信度如实返回无结果,或基于错误上下文高置信度编造答案——这也是工业界绝大多数 RAG 幻觉问题的根源。
绝大多数 RAG 幻觉并非模型凭空编造,而是检索失效导致上下文错误,模型忠实解读错误上下文。系列第7增刊将详细论证:RAG 幻觉90%以上为检索层故障,而非生成层问题。本文通过全链路实测,完整复现并解决了这一核心痛点。
这也印证了核心设计理念:整套四大模块架构属于上下文工程体系,而非简单的检索调优。解析模块保留文档结构、问题解析拓宽语义边界、检索模块基于文档全局拓扑定位内容、生成模块绑定溯源约束答案。从源头精准构建有效上下文,彻底杜绝虚假高置信度答案,远超传统提示词调优的优化上限。
六、四大模块解耦设计的工程价值
本次四类文档零代码适配的核心底气,源于模块完全解耦、结构化契约通信的设计思想。各模块职责单一、输出标准化,输入文档变化仅改变流转数据,不改动模块核心逻辑。
模块间严格遵循结构化契约:
解析模块:输出固定范式的关系型数据表;
问题解析模块:输出纠错、拓展、输出范式预判的结构化查询指令;
检索模块:输出统一的筛选页面集合与审计日志;
生成模块:输出自适应范式的 Pydantic 结构化答案与质量指标。
所有中间结果均可序列化、可视化、可复盘,为迭代升级提供极致便利。系列四次核心模块升级,均实现单模块迭代、零跨模块改动:
解析模块新增目录数据表:其余模块无改动,检索模块自动适配新数据;
问题解析新增纠错与专家关键词拓展:仅优化自身输出,下游无感适配;
检索模块新增目录路由策略:输出结构不变,生成模块无需改动;
生成模块新增四项质量指标:输出范式拓展,调用方按需读取。
该架构范式可通用至所有复杂 AI 任务:系统难以迭代、组件耦合严重的核心原因,均为中间输出无结构化定义、无统一契约。结构化解耦设计虽增加前期设计成本,但可实现后续无痛迭代、独立优化、故障精准定位,是生产级 AI 系统的核心工程准则。
七、结语
本文沿用系列第1期基线论文与基准问题,基于四大模块升级能力,搭建出契约化、可组合、可审计的生产级 RAG 流水线。解析与检索输出结构化数据表,问题解析与生成输出标准化 Pydantic 模型,团队可逐模块迭代升级、互不干扰,审计人员可通过溯源日志完整复现每一步执行逻辑。
本流水线为五级迭代架构的第二阶段,后续将基于本文能力,新增反馈迭代循环机制(作者配图)
本文流水线默认依赖解析模块输出的有效目录结构,系列第10期「自适应解析」将进一步优化边界场景:针对扫描无 OCR、目录损坏、布局异常的文档,实现「轻量化优先解析、复杂场景深度解析、检索失效智能兜底」的全容错能力。
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802022788号






