


 发帖

 雷达卡



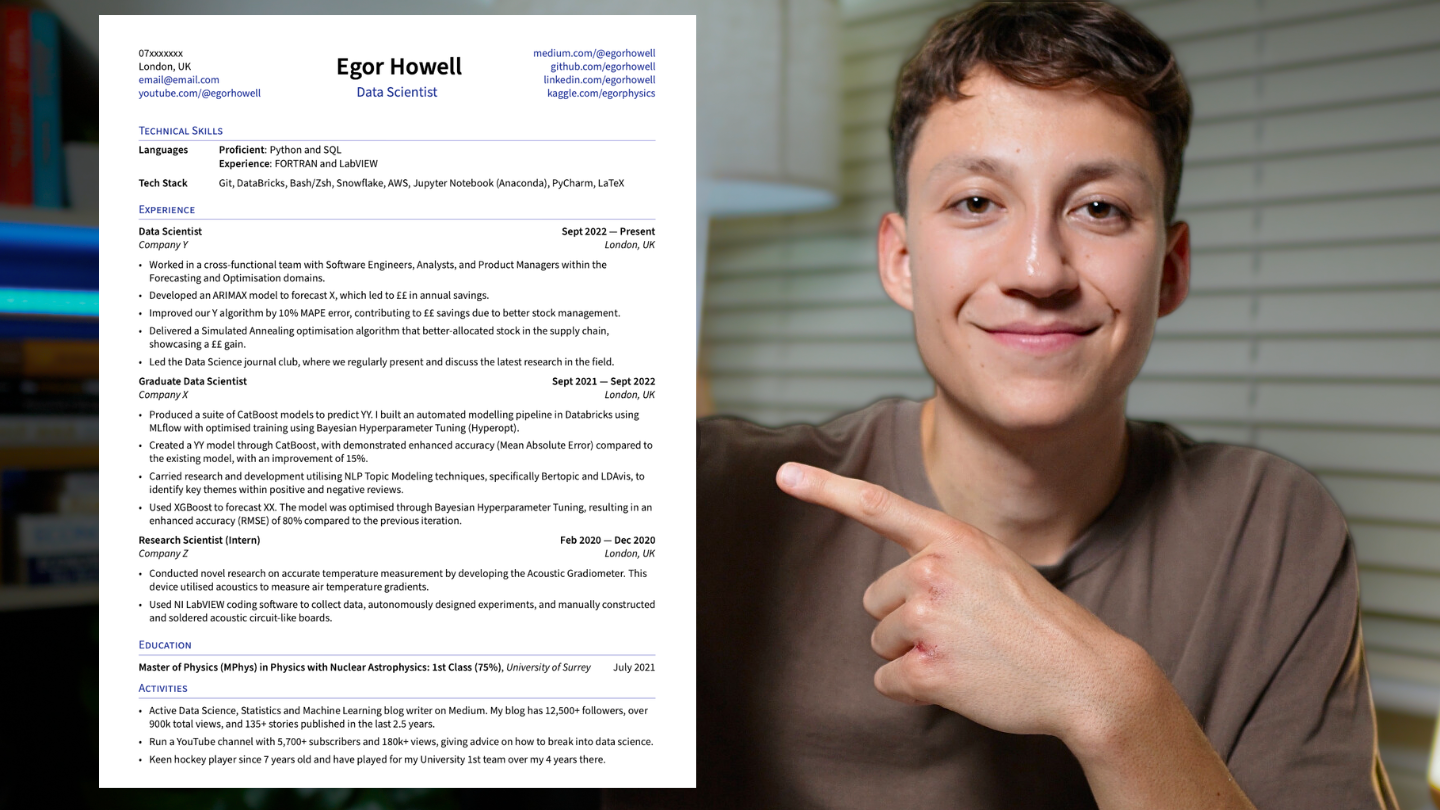
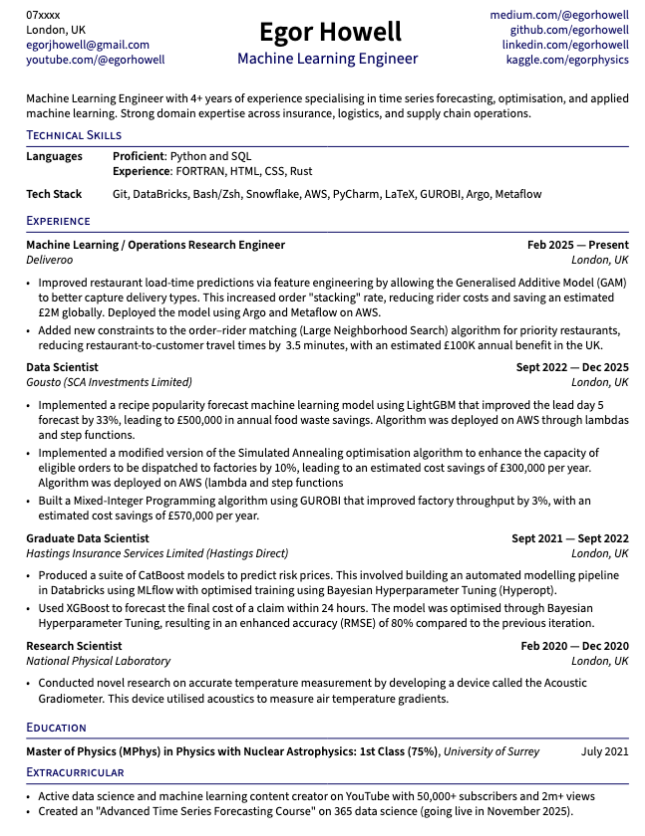
在本文中,我将完整拆解自己的实操方法:如何借助 Claude 打磨简历,最终拿到年薪超20万美元的机器学习工程师Offer。
话不多说,我们直接进入正题!
简历核心思维
简历是职业生涯中最重要的一份文书。我当初花了10多个小时打磨自己的简历,耗时虽久,但这正是我能拿到高薪Offer的核心原因。
我经常对我的求职学员说一句话:
简历是一门艺术,而非一套刻板公式
这不是故作高深,而是想告诉大家:不存在一套万能、标准、适配所有场景的简历模板与规则。
我会在本文中分享优质简历的通用原则与核心准则,教大家如何借助 Claude 最大化优化简历质量。
但真正的顶级简历,一定是精准适配目标岗位的专属简历。
岗位定制化打磨是求职通关的终极捷径,而实现高效定制的最好方法,就是先制作一份「全能主简历」,收录你所有的经历、技能与项目。
制作主简历时,无需纠结篇幅长短、项目 bullet 数量、技术栈罗列多少,做到全面收录即可。
后续投递不同岗位时,只需对照岗位描述,删除无关、冗余信息,快速生成专属定制简历。
做减法远比做加法简单,这也是最高效的简历定制方式,适配每一次求职投递。
简历基础核心框架
在让 Claude 优化简历之前,你必须先搭建扎实的基础框架。
需要先梳理好清晰的板块结构与原始内容,让AI能够精准捕捉你的个人风格、工作成果与整体调性,优化效果才会出彩。
我曾尝试直接让 Claude 从零生成简历,效果极差。AI无法凭空塑造你的个人履历,必须输入你的真实技术能力、工作经历、教育背景,才能生成合格内容。
结合我的实操经验,最高效的方式是:先用简洁模板完成初稿,再借助 Claude 打磨优化为顶尖水准简历。
下面我逐板块拆解,告诉你每一部分需要精准填充的核心内容。
排版与设计
很多人过度复杂化简历设计。优质简历的核心特质:简洁、干净、适度朴素。
无需花哨格式、配色装饰,绝对不要使用多栏排版。
全程使用黑色字体、统一易读的字体样式、标准项目符号即可。
如果你需要一套经过实战验证、帮我和学员拿下无数20万+年薪Offer的简历模板,可以查看下方链接:
复刻我拿下高薪数据科学、机器学习岗位Offer的同款简历模板
简历核心结构
简历结构无需一成不变,需根据目标岗位灵活调整。核心原则:将最能体现岗位适配度的核心信息,放在页面上三分之一的黄金视觉区。
绝大多数技术岗位,通用最优结构如下:
1. 个人头部信息
2. 个人简介
3. 技术技能
4. 工作经历
5. 项目经历
6. 教育背景
多数场景下,仅需前四个板块即可支撑优质简历。
个人头部信息
仅需包含以下内容,简洁精准:
- 姓名
- 岗位头衔(不确定就写数据科学家,切勿写「求职中」「意向从业者」等稚嫩表述)
- 联系方式
- 所在城市
- 核心链接(领英、GitHub、技术博客、Kaggle等,不超过4个)
重中之重:所有链接必须可正常访问。
个人简介
优质的个人简介能让招聘者一眼判定你的岗位适配度;但空洞、浮夸的简介,反而会大幅减分。
从业2年以上再设置个人简介板块最为合适,此时你有足够的行业经验与工作成果可以总结展示。
唯一例外:跨岗求职场景,可通过简介向招聘者铺垫过往经历,解释求职动机、衔接新旧岗位。
优质简介核心要求:
- 写明从业年限
- 量化工作成果
- 突出专业细分领域
- 杜绝空泛话术(如「热爱行业」「吃苦耐劳」「责任心强」)
- 拒绝陈词滥调、模糊笼统的表述
简介没有绝对标准答案,完全取决于你的个人背景与目标岗位。
技术技能
对于数据科学岗位,技术技能是简历筛选的第一道门槛,直接决定你的简历能否通过初筛,因此必须放在简历靠前位置。
该板块固定分为三行排版,清晰规整:
编程语言:分为精通、熟悉两个维度
- 精通:能够独立熟练开发、落地项目的编程语言
- 熟悉:有实操经验、可以上手使用,但尚未达到熟练精通的语言
技术工具:罗列实操过、可熟练运用的工具,例如AWS、Git、Docker、GCP、Linux、Bash等
工作经历
这是简历最核心、也最难打磨的板块。
先自主梳理工作经历要点,再通过 Claude 优化润色、拔高亮点。初稿质量越高,AI优化效果越出彩。
撰写工作经历初稿,严格遵循以下规则:
1. 每份工作经历最多3–5条核心描述;
2. 无需严格照搬官方岗位名称,可适度优化润色,让头衔更亮眼、更贴合岗位;
3. 只保留与目标岗位高度相关的工作内容;
4. 重点突出近期工作经历、高匹配度经历;
5. 全程使用主动行为动词,例如开发、主导、优化、产出、提升,明确体现你的主导作用;
6. 细化技术细节,大胆植入岗位核心关键词,不刻意笼统;
7. 每条经历必须搭配数据、指标,优先体现业务营收、成本等财务价值。如果难以量化,后续可以借助 Claude 梳理量化维度。
项目经历
项目经历的撰写逻辑与工作经历基本一致。区别在于:个人项目不属于企业业务,很难直接体现商业价值。
但你必须把项目经历当作正式工作经历打磨——这是应届生、转行求职者最核心的能力证明。
项目撰写核心原则:
1. 每条项目描述同样搭配量化数据与指标;
2. 附上可正常访问的项目链接;
3. 优化GitHub、个人作品集页面排版,配备清晰完整的README文档;
4. 优先补充单元测试、前端可视化面板、完整落地链路等端到端工程化能力;
5. 项目较多时,仅筛选适配目标岗位的优质项目展示。
教育背景
该板块无需复杂赘述,仅需包含:
- 院校名称、学位专业
- 绩点/成绩(成绩优异则填写,一般则省略)
- 毕业时间/预计毕业时间
遵循以上全套清单,就能产出一份高质量基础简历,后续我们将借助 Claude 完成高阶优化,冲刺顶尖水准。
Claude 简历高阶优化核心技巧
我将分享三个提升效果最显著的 Claude 简历优化用法。
一、挖掘量化财务价值
很多学员都反馈:最难的就是把日常工作和业务财务价值挂钩。
直白来说:只要你身处企业岗位,你的所有工作都会间接或直接影响公司财务数据。企业雇佣你,本质是为了通过你的工作创造收益、降低成本。
因此,所有工作内容都能关联企业核心营收指标,只需要找对挖掘思路即可,而这正是 Claude 的核心优势。
你可以直接使用以下专属提示词,引导 Claude 帮你梳理量化价值:
【专属提示词】
「粘贴你的工作/项目描述」
请按步骤协助我优化:
1. 向我提出澄清问题,明确该任务/项目的具体落地规模、使用人群、覆盖业务流程;
2. 梳理该工作可关联的企业财务指标,例如成本节约、营收增长、耗时缩减、风险误差降低、用户留存提升、效率优化等;
3. 针对每一项财务指标,告诉我需要搜集哪些具体数据、计算公式(例如「单周节省工时 × 岗位时薪」「误差降低比例 × 单次误差平均成本」);
4. 告知我获取这些数据的可行渠道,例如个人项目记录、团队数据看板、直属领导、财务/运营团队等;
5. 待我提供具体数据后,帮我按照「执行动作 → 落地方法 → 量化成果」的结构重写工作描述。
禁止自行编造、预估数据,仅协助我梳理数据搜集方向与改写逻辑。
我举个实操例子:
原始简历描述:
搭建多组CatBoost风险定价预测模型,基于Databricks、MLflow构建自动化建模流水线,通过贝叶斯超参优化(Hyperopt)完成模型训练优化。
Claude 优化改写版本:
基于Databricks、MLflow搭建自动化CatBoost风险定价建模流水线,依托贝叶斯超参优化完成模型迭代,将单轮模型重训耗时从【X小时】压缩至【Y小时】,定价准确率提升【X】%,助力企业风险损失率优化【X】%。
二、简历精准删减与岗位定制
很多人会用 Claude 直接改写适配岗位的简历,但这种方式容易让AI编造虚假经历。
更稳妥、高效的方式:让AI基于你的全能主简历,删除无关冗余内容,精简为单页专属简历。
这件事你自己也能做,但AI的筛选标准更严苛、更贴合岗位需求,删减更精准。
三、适配ATS系统与岗位描述
这是独家高阶技巧:不是简单堆砌关键词,而是统一简历与岗位描述的专业话术体系。
让 Claude 对比你的简历文案与目标岗位JD,精准标注同义不同词的表述差异(例如你写「预测模型」,岗位要求「预测分析」),统一话术风格。
绝大多数ATS筛选系统和招聘者,都会优先匹配精准一致的专业术语。
岗位JD示例(电商/零售高级数据科学家):
我们招募高级数据科学家,主导供应链全链路预测分析项目,搭建需求预测机器学习流水线,落地MLOps最佳实践,向业务方同步工作价值与业务成果。需具备AWS/GCP/Azure云平台使用经验、熟练掌握模型超参优化。
原始简历描述:
基于LightGBM搭建全新菜品热度预测模型,将5日预测准确率提升33%,通过AWS Lambda与Step Functions完成算法部署上线。
Claude 优化后版本:
基于LightGBM搭建供应链菜品需求预测分析模型,将5日需求预测准确率提升33%,每年为企业减少50万英镑食材浪费成本;依托AWS Lambda与Step Functions完成模型部署,落地自动化MLOps流水线。
这些优化看似细微,但每一处1%的精准提升叠加,都会让你的简历在众多求职者中脱颖而出。
严格落实本文所有基础框架搭建+Claude高阶优化技巧,你的简历足以跻身行业前1%顶尖水准。
但仅凭优质简历,不足以拿下20万+年薪的机器学习高薪岗位,你还需要掌握人脉拓展、全流程面试技巧。
我们后续再见!
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802022788号






