


 发帖

 雷达卡



今天想跟大家聊聊Zyphra刚开源的超强小参数模型ZAYA1-8B。这小玩意说实话有点意思,还是用AMD芯片训练的。
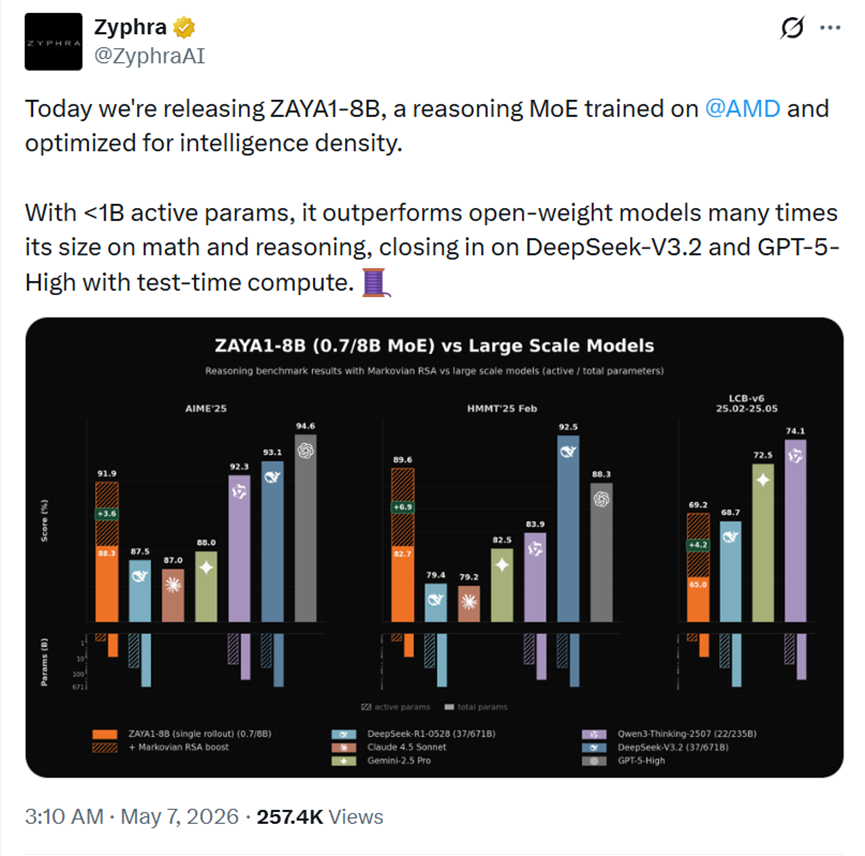
咱们平时看大模型新闻,总感觉参数量不上百亿就不叫模型。ZAYA1-8B是个混合专家架构的模型,真正干活的时候激活参数还不到10亿。
开源地址:https://huggingface.co/Zyphra/ZAYA1-8B
但就这点体量,跑起数学和写代码的活来,居然能反超那些参数量比自己大几十倍的大家伙。
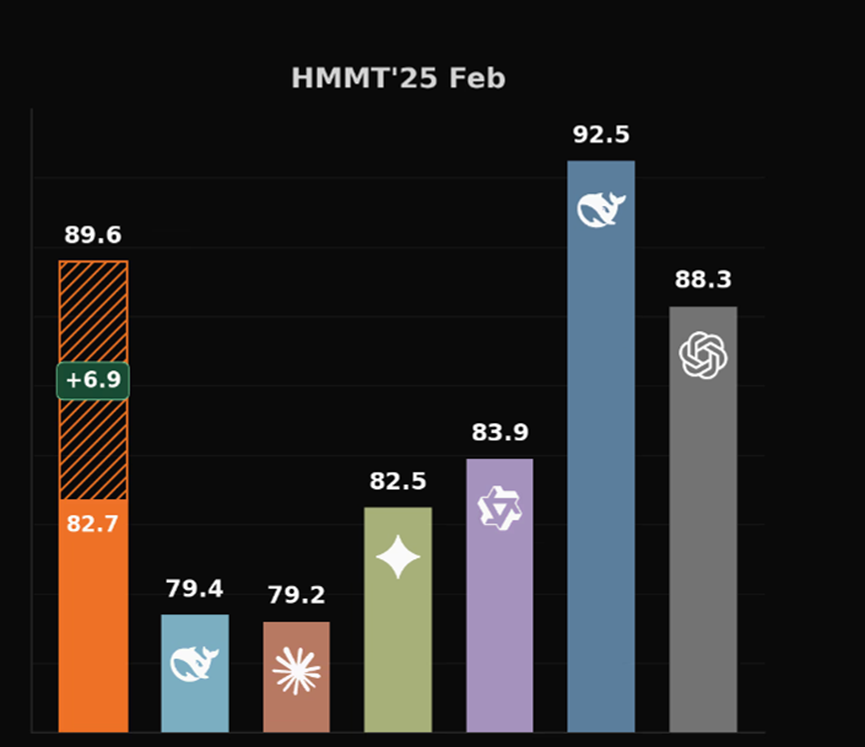
例如,在HMMT这个挺难的数学比赛数据集上,分数直接干到了89.6,硬生生超过了GPT-5的高配版和Claude4.5 Sonnet这些著名闭源模型。
这么小的参数性能还这么强,主要是因为Zyphra在设计上死磕了一个点,就是每一分算力每一颗参数都得榨干它的智商。
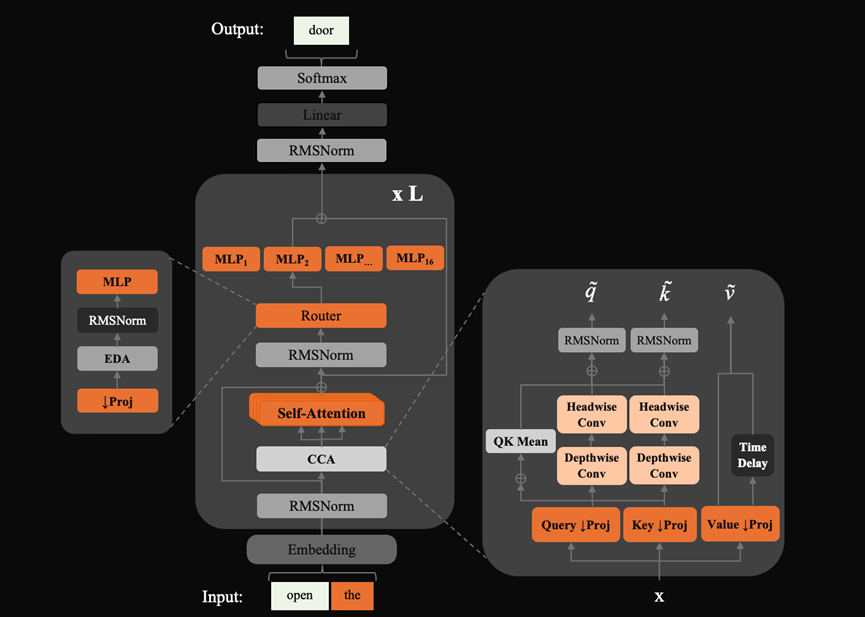
他们弄了三个挺巧妙的改动,一个是CCA的注意力机制。简单理解就是给模型装了个“过滤器”,把没用的信息过滤掉只保留精华。
再加上它那个混合专家架构,就像是组建了一个AI专家团队,遇到数学题就叫数学专家,遇到写代码就叫程序员专家,各司其职推理效率自然高效。
接着他们把选专家的路由器从以前那种简单的直线判断换成了一个小型的多层感知机网络,这样模型在挑谁来干活的时候就不会手忙脚乱出岔子。
还加了个可以自己学习的残差缩放开关,花极小的代价就把模型太深导致的数值发散问题给治住了。这三板斧一下来,整个模型的底子就变得特别精干。
说说它的出身,这点可能很多非硬核玩家不知道,但真的很有意义。以前咱们训练这种级别的模型,基本都得抱英伟达的大腿。
毕竟显卡就那几家强。但Zaya1-8B是个异类,它是完全在AMD的硬件上跑出来的。
用了1024张AMD的MI300X显卡,硬是把这个大家伙给练成了。这也说明AMD现在的AI生态也是好起来了。
以后咱们搞AI训练,又多了一个选择。这对咱们用户来说绝对是好事,毕竟有竞争才有性价比嘛。
不过真正让这个模型脱胎换骨的,其实是他们后面那套极其繁琐但也极其管用的后训练流程。
一共分了五步,每一步都在给模型开小灶。一开始先教它最基础的聊天和听指令,接着就开始给它喂逻辑题,让它学会自己把几个候选答案糅合在一起。
到第三步和第四步就有点像体育生做魔鬼体能训练了,通过强化学习不断动态调整题目的难度,死磕数学和代码这两个硬核领域。
等这几步折腾完,最后再稍微用人类反馈给它整整仪容仪表,比如说话好不好听、写文章有没有风格之类的。
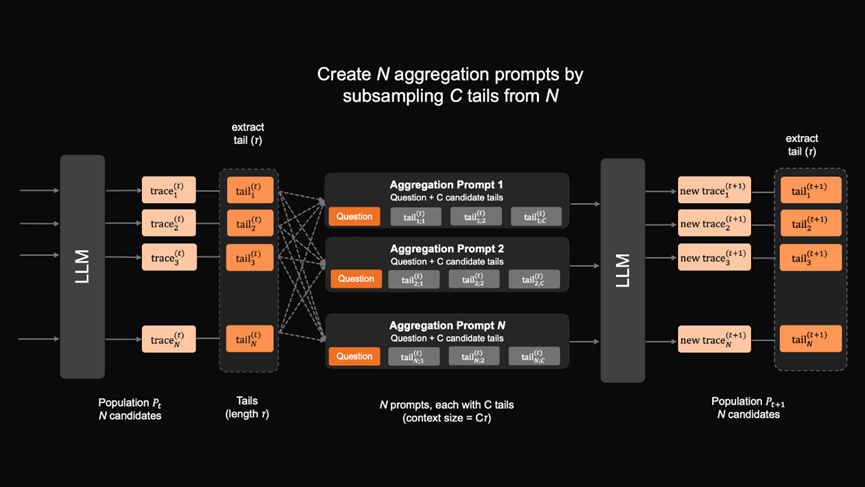
这五步走完之后效果非常明显,数学和代码能力直接飙升,连带着做选择题和写小作文也跟着涨分。
说真的这次Zaya1-8B是真的给小参数模型争了口气。模型强不强不能光看参数,还得看架构和能耗。
对于咱们这些想在本地跑个高性能模型,或者对成本比较敏感的朋友来说,是个值得尝试的新选择。
目前,ZAYA1-8B已经开源了并且支持Apache2.0协议协议,也就是说咱们可以直接商业化使用,开发个移动端连线助手啥的都没问题。
想系统掌握AI核心技能、获取行业认可资质?
CAIE注册人工智能工程师认证
助你拓宽职业赛道,成为AI领域持证实力派

企业、高校及渠道合作
请联系微信:FYLlaoshi

 京公网安备 11010802022788号






